04|“黑箱”揭秘:Transformer架构与文本生成机制
你好,我是袁从德。
前三讲,我们完成了从宏观全景图到具体场景落地的完整跃迁:我们理解了大模型应用的本质特征,选择了情感聊天这一高价值、低门槛的切入点,并亲手搭建了一个具备记忆、人格和安全机制的AI陪伴机器人。你已超越只会调用 API的初学者阶段,开始思考如何设计、优化并扩展一个真正的 AI 系统。
然而,如果你希望在大模型时代成为系统架构师,而非“工具使用者”的开发者,仅仅停留在会用的阶段是远远不够的。
试想一下:当你面对生成内容偏离预期、响应速度缓慢、上下文理解混乱等问题时,你是只能反复调整提示词碰运气,还是能够深入分析其背后的原因——是模型注意力机制未能捕捉关键信息?是位置编码导致长文本失效?还是解码策略引入了不必要的随机性?
答案显而易见。真正的掌控力,来自于对底层逻辑的理解。
这正是这一讲的核心使命:带你穿透大模型的“黑箱”,走进其最核心的神经网络架构——Transformer,并揭示它如何实现令人惊叹的文本生成能力。我们将不依赖复杂的数学推导,而是以直观类比 + 图解思维 + 工程视角,为你拆解这一支撑ChatGPT、通义千问、Llama等所有主流大模型的技术基石。
你不需要是深度学习专家,但学完本章后,你将能达成这几个目标。
清晰说出“Transformer为何比RNN更适配大模型”。
理解注意力机制如何让模型聚焦重点。
解释自回归生成为何导致逐字输出缓慢。
判断何时该用贪婪搜索,何时该用采样策略。
在后续开发中,更有针对性地优化提示设计、上下文长度、推理性能等关键环节。
让我们从一个简单的问题开始:当你说“请写一首关于秋天的诗”,大模型是如何一步步生成那行优美文字的?
答案并非魔法,而在于其精巧的结构。现在,就让我们揭开这层神秘面纱。
一、从RNN到Transformer:一场架构革命
万丈高楼平地起,Transformer技术并非朝夕之功。在深入探究Transformer之前,有必要回溯基于神经网络的语言模型的发展轨迹,明晰其演变过程中的关键节点,同时梳理Transformer得以构建的一些核心基础理论与技术,为透彻理解Transformer的诞生背景与创新之处筑牢根基。
1.1 循环神经网络
在Transformer诞生之前,业界主流的语言模型主要是RNN(Recurrent Neural Networks,循环神经网络)及其变体,如LSTM(Long Short Term Memory,长短期记忆网络)和GRU(Gated Recurrent Unit,门控循环单元)。RNN 的雏形可追溯至 20 世纪 90 年代 Jeffrey L. Elman 的经典论文《Finding Structure in Time》。
RNN的核心思想,是通过循环连接建模序列数据的时序依赖。如图4‑1所示,RNN在每个时间步接收当前输入与前一时间步的隐状态,经计算后输出当前隐状态与结果。其中,隐状态本质是对历史信息的编码向量,用于捕捉序列中的时间上下文关联。
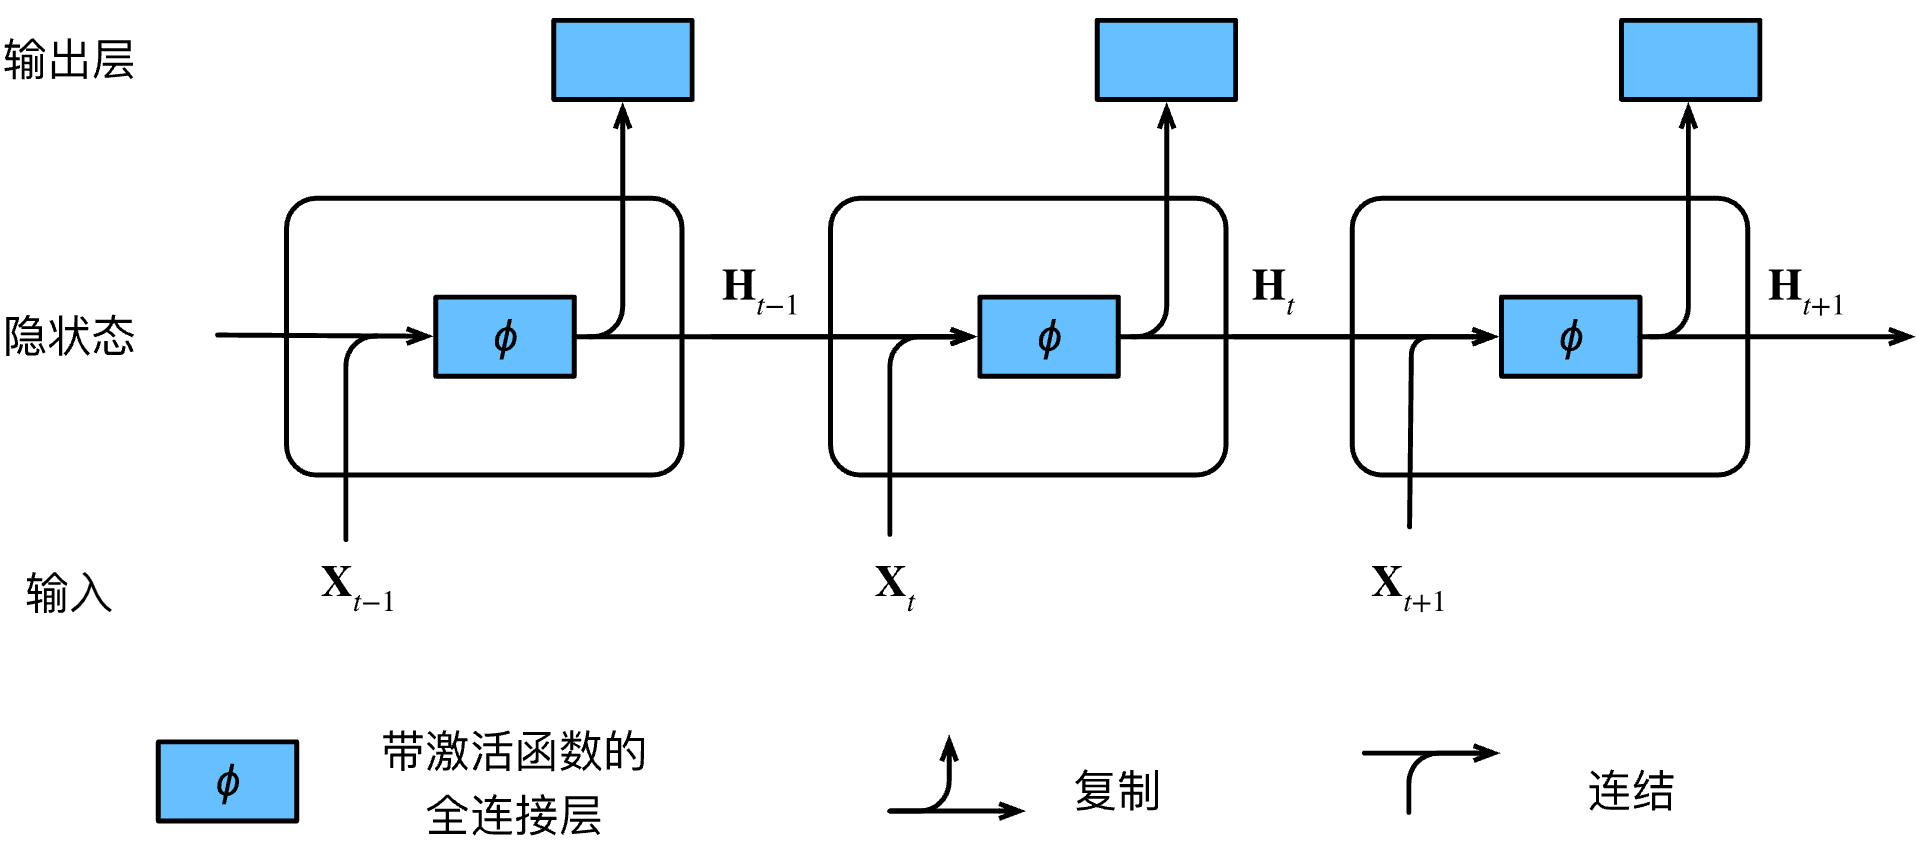
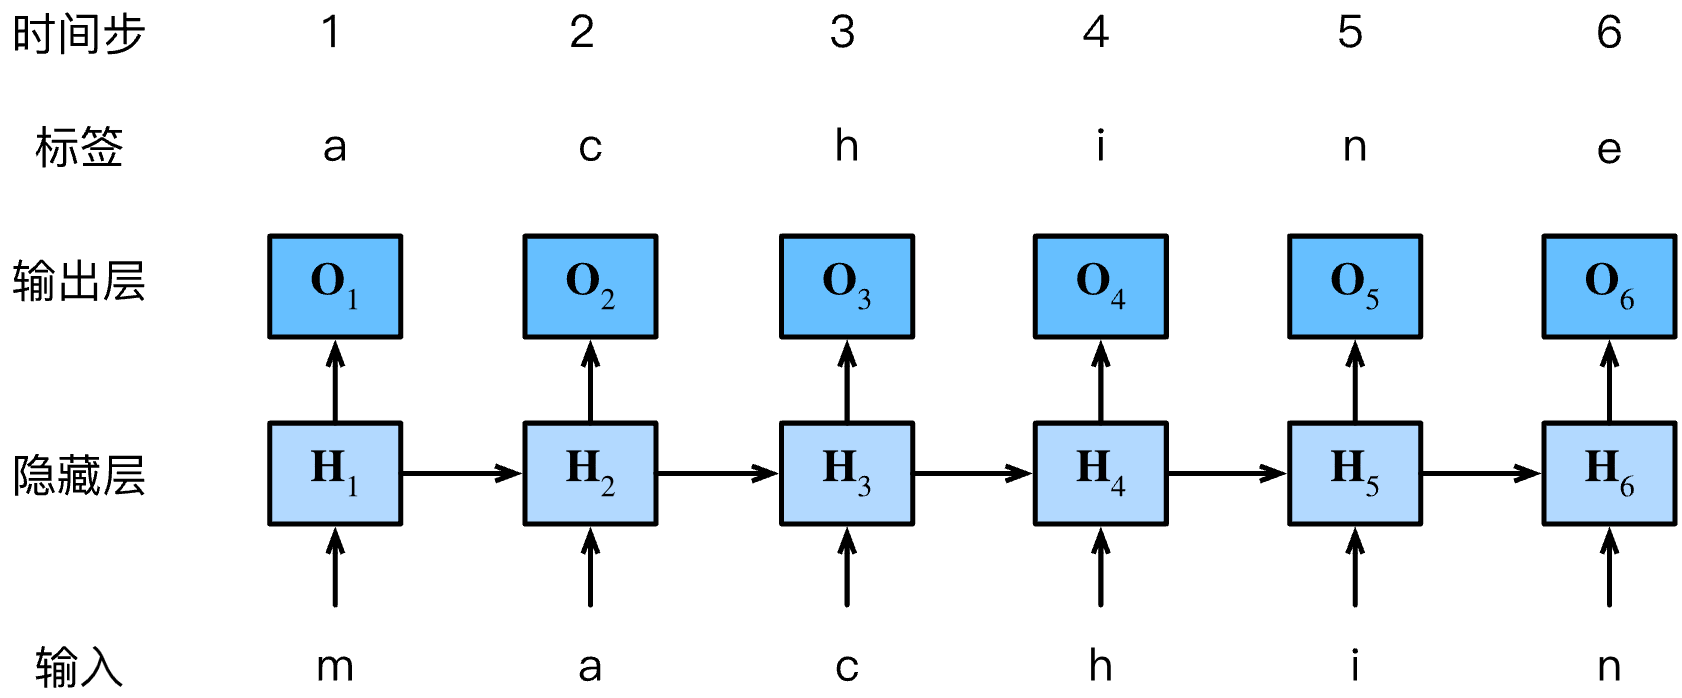
图4‑2是基于RNN的字符级语言模型的输入输出示意,每输入一个字符,模型就会预测下一个字符。
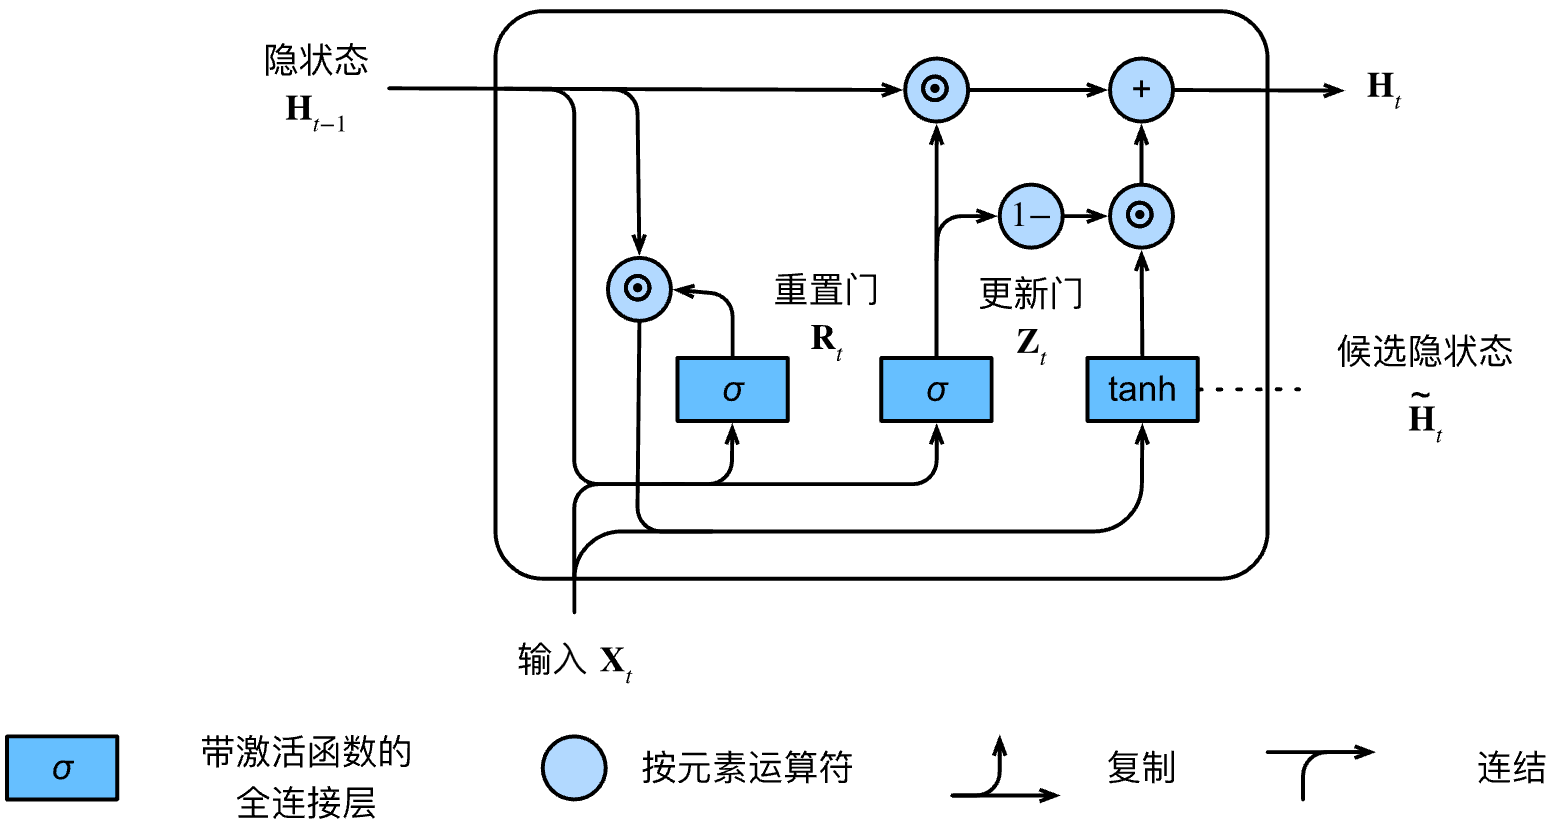
另外一种RNN的变体是GRU,GRU借鉴了LSTM的经验,如图4-3所示,将门控机制简化为两个——重置门和更新门,减少了参数数量和计算复杂度,同时在许多任务中仍能保持与LSTM相近的性能。
在Transformer出现之前,处理语言任务的主流模型是循环神经网络(RNN)及其变体LSTM/GRU。它们像一位逐字阅读的学生,每读一个词更新一次记忆,理论上可以记住前面所有内容。
1.2 编解码架构
但问题也随之而来:
顺序依赖:必须按顺序处理每个词,无法并行计算,训练极慢。
长程遗忘:超过几十个词后,早期信息几乎完全丢失。
难以捕捉远距离依赖:比如句子开头的主语和结尾的谓语之间关系微弱。
举个例子:“虽然他昨天没睡好,但他今天精神很好。”RNN很难把“他”和“精神很好”关联起来,因为中间隔了太多信息。
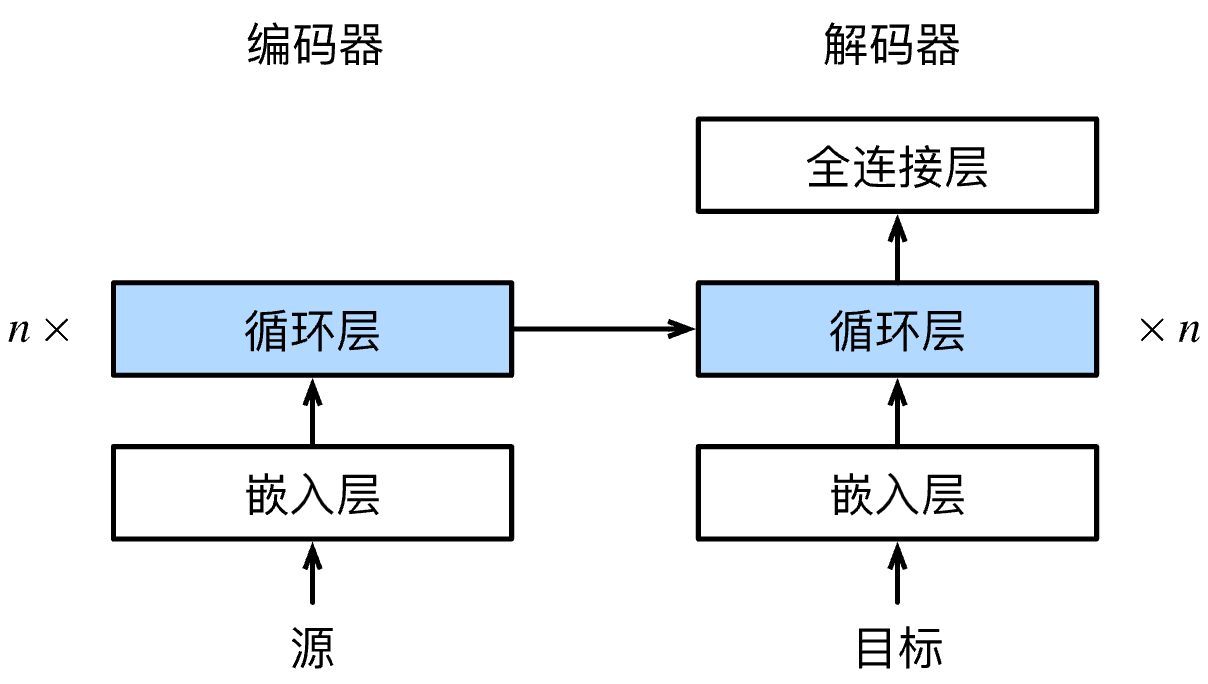
编码-解码(Encoder-Decoder)架构来自论文《Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation》。论文提出了一种新的神经网络架构,如图4-4所示,包括一个编码器(Encoder)和一个解码器(Decoder),用于将源语言编码为固定长度的向量表示(包含语义和上下文信息),并从该向量表示解码成目标语言。
2017年,Google在论文《Attention Is All You Need》中提出了Transformer架构,彻底改变了这一局面。它的核心思想是:抛弃循环结构,完全依靠“注意力机制”来建模词与词之间的关系。
如图4-5所示,Transformer架构摒弃了RNN的顺序结构,这虽然带来诸多优势,但也使其面临一个关键问题:如何捕捉序列中的位置信息。为解决这一问题,Transformer在嵌入层之后引入了位置编码。
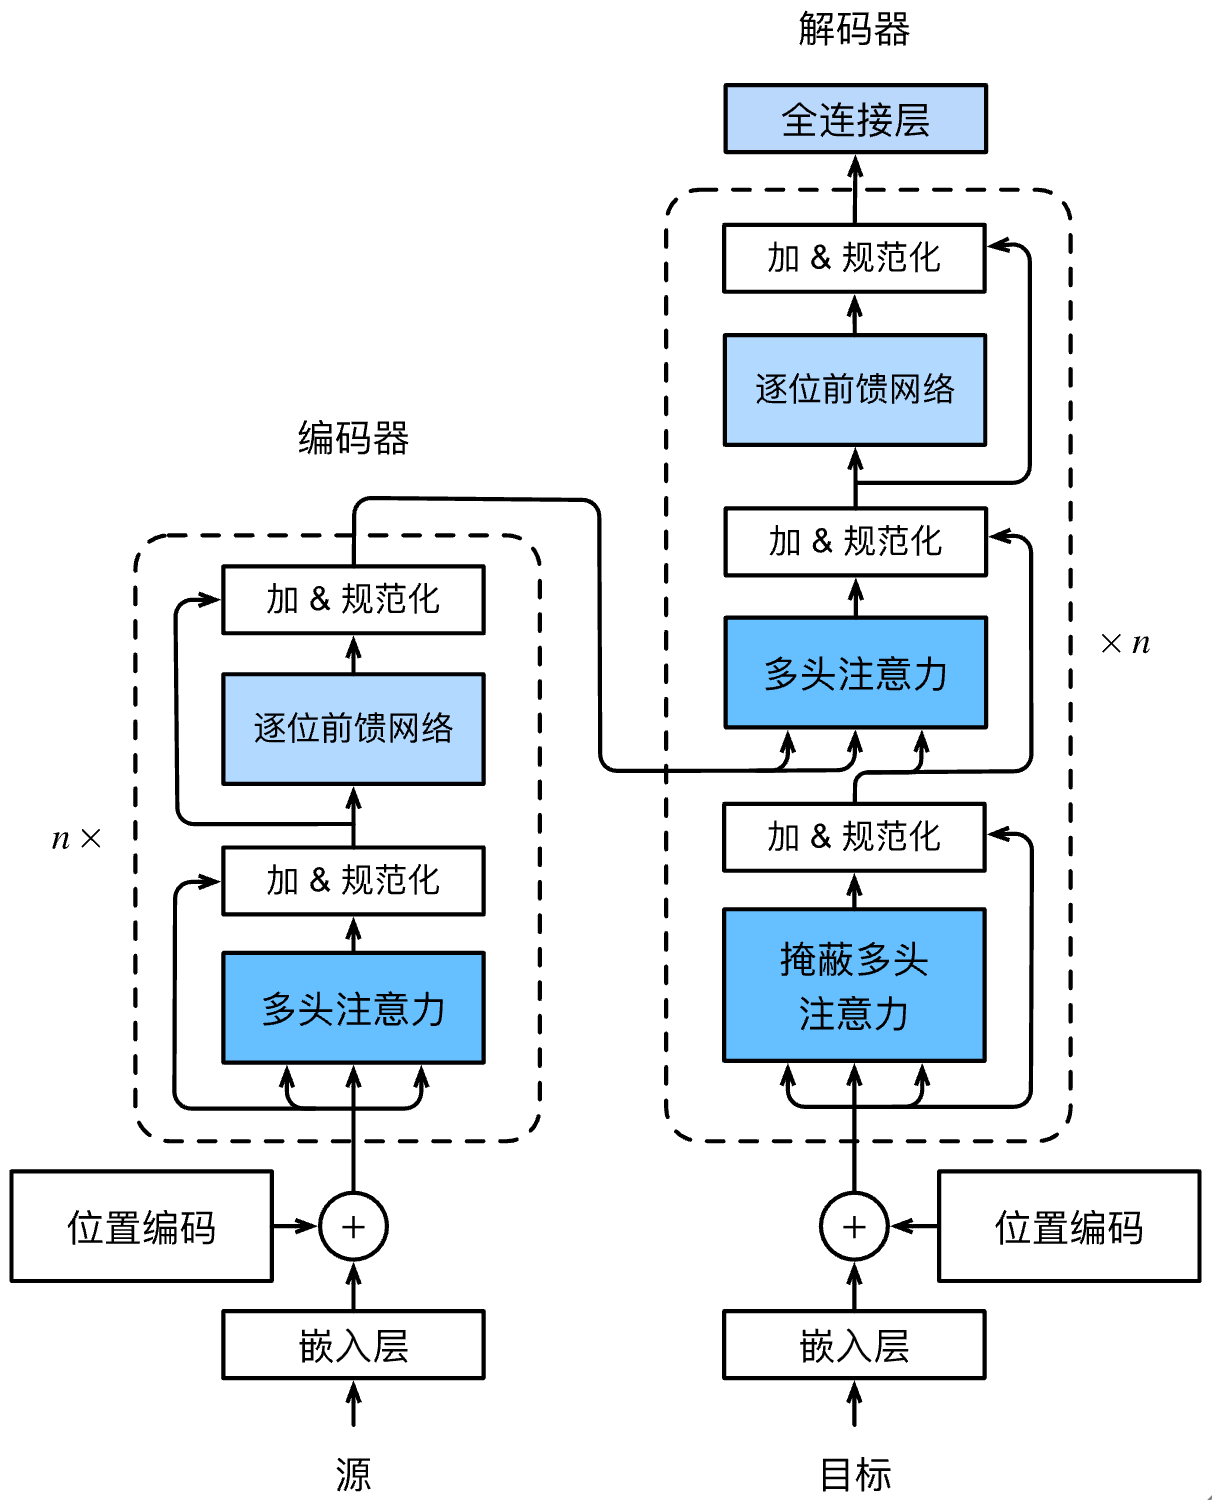
编码器与解码器的核心组件是多头自注意力机制(Multi-Head Self-Attention)。其中,自注意力机制让序列中每个位置的表示,都能够直接聚焦于其他所有位置的信息,极大提升了信息交互效率。而多头注意力机制更进一步,通过并行运算多个注意力头(每个头独立计算各自的注意力输出),得以捕捉输入序列中不同位置间丰富多样的依赖关系,从而全面且深入地挖掘序列数据中的关键信息。
这一创新带来了三大飞跃:
并行化训练:所有词可同时输入,极大提升训练效率。
全局依赖建模:任意两个词之间都能直接建立联系,无论相隔多远。
可扩展性强:易于堆叠多层,支撑千亿参数模型。
可以说,没有Transformer,就没有今天的AI大模型浪潮。
二、Transformer 架构全景图:编码器-解码器结构解析
Transformer整体采用“编码器-解码器(Encoder-Decoder)”结构,如图4-6所示。
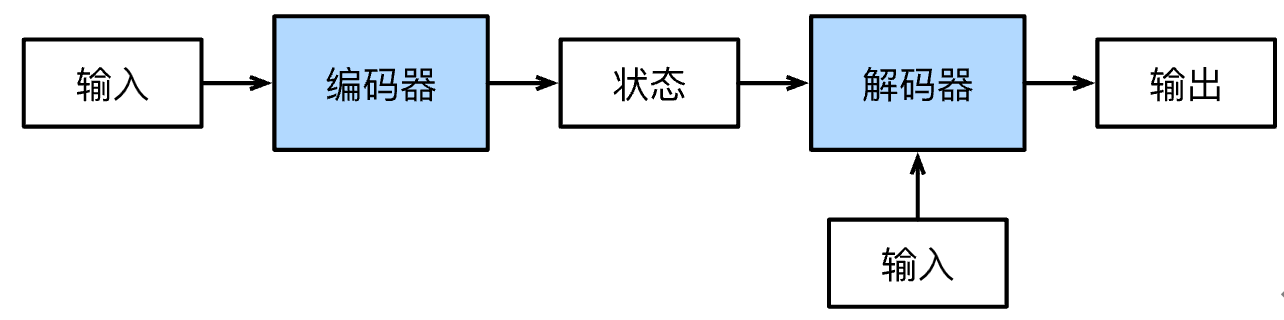
以机器翻译为例,Encoder(编码器)负责理解输入句子(例如“Hello, world!”),提取语义特征。Decoder(解码器)则负责根据编码结果,逐词生成目标语言(翻译为“你好,世界!”)。
注意:像ChatGPT这样的对话模型,实际上只使用了Decoder部分(称为Decoder-only架构),因为它不需要“翻译”或“编码”输入,而是直接基于上下文预测下一个词。
下面我们分模块深入解析。
2.1 输入表示:词是如何被“数字化”的?
模型无法直接处理文字,必须将其转化为向量。这个过程分为三步。
第一步,Tokenization(分词)
首先,将句子切分成基本单元(token)。
例如:“我喜欢学习AI。”→ 分词结果:[“我”, “喜欢”, “学习”, “AI”, “。”]
每个token会被映射到一个唯一的ID,如“AI”→1024。
第二步,词嵌入(Word Embedding)
每个token ID通过查表转换为一个高维向量(如768维),这个向量蕴含语义信息。例如,“国王”和“王后”的向量距离较近。
第三步,位置编码(Positional Encoding)
由于Transformer没有顺序处理机制,必须显式告诉模型“这个词在第几位”。于是引入位置编码——一种基于正弦函数的固定模式,加到词向量上,使模型能感知词序。
举个生活化比喻:
想象你在听一场脱口秀,演员说了10句话。如果这些话被打乱播放,你会完全看不懂笑点。位置编码就像给每句话贴上时间戳,让模型知道“哪句先说,哪句后说”。
2.2 核心引擎:自注意力机制
这是Transformer最革命性的设计,也是大模型理解上下文的关键。
2.2.1 什么是自注意力?
自注意力机制(Self-Attention)是一种让每个词根据上下文来动态调整它的自身表示(即向量)的机制。即对于每个词,会根据与上下文其他词的相关性来重新计算,以得到新的向量表示。
这样能帮助神经网络模型更好地捕捉到词与词之间的动态紧密关系,从而实现更准确的预测输出。简单说,就是让句子中的每个词去关注其他所有词,并根据相关性分配“注意力权重”。
比如句子:“猫坐在垫子上,它很舒服。”当模型处理“它”时,会自动计算它与“猫”“垫子”“舒服”等词的相关性,发现“它”最可能指代“猫”,于是给予“猫”更高的注意力权重。
2.2.2 自注意力如何工作?(三步走)
我们可以用“查询-键-值”(Query-Key-Value)框架来理解,如图4-7所示,具体如下。
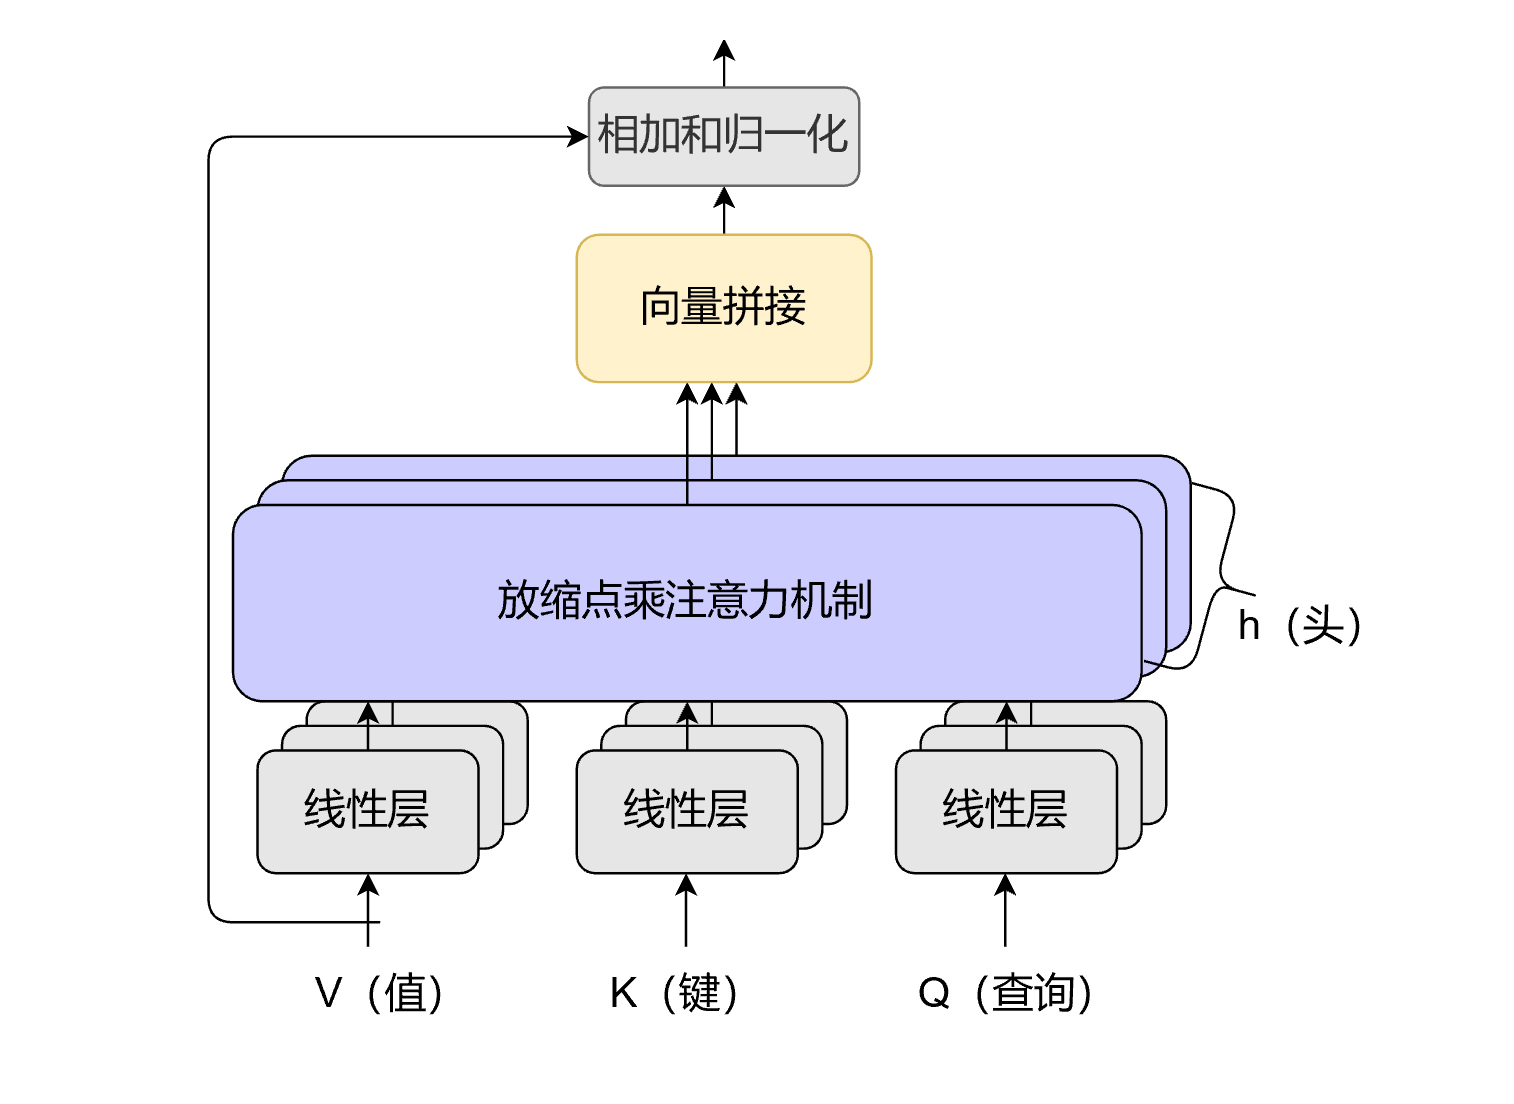
生成Q、K、V向量。每个词的向量分别乘以三个不同的权重矩阵,得到:
Query(查询):我想找什么?
Key(键):我代表什么?
Value(值):我提供什么信息?
计算注意力分数。用Query与所有Key做点积,得到匹配度(分数),再通过Softmax归一化为概率分布。
加权求和Value。用上述权重对所有Value加权求和,得到该词的新表示——这个新向量融合了上下文中最相关的信息。
类比:
你在会议室听五个人发言。你想理解“这个项目”的进展,于是你:
对每个人的发言内容打分(谁提到了关键信息?)
给讲得最相关的同事更高权重
综合他们的观点形成自己的理解
这就是自注意力的过程。
多头注意力(Multi-Head Attention),为了捕捉不同类型的依赖关系(如语法、语义、指代等),Transformer会并行运行多个注意力头,最后将结果拼接。就像你同时从“技术视角”“商业视角”“用户视角”理解一个问题。
2.2.3 前馈神经网络与残差连接
在每个注意力层之后,还有一个前馈神经网络(FFN),负责进一步非线性变换,增强模型表达能力。
残差网络(简称ResNet)是深度学习模型中的一种,于2015年由微软的何凯明提出。如图4-8所示,其核心在于让网络的每一层不直接学习预期的输出,而是学习与输入之间的残差关系,这一设计使得拥有几十上百层的深度学习模型更加容易训练,增加模型深度的同时还能保持甚至提高准确度。
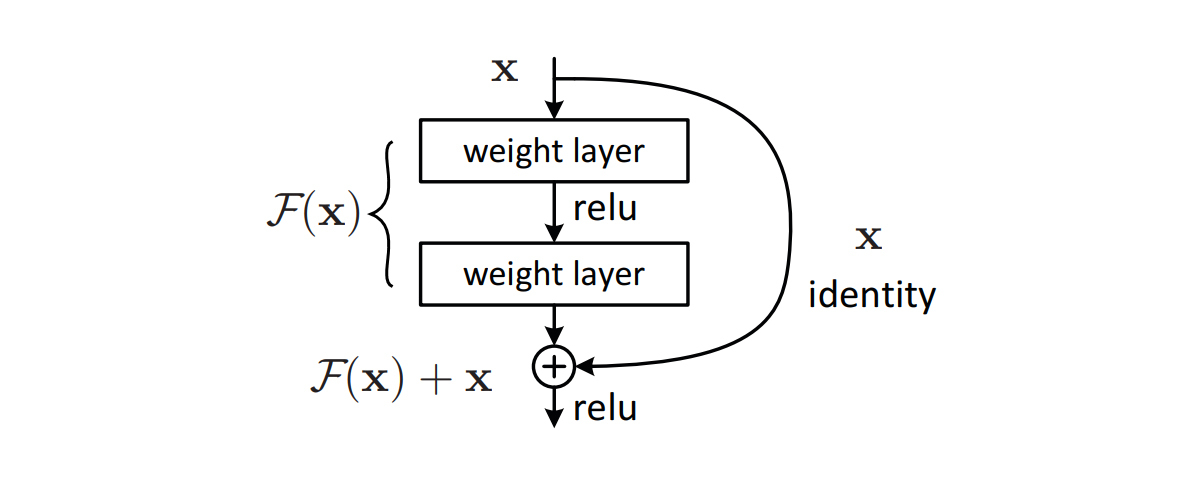
此外,Transformer大量使用残差连接(Residual Connection) 和层归一化(Layer Normalization),防止深层网络训练崩溃。
小知识:GPT-3有96层Transformer块,如果没有残差连接,根本无法训练。
2.2.4 解码器的独特设计:掩码自注意力
在自注意力机制中,掩码(Mask)的作用是确保模型在处理序列数据时,只关注到当前位置之前的元素,而不能看到当前位置之后的元素。这种机制对于保持模型的合理性和预测的准确性至关重要。
解码器也有自注意力层,但它必须遵守一个规则:在生成第t个词时,只能看到前t-1个词,不能偷看未来。为此,Transformer在解码器的自注意力中加入了掩码(Masking)——将未来的词屏蔽掉,确保生成过程是自回归的。
同时,解码器还有一个“编码器-解码器注意力”层,用于关注输入句子的关键信息(在对话模型中作用较小)。
三、文本生成机制:从概率到连贯语言
现在我们已经知道模型如何“理解”输入,接下来要解决的问题是:它是如何“写出”一句话的?
这个过程叫做自回归生成(Autoregressive Generation),即“一个字一个字地猜”。
3.1 生成流程
大语言模型的生成机制可以概括为以下流程:输入 (Prompt) → Tokenization (词元化) → Embeddings (向量化) → [循环处理块:Self-Attention (上下文理解) + Feed-Forward Network (信息处理)] → 输出一个概率分布 → Decoding/Sampling (选择一个词) → 将新词加入输入序列 → 重复循环。
以提示词“请写一首关于春天的诗”为例,梳理以下生成的过程。
编码上下文:模型将整个提示词输入,通过多层Transformer处理,生成一个深层语义表示。
预测第一个词:模型基于上下文,输出一个概率分布,表示接下来最可能出现的词是什么。例如:
“春风”:30%
“花开”:25%
“阳光”:20%
……
采样选词:根据某种策略(如贪婪搜索、随机采样等)选择一个词作为输出,比如选了“春风”。
循环迭代:将“春风”加入上下文,重新计算下一个词的概率分布,继续生成,直到遇到结束符(EOS)或达到长度限制。
整个过程就像“走迷宫”,每一步都会根据当前环境选择下一个出口。
3.2 解码策略:决定生成风格的关键
为了让生成内容更有创造性和多样性,我们可以在概率分布中引入随机性。这里介绍两种采样策略。
先来看Top-K 采样。在所有词元中,只考虑概率最高的 K 个,然后在这 K 个词元中按照它们的相对概率进行随机采样。优点是限制了采样范围,避免了选中那些非常不靠谱的低概率词元。
另一种策略是Top-P (Nucleus) 采样,这是一种更动态的策略。从概率最高的词元开始,不断累加它们的概率,直到总和超过一个预设的阈值 P(例如 0.95)。然后,模型只从这个概率总和超过 P 的核心词元集合(Nucleus)中进行采样。
它的优点是采样集合的大小是动态的。当模型非常确定下一个词时(例如“I love”之后很可能是“you”),这个集合会很小;当模型不确定时(在一个开放式问题的开头),集合会很大,允许更多探索。这通常被认为是效果最好的采样策略之一。
如表 4-1 所示,不同的采样策略会带来截然不同的输出风格。
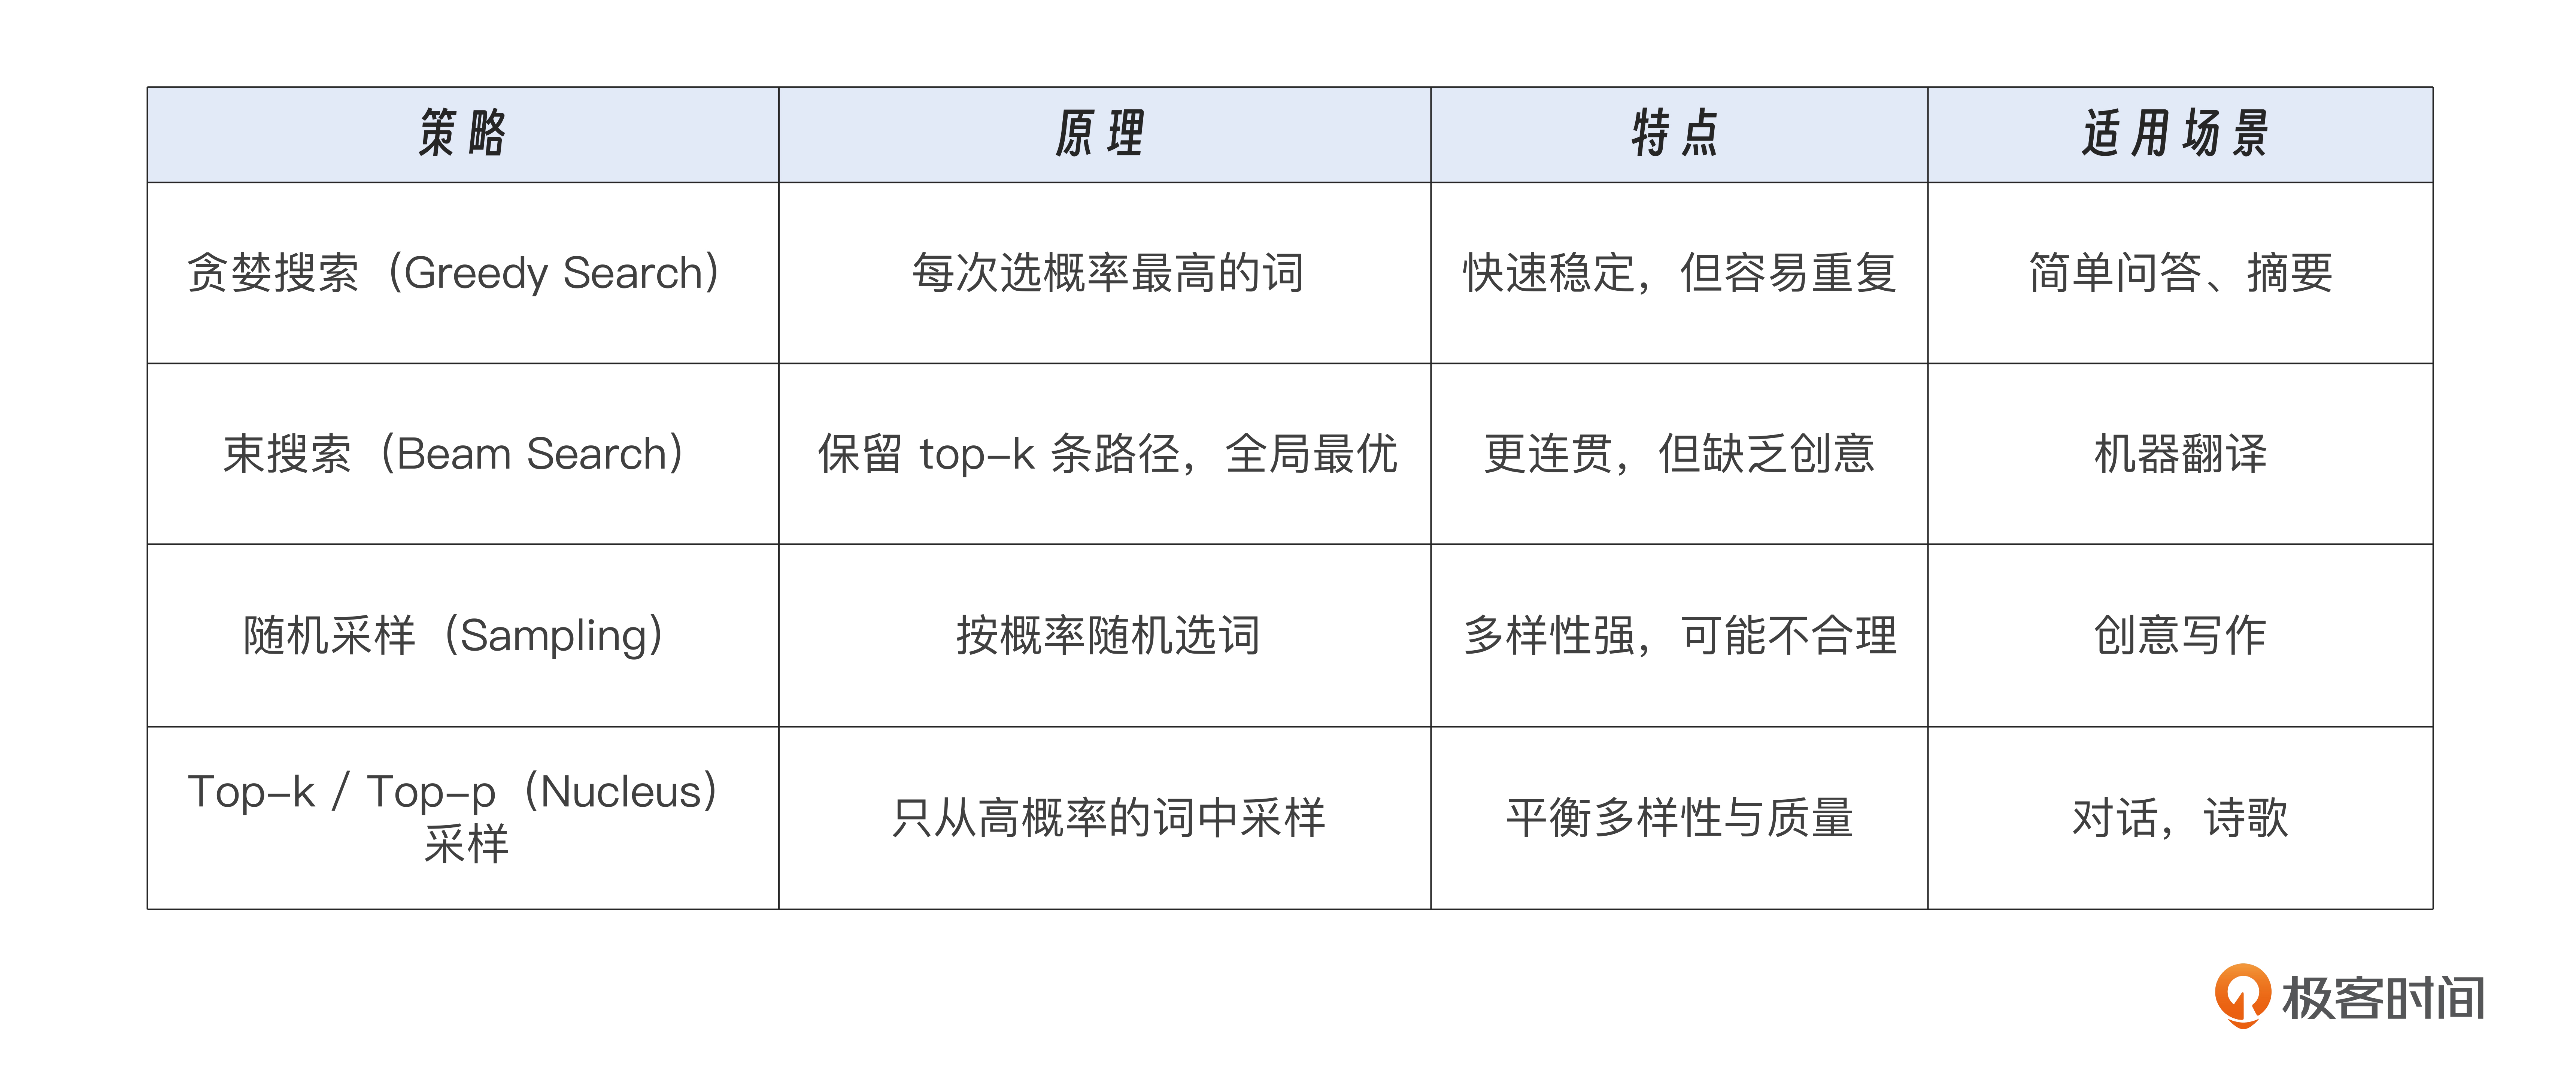
实践建议:
在情感聊天机器人中,推荐使用 Top-p(如0.9) + 温度(temperature=0.7),既能保持自然流畅,又避免过于机械或胡言乱语。
3.3 温度(Temperature)的作用
温度 (Temperature) 采样,是一个调节参数。高温(>1) 会让原始概率分布变得更平缓,使得低概率词元更容易被选中,结果更具创造性、随机性,但也可能出现更多错误和胡言乱语。低温(<1) 则让概率分布更尖锐,高概率词元更容易被选中,结果更接近贪心搜索,更保守、确定。Temperature=0 就等同于贪心搜索。
温度参数控制了输出的“随机性”程度。
低温(如0.1):模型更保守,倾向于选择最高概率词 → 输出稳定但呆板
高温(如1.5):模型更大胆,低概率词也有机会被选中 → 输出有创意但可能出错
类比:
低温 = 老教授写论文,严谨但枯燥
高温 = 诗人即兴创作,惊艳但可能跑题
四、从理论到实践:开发者如何利用这些知识?
理解Transformer和生成机制,不是为了自己从头训练一个GPT,而是为了更聪明地使用大模型。
4.1 优化提示工程
优化提示工程的首要原则是清晰、具体并提供上下文。应使用明确的动作动词直接表达需求,避免模糊指令,并详细说明输出的内容、结构、格式和质量要求。同时,解释任务的目的、受众或限制原因,有助于模型更准确地理解意图,生成贴合实际需要的响应。
进阶技巧包括使用示例、授权不确定性、引导推理过程和设定角色。通过提供一个或多个输出范例(one-shot/few-shot),可以高效传达风格或格式要求;允许模型在信息不足时承认“不知道”,可减少幻觉;加入“请一步步思考”等链式思维提示,能提升复杂任务的表现;而指定角色(如“作为心理咨询师”)则可调整语气与专业深度。
对于复杂任务,应采用多步骤拆解与结构化输出策略。将大目标分解为若干小步骤依次执行,并明确要求返回如 JSON、表格等机器可读格式,不仅提高结果质量,也便于后续处理。同时,清晰设定边界——说明哪些内容不应出现——与说明目标同样重要。
最后,提示工程是一个持续迭代的过程,需避免常见陷阱如过度复杂、隐含假设或矛盾指令。建议从简单提示开始,通过评估结果不断优化,建立有效提示库,并结合具体领域(如代码、内容、数据分析)调整策略,从而系统性提升 AI 协作效率与输出质量。
4.2 合理管理上下文
在构建基于大语言模型的智能体或对话系统时,上下文管理已成为决定性能与可靠性的关键环节。尽管现代模型支持数十万甚至百万 token 的上下文窗口,但“注意力预算”有限、长上下文检索能力衰减、计算成本高昂等问题依然存在。因此,如何在有限资源下高效组织和利用上下文信息,成为上下文工程(Context Engineering)的核心课题。
4.2.1 上下文裁剪:精准舍弃冗余信息
当对话历史或输入文本逼近模型 token 上限时,最直接的方法是裁剪(Truncation)。然而,简单地截断开头或结尾往往会导致关键信息丢失。
优化做法包括以下几种。
优先保留最近几轮交互(通常包含最新意图)。
识别并保留包含任务目标、约束条件或用户身份的关键语句。
避免删除工具调用结果或错误反馈等对后续决策至关重要的内容。
裁剪不是粗暴删除,而是在“保真”与“精简”之间寻找平衡点。
4.2.2 滑动窗口:动态维护近期上下文
滑动窗口策略通过维护一个固定长度的上下文“窗口”,随对话推进不断更新内容。这种方法特别适用于实时对话场景。
典型实现:
仅保留最近 N 轮对话(如最后5轮)。
结合时间戳或对话轮次编号,确保逻辑连贯性。
局限与应对:
可能丢失早期设定的目标(如“帮我写一篇关于气候变化的科普文章”)。
建议将初始任务描述单独缓存,并在每轮提示中显式重申。
滑动窗口虽简单,但需辅以任务锚点机制,防止“记忆漂移”。
4.2.3 摘要压缩:用高密度信息替代原始记录
当上下文过长时,可引入 摘要压缩(Summarization) 技术,将多轮对话或长文档提炼为简洁语义表示。
应用场景示例如下。
将10轮客服对话总结为:“用户反馈订单#12345未收到,要求加急处理,偏好电话联系。”
在代码 Agent 中,将之前的调试过程压缩为:“已尝试方案A失败,错误为Timeout;当前聚焦于优化数据库连接池。”
实施建议:
使用专门的压缩提示词,要求模型保留决策依据、未解决问题和关键结论。
先追求高召回率(不漏信息),再迭代提升准确性(去冗余)。
压缩后的新上下文应作为“记忆锚点”,与最新交互共同构成完整状态。
摘要压缩本质上是一种有损但可控的信息编码,是突破上下文窗口限制的第一道防线。
4.2.4 关键信息提取:结构化存储核心要素
相比全文保留,更高效的方式是从上下文中提取结构化关键信息,如实体、意图、偏好、状态变量等。
实现路径包括这样几种。
利用命名实体识别(NER)或小模型抽取时间、地点、人物、金额等。
将用户偏好(如“只看经济舱”“避免周末出行”)存入外部状态变量。
在每次调用 LLM 前,将这些结构化数据注入系统提示词。
这样做的优势是,极大节省 token 消耗,提升模型对约束条件的理解一致性,而且容易与业务系统集成(如 CRM、订单系统)。
这种“语义蒸馏”策略,让上下文从“文本堆砌”走向“知识驱动”。
4.3.5 分层记忆机制:短期+长期协同工作
为支持长时间、多阶段任务(如代码重构、研究报告撰写),需构建分层记忆架构。
短期记忆:当前会话的上下文,直接放入 prompt。
长期记忆:通过向量数据库或文件系统持久化存储的历史笔记、用户画像、项目进展等。
典型模式:
Agent 定期生成 NOTES.md 文件,记录待办事项、架构决策或实验结果。
下次启动时,通过检索相关笔记重新加载上下文。
支持“渐进式信息披露”——Agent 按需查询记忆,而非一次性加载全部。
Anthropic 的 Claude Code 即采用此类策略。它不加载整个代码库,而是通过 grep、head 等工具动态检索所需文件,并将关键结论写入笔记供后续使用。
分层记忆不仅突破了 token 限制,更模拟了人类“按需回忆”的认知机制。
无论是裁剪、摘要、提取还是分层记忆,所有策略都指向同一个核心原则:在有限的注意力预算内,最大化上下文的信息密度与相关性。随着模型能力增强,未来 Agent 或将更自主地管理上下文——自动判断何时压缩、何时检索、何时遗忘。但在当下,深思熟虑的上下文工程仍是构建可靠、高效、可扩展 AI 系统的基石。开发者应视上下文为一种战略资源,而非无限容器。唯有如此,才能让大模型在复杂任务中真正“记得住、想得清、做得对”。
4.3 调优生成参数
客服机器人:通过低温度 + 贪婪搜索 确保准确性和一致性。
创意助手:利用高温度 + Top-p采样组合来激发灵感。
教育陪练:利用中等温度 + Beam Search的组合平衡规范与引导。
4.4 诊断生成问题
在使用大语言模型用户常常会遇到两类典型问题:输出重复和内容偏离主题。这些问题不仅影响生成文本的质量,还可能降低模型在实际应用中的可靠性。我们将深入分析这两类问题的成因,并提供针对性的优化建议。
4.4.1 输出重复:注意力分散或解码策略不当
当模型生成的文本出现连续重复的短语、句子甚至段落时,通常反映出以下两种潜在原因。
第一,注意力机制失效或分散。在长序列生成过程中,模型可能未能有效聚焦于关键上下文信息,导致反复回溯并复述已有内容。
第二,解码策略参数设置不合理。例如,在使用采样(sampling)方法时,若“温度”(temperature)参数过低,模型倾向于选择高概率词,缺乏探索能力;若同时缺乏重复惩罚机制,就容易在局部高概率路径上反复循环,导致输出重复。
优化建议:
降低温度参数:将 temperature 值调低(如从 1.0 降至 0.7 或更低),可使模型输出更加确定性和连贯,减少随机跳跃带来的重复。
启用重复惩罚机制:大多数现代推理框架支持如 repetition_penalty 或 no_repeat_ngram_size 等参数。启用这些功能可有效阻止模型重复生成相同 n-gram 片段。
结合束搜索(beam search)与惩罚策略:在需要高质量输出的场景中,可采用带重复惩罚的束搜索,平衡多样性与一致性。
4.4.2 内容偏离主题:上下文过载或关键信息未被关注
当生成内容逐渐偏离原始话题,甚至引入无关信息时,往往说明模型未能准确捕捉用户意图或上下文重点。
常见诱因包括:
输入上下文过长:随着上下文长度增加,模型注意力可能被稀释,难以识别核心指令或关键实体。
提示结构不清晰:模糊、冗长或缺乏明确目标的提示(prompt)会使模型难以聚焦,从而自由发挥导致跑题。
优化建议:
重构提示语:采用“角色+任务+约束”结构化提示方式,例如:“你是一位科技记者,请用300字总结量子计算的最新进展,避免提及历史背景。”
缩短或分段输入:对于超长对话或文档摘要任务,可将上下文切分为逻辑段落,分步引导模型生成,避免一次性输入过多信息。
显式强调关键信息:在提示中使用加粗、引号或重复关键词等方式,突出核心主题,帮助模型锚定焦点。
大语言模型虽强大,但其生成质量高度依赖于输入设计与解码配置。面对重复或偏题等常见问题,用户不应仅视为模型缺陷,而应将其视为人机协作中的调优契机。通过合理调整解码参数、优化提示工程,我们能够显著提升生成内容的相关性、连贯性与实用性,充分发挥大模型的潜力。
五、结语:掌握底层逻辑,才能驾驭AI浪潮
我们刚刚完成了一次深入大模型“大脑”的旅程。从Transformer的诞生背景到其核心组件——词嵌入、位置编码、自注意力、多头机制、解码策略——我们一步步揭开了大语言模型如何理解语言、生成文本的神秘面纱。
更重要的是,我们始终站在开发者视角,强调这些知识如何反哺实际应用:
Transformer的并行性支撑了大规模预训练,成就了今天的智能飞跃;
自注意力机制让模型具备上下文感知能力,是RAG和Agent系统的基石;
自回归生成 + 解码策略则直接影响着你设计的聊天机器人是否自然、可信、有温度。
当你下次编写提示词时,你会意识到,你不是在命令一个黑箱,而是在与一个基于数学与统计规律运行的复杂系统进行对话。你的每一个措辞、每一段结构、每一个参数设置,都在影响它的注意力分配和生成路径。这正是大模型时代对开发者的新要求——不仅要懂“怎么做”,更要懂“为什么”。
思考题
在开发一个基于大模型的长篇小说创作助手时,你发现随着故事章节不断推进,模型开始出现以下问题。
角色设定漂移:前期设定为“冷静理智的侦探”的主角,在生成到第5章后逐渐变得情绪化、冲动,甚至做出不符合人设的决策。
关键线索遗忘:第1章中埋下的重要线索(如一枚特殊的戒指)在后续情节中被完全忽略。
生成内容重复:某些场景或对话模式反复出现,例如多次使用“月光洒在窗台上”作为段落开头。
请结合这一讲所学的 Transformer 架构特性与文本生成机制,回答以下问题:
从模型结构的角度分析,上述三个问题可能分别与 Transformer 的哪些核心组件或机制有关?(提示:可从注意力机制、位置编码、自回归生成等角度切入)
针对这些问题,你能在不重新训练模型的前提下,提出三项具体的工程优化策略,并说明其背后的原理吗?
希望通过今天的学习,让你对情感机器人的开发全程有个大致认识。如果有任何疑问,期待你在留言区和我交流。