2.1 初级排序算法
作为对排序算法领域的第一次探索,我们将学习两种初级的排序算法以及其中一种的一个变体。深入学习这些相对简单的算法的原因在于:第一,我们将通过它们熟悉一些术语和简单的技巧;第二,这些简单的算法在某些情况下比我们之后将会讨论的复杂算法更有效;第三,以后你会发现,它们有助于我们改进复杂算法的效率。
2.1.1 游戏规则
我们关注的主要对象是重新排列 数组元素 的算法,其中每个元素都有一个 主键。排序算法的目标就是将所有元素的主键按照某种方式排列(通常是按照大小或是字母顺序)。排序后索引较大的主键大于等于索引较小的主键。元素和主键的具体性质在不同的应用中千差万别。在 Java 中,元素通常都是对象,对主键的抽象描述则是通过一种内置的机制(请见 2.1.1.4 节中的 Comparable 接口)来完成的。
“排序算法类模版”中的 Example 类展示了我们的习惯约定:我们会将排序代码放在类的 sort() 方法中,该类还将包含辅助函数 less() 和 exch()(可能还有其他辅助函数)以及一个示例用例 main()。 Example 类还包含了一些早期调试使用的代码:测试用例 main() 将标准输入得到的字符串排序,并用私有方法 show() 打印字符数组的内容。我们还会在本章中遇到各种用于比较不同算法并研究它们的性能的测试用例。为了区别不同的排序算法,我们为相应的类取了不同的名字,用例可以根据名字调用不同的实现,例如 Insertion.sort()、 Merge.sort()、 Quick.sort() 等。
大多数情况下,我们的排序代码只会通过两个方法操作数据: less() 方法对元素进行比较, exch() 方法将元素交换位置。 exch() 方法的实现很简单,通过 Comparable 接口实现 less() 方法也不困难。将数据操作限制在这两个方法中使得代码的可读性和可移植性更好,更容易验证代码的正确性、分析性能以及排序算法之间的比较。在学习具体的排序算法实现之前,我们先讨论几个对于所有排序算法都很重要的问题。
排序算法类的模板
public class Example { public static void sort(Comparable[] a) { /* 请见算法2.1、算法2.2、算法2.3、算法2.4、算法2.5或算法2.7*/ } private static boolean less(Comparable v, Comparable w) { return v.compareTo(w) < 0; } private static void exch(Comparable[] a, int i, int j) { Comparable t = a[i]; a[i] = a[j]; a[j] = t; } private static void show(Comparable[] a) { // 在单行中打印数组 for (int i = 0; i < a.length; i++) StdOut.print(a[i] + " "); StdOut.println(); } public static boolean isSorted(Comparable[] a) { // 测试数组元素是否有序 for (int i = 1; i < a.length; i++) if (less(a[i], a[i-1])) return false; return true; } public static void main(String[] args) { // 从标准输入读取字符串,将它们排序并输出 String[] a = In.readStrings(); sort(a); assert isSorted(a); show(a); } }% more tiny.txt S O R T E X A M P L E % java Example < tiny.txt A E E L M O P R S T X % more words3.txt bed bug dad yes zoo ... all bad yet % java Example < words.txt all bad bed bug dad ... yes yet zoo这个类展示的是数组排序实现的框架。对于我们学习的每种排序算法,我们都会为这样一个类实现一个
sort()方法并将Example改为算法的名称。测试用例会将标准输入得到的字符串排序,但是这段代码使我们的排序方法适用于任意实现了Comparable接口的数据类型。
2.1.1.1 验证
无论数组的初始状态是什么,排序算法都能成功吗?谨慎起见,我们会在测试代码中添加一条语句 assert isSorted(a); 来确认排序后数组元素都是有序的。尽管一般都会测试代码并从数学上证明算法的正确性,但在实现 每个 排序算法时加上这条语句仍然是必要的。需要注意的是,如果我们只使用 exch() 来交换数组的元素,这个测试就足够了。当我们直接将值存入数组中时,这条语句无法提供足够的保证(例如,把初始输入数组的元素全部置为相同的值也能通过这个测试)。
2.1.1.2 运行时间
我们还要评估算法的 性能。首先,要计算各个排序算法在不同的随机输入下的基本操作的次数(包括比较和交换,或者是读写数组的次数)。然后,我们用这些数据来估计算法的相对性能并介绍在实验中验证这些猜想所使用的工具。对于大多数实现,代码风格一致会使我们更容易作出对性能的合理猜想。
排序成本模型。在研究排序算法时,我们需要计算 比较 和 交换 的数量。对于不交换元素的算法,我们会计算 访问数组的次数。
2.1.1.3 额外的内存使用
排序算法的额外内存开销和运行时间是同等重要的。排序算法可以分为两类:除了函数调用所需的栈和固定数目的实例变量之外无需额外内存的 原地排序算法,以及需要额外内存空间来存储另一份数组副本的其他排序算法。
2.1.1.4 数据类型
我们的排序算法模板适用于任何实现了 Comparable 接口的数据类型。遵守 Java 惯例的好处是很多你希望排序的数据都实现了 Comparable 接口。例如,Java 中封装数字的类型 Integer 和 Double,以及 String 和其他许多高级数据类型(如 File 和 URL)都实现了 Comparable 接口。因此你可以直接用这些类型的数组作为参数调用我们的排序方法。例如,右上方的代码使用了快速排序(请见 2.3 节)来对 N 个随机的 Double 数据进行排序。
Double a[] = new Double[N];
for (int i = 0; i < N; i++)
a[i] = StdRandom.uniform();
Quick.sort(a);将 个随机值的数组排序
在创建自己的数据类型时,我们只要实现 Comparable 接口就能够保证用例代码可以将其排序。要做到这一点,只需要实现一个 compareTo() 方法来定义目标类型对象的 自然次序,如右侧的 Date 数据类型所示(参见表 1.2.12)。
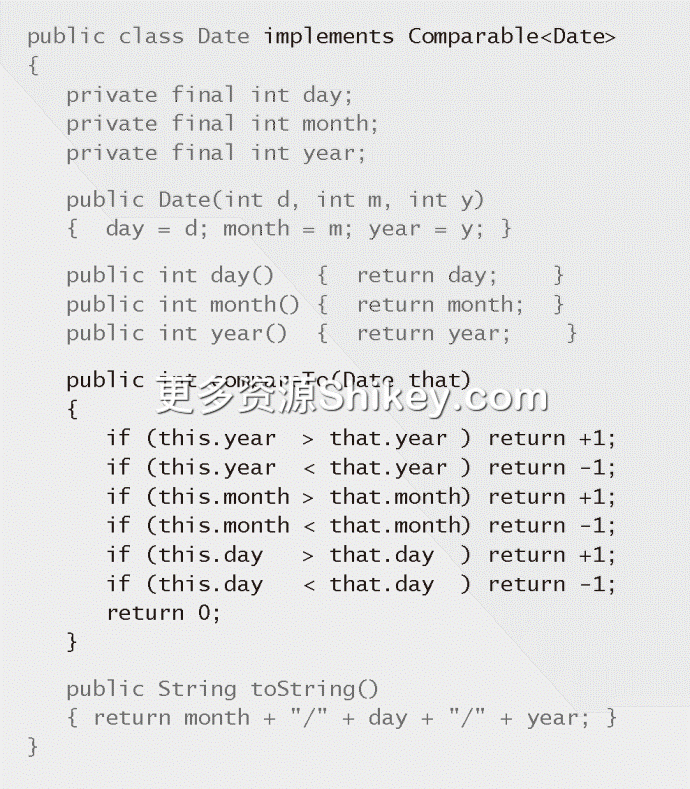
定义一个可比较的数据类型
对于 v<w、 v=w 和 v>w 三种情况,Java 的习惯是在 v.compareTo(w) 被调用时分别返回一个负整数、零和一个正整数(一般是 -1、0 和 1)。为了节约篇幅,我们接下来用 v>w 来表示 v.compareTo(w)>0 这样的代码。一般来说,如果 v 和 w 无法比较或者两者之一是 null, v.compareTo(w) 将会抛出一个异常。此外, compareTo() 必须实现一个 全序关系,即:
- 自反性,对于所有的
v,v=v; - 反对称性,对于所有的
v<w都有v>w,且v=w时w=v; - 传递性,对于所有的
v、w和x,如果v<=w且w<=x,则v<=x。
从数学上来说这些规则都很标准和自然,遵守它们应该不难。总之, compareTo() 实现了我们的 主键 抽象——它给出了实现了 Comparable 接口的任意数据类型的对象的大小顺序的定义。需要注意的是 compareTo() 方法不一定会用到进行比较的实例的所有实例变量,毕竟数组元素的主键很可能只是每个元素的一小部分。
本章剩余篇幅将会讨论对一组自然次序的对象进行排序的各种算法。为了比较和对照各种算法,我们会检查它们的许多性质,包括在各种输入下它们比较和交换数组元素的次数以及额外内存的使用量。通过这些我们能够对它们的性能作出猜想,而这些猜想在过去的数十年间已经在无数的计算机上被验证过了。所有的实现都是需要通过检验的,所以我们也会讨论相关的工具。在研究经典的选择排序、插入排序、希尔排序、归并排序、快速排序和堆排序之后,我们将在 2.5 节讨论一些实际的应用和问题。
2.1.2 选择排序
一种最简单的排序算法是这样的:首先,找到数组中最小的那个元素,其次,将它和数组的第一个元素交换位置(如果第一个元素就是最小元素那么它就和自己交换)。再次,在剩下的元素中找到最小的元素,将它与数组的第二个元素交换位置。如此往复,直到将整个数组排序。这种方法叫做 选择排序,因为它在不断地选择剩余元素之中的最小者。
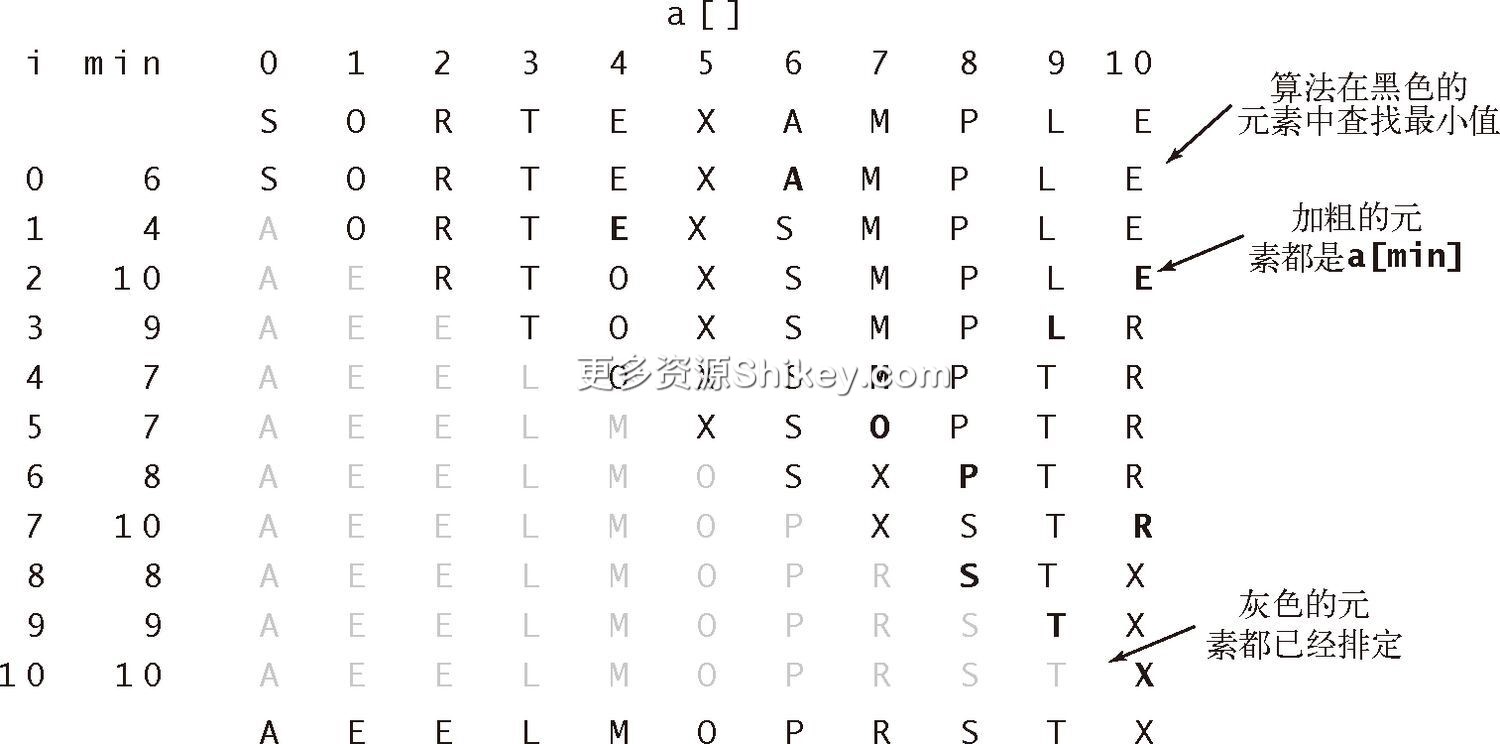
如算法 2.1 所示,选择排序的内循环只是在比较当前元素与目前已知的最小元素(以及将当前索引加 1 和检查是否代码越界),这已经简单到了极点。交换元素的代码写在内循环之外,每次交换都能排定一个元素,因此交换的总次数是 。所以算法的时间效率取决于比较的次数。
命题 A。对于长度为
次比较和
证明。可以通过算法的排序轨迹来证明这一点。我们用一张
的表格来表示排序的轨迹(见算法 2.1 下部的表格),其中每个非灰色字符都表示一次比较。表格中大约一半的元素不是灰色的——即对角线和其上部分的元素。对角线上的每个元素都对应着一次交换。通过查看代码我们可以更精确地得到,0 到
的任意
都会进行一次交换和
次比较,因此总共有
次比较。
总的来说,选择排序是一种很容易理解和实现的简单排序算法,它有两个很鲜明的特点。
运行时间和输入无关。为了找出最小的元素而扫描一遍数组并不能为下一遍扫描提供什么信息。这种性质在某些情况下是缺点,因为使用选择排序的人可能会惊讶地发现,一个已经有序的数组或是主键全部相等的数组和一个元素随机排列的数组所用的排序时间竟然一样长!我们将会看到,其他算法会更善于利用输入的初始状态。
数据移动是最少的。每次交换都会改变两个数组元素的值,因此选择排序用了 次交换——交换次数和数组的大小是 线性 关系。我们将研究的其他任何算法都不具备这个特征(大部分的增长数量级都是线性对数或是平方级别)。
算法 2.1 选择排序
public class Selection { public static void sort(Comparable[] a) { // 将a[]按升序排列 int N = a.length; // 数组长度 for (int i = 0; i < N; i++) { // 将a[i]和a[i+1..N]中最小的元素交换 int min = i; // 最小元素的索引 for (int j = i+1; j < N; j++) if (less(a[j], a[min])) min = j; exch(a, i, min); } } // less()、exch()、isSorted()和main()方法见“排序算法类模板” }该算法将第
i小的元素放到a[i]之中。数组的第i个位置的左边是i个最小的元素且它们不会再被访问。
选择排序的轨迹(每次交换后的数组内容)
2.1.3 插入排序
通常人们整理桥牌的方法是一张一张的来,将每一张牌插入到其他已经有序的牌中的适当位置。在计算机的实现中,为了给要插入的元素腾出空间,我们需要将其余所有元素在插入之前都向右移动一位。这种算法叫做 插入排序,实现请见算法 2.2。
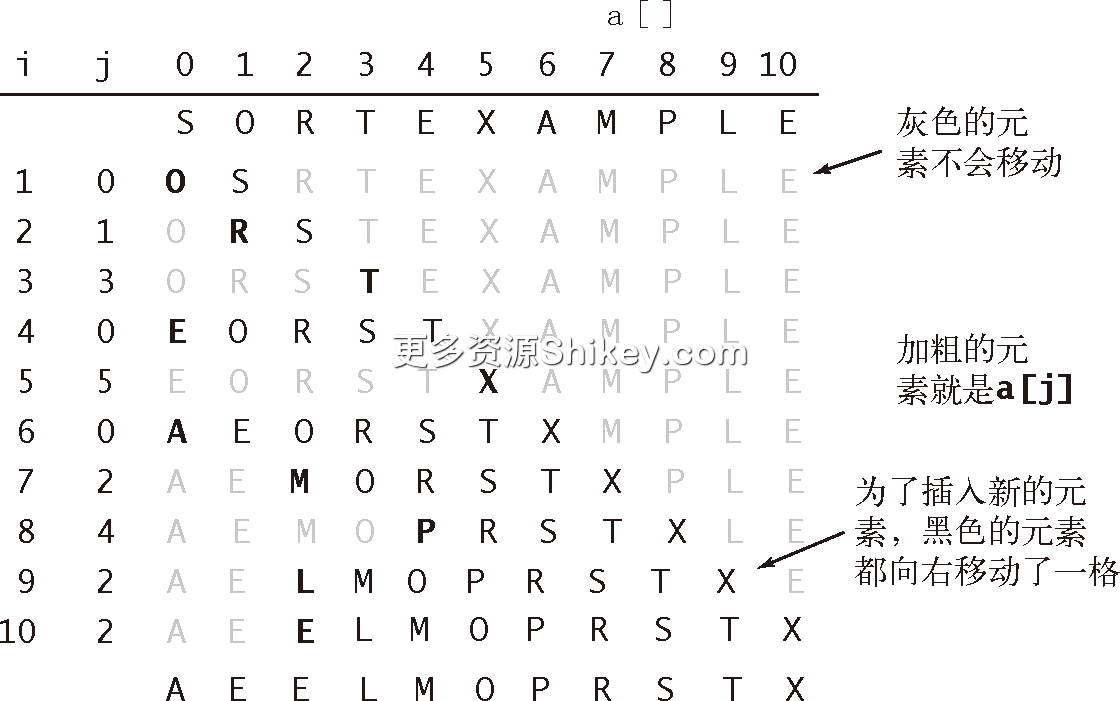
与选择排序一样,当前索引左边的所有元素都是有序的,但它们的最终位置还不确定,为了给更小的元素腾出空间,它们可能会被移动。但是当索引到达数组的右端时,数组排序就完成了。
和选择排序不同的是,插入排序所需的时间取决于输入中元素的初始顺序。例如,对一个很大且其中的元素已经有序(或接近有序)的数组进行排序将会比对随机顺序的数组或是逆序数组进行排序要快得多。
命题 B。对于随机排列的长度为
次比较以及
次比较和
证明。和命题 A 一样,通过一个
比较的总次数是交换的次数加上一个额外的项,该项为
插入排序对于实际应用中常见的某些类型的非随机数组很有效。例如,正如刚才所提到的,想想当你用插入排序对一个有序数组进行排序时会发生什么。插入排序能够立即发现每个元素都已经在合适的位置之上,它的运行时间也是线性的(对于这种数组,选择排序的运行时间是平方级别的)。对于所有主键都相同的数组也会出现相同的情况(因此命题 B 的条件之一就是主键不重复)。
算法 2.2 插入排序
public class Insertion { public static void sort(Comparable[] a) { // 将a[]按升序排列 int N = a.length; for (int i = 1; i < N; i++) { // 将 a[i] 插入到 a[i-1]、a[i-2]、a[i-3]...之中 for (int j = i; j > 0 && less(a[j], a[j-1]); j--) exch(a, j, j-1); } } // less()、exch()、isSorted()和main()方法见“排序算法类模板” }对于
1到N-1之间的每一个i,将a[i]与a[0]到a[i-1]中比它小的所有元素依次有序地交换。在索引i由左向右变化的过程中,它左侧的元素总是有序的,所以当i到达数组的右端时排序就完成了。
插入排序的轨迹(每次插入后的数组内容)
我们要考虑的更一般的情况是 部分有序 的数组。 倒置 指的是数组中的两个顺序颠倒的元素。比如 E X A M P L E 中有 11 对倒置:E-A、X-A、X-M、X-P、X-L、X-E、M-L、M-E、P-L、P-E 以及 L-E。如果数组中倒置的数量小于数组大小的某个倍数,那么我们说这个数组是部分有序的。下面是几种典型的部分有序的数组:
- 数组中每个元素距离它的最终位置都不远;
- 一个有序的大数组接一个小数组;
- 数组中只有几个元素的位置不正确。
插入排序对这样的数组很有效,而选择排序则不然。事实上,当倒置的数量很少时,插入排序很可能比本章中的其他任何算法都要快。
命题 C。插入排序需要的交换操作和数组中倒置的数量相同,需要的比较次数大于等于倒置的数量,小于等于倒置的数量加上数组的大小再减一。
证明。每次交换都改变了两个顺序颠倒的元素的位置,相当于减少了一对倒置,当倒置数量为 0 时,排序就完成了。每次交换都对应着一次比较,且
1到N-1之间的每个i都可能需要一次额外的比较(在a[i]没有达到数组的左端时)。
要大幅提高插入排序的速度并不难,只需要在内循环中将较大的元素都向右移动而不总是交换两个元素(这样访问数组的次数就能减半)。我们把这项改进留做一个练习(请见练习 2.1.25)。
总的来说,插入排序对于部分有序的数组十分高效,也很适合小规模数组。这很重要,因为这些类型的数组在实际应用中经常出现,而且它们也是高级排序算法的中间过程。我们会在学习高级排序算法时再次接触到插入排序。
2.1.4 排序算法的可视化
在本章中我们会使用一种简单的图示来帮助我们说明排序算法的性质。我们没有使用字母、数字或是单词这样的键值来跟踪排序的进程,而使用了棒状图,并以它们的高矮来排序。这种表示方法的好处是能够使排序过程一目了然。
如图 2.1.1 所示,插入排序不会访问索引右侧的元素,而选择排序不会访问索引左侧的元素。另外,在这种可视化的轨迹图中可以看到,因为插入排序不会移动比被插入的元素更小的元素,它所需的比较次数平均只有选择排序的一半。
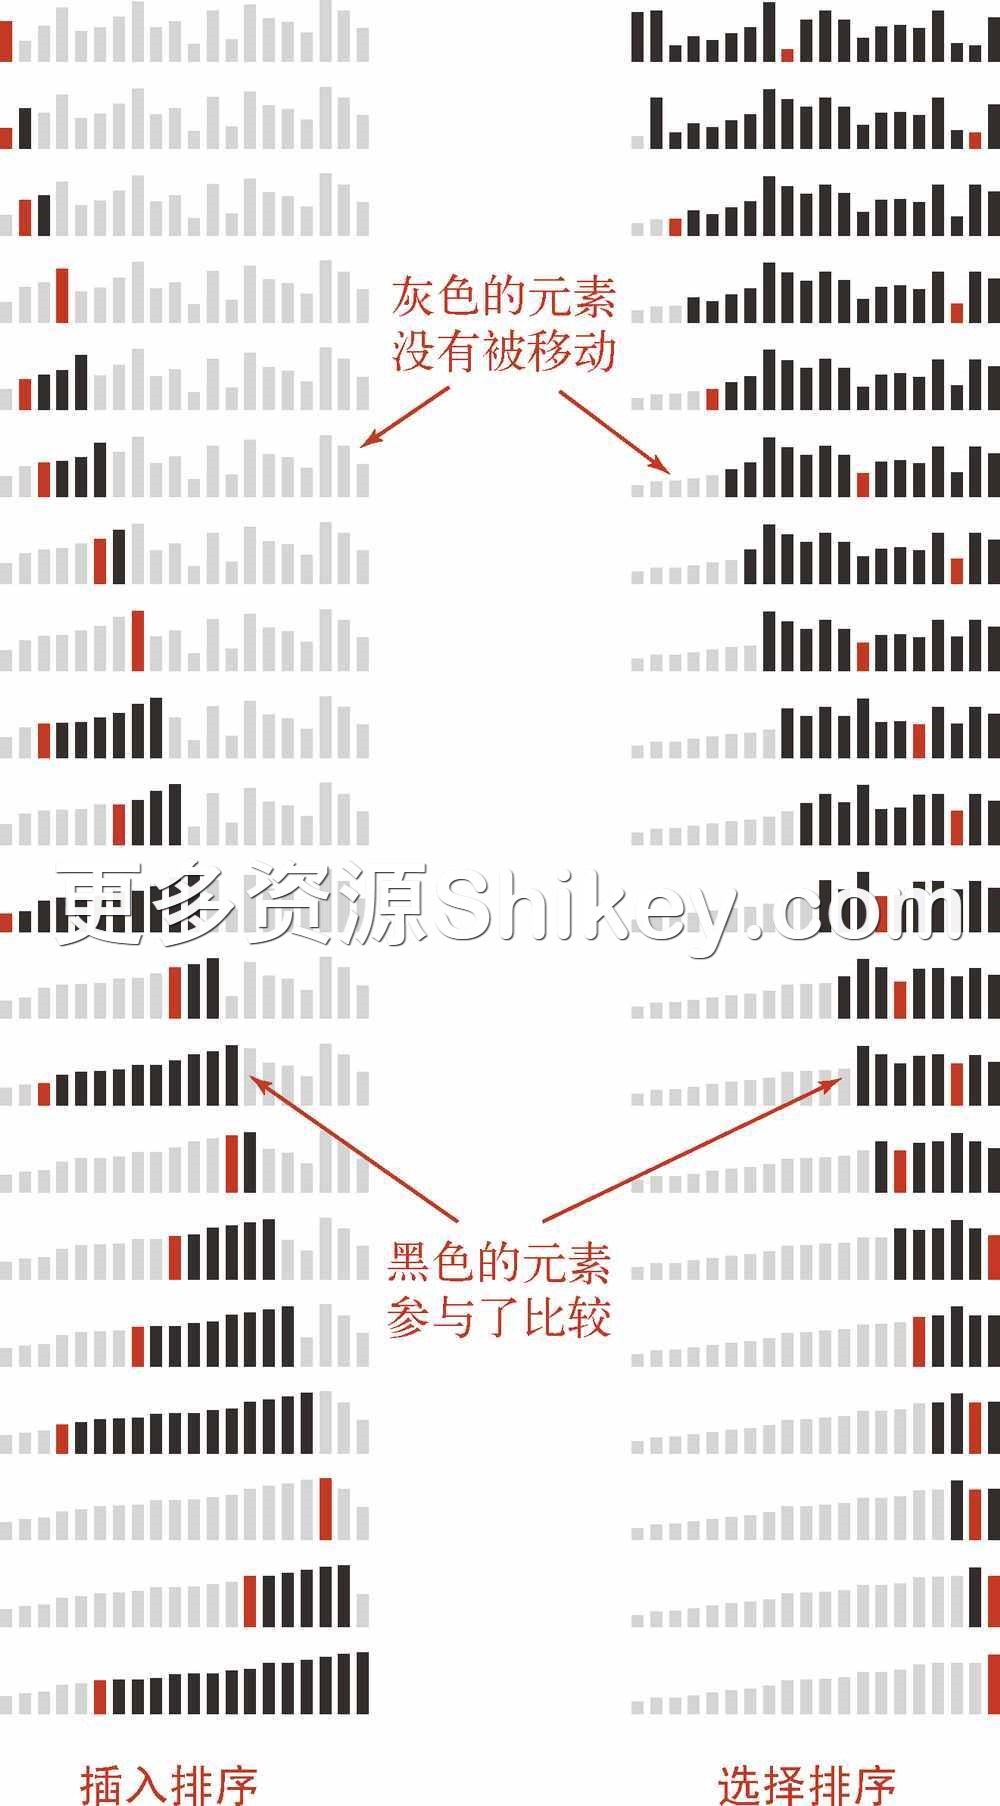
图 2.1.1 初级排序算法的可视轨迹图
用我们的 StdDraw 库画出一张可视轨迹图并不比追踪一次算法的运行轨迹难多少。将 Double 值排序,并在适当的时候指示算法调用 show() 方法(和追踪算法的轨迹时一样),然后开发一个使用 StdDraw 来绘制棒状图而不是打印结果的 show() 方法。最复杂的部分是设置  轴的比例以使轨迹的线条符合预期的顺序。请通过练习 2.1.18 来更好地理解可视轨迹图的价值和使用。
将轨迹变成 动画,理解起来就更加简单,这样可以看到动态演化到有序状态的过程。产生轨迹动画的过程本质上和上一段所描述的相同,但不需要担心 轴的问题(只需每次擦除窗口中的内容并重绘棒状图即可)。尽管我们无法在书中展现这些动画,它们对于理解算法的工作原理也很有帮助,你能通过练习 2.1.17 体会这一点。
2.1.5 比较两种排序算法
现在我们已经实现了两种排序算法,我们很自然地想知道选择排序(算法 2.1)和插入排序(算法 2.2)哪种更快。这个问题在学习算法的过程中会反复出现,也是本书的重点之一。我们已经在第 1 章中讨论过一些基本的概念,这里我们第一次用实践说明我们解决这个问题的办法。一般来说,根据 1.4 节所介绍的方法,我们将通过以下步骤比较两个算法:
- 实现并调试它们;
- 分析它们的基本性质;
- 对它们的相对性能作出猜想;
- 用实验验证我们的猜想。
这些步骤都是经过时间检验的 科学方法,只是现在是运用在算法研究之上。
现在,算法 2.1 和算法 2.2 表示已经实现了第一步,命题 A、命题 B 和命题 C 组成了第二步,下面的性质 D 将是第三步,之后“比较两种排序算法”的 SortCompare 类将会完成第四步。这些行为都是紧密相关的。
在这些简洁的步骤之下是大量的算法实现、调试分析和测试工作。每个程序员都知道只有经过长期的调试和改进才能得到这样的代码,每个数学家都知道正确分析的难度,每个科学家也都知道从提出猜想到设计并执行实验来验证它们是多么费心。只有研究那些最重要的算法的专家才会经历完整的研究过程,但每个使用算法的程序员都应该了解算法的性能特性背后的科学过程。
实现了算法之后,下一步我们需要确定一个适当的输入模型。对于排序,命题 A、命题 B 和命题 C 用到的自然输入模型假设数组中的元素随机排序,且主键值不会重复。对于有很多重复主键的应用来说,我们需要一个更加复杂的模型。
如何估计插入排序和选择排序在随机排序数组下的性能呢?通过算法 2.1 和算法 2.2 以及命题 A、命题 B 和命题 C 可以发现,对于随机排序数组,两者的运行时间都是平方级别的。也就是说,在这种输入下插入排序的运行时间和  乘以一个小常数成正比,选择排序的运行时间和 乘以另一个小常数成比例。这两个常数的值取决于所使用的计算机中比较和交换元素的成本。对于许多数据类型和一般的计算机,可以假设这些成本是相近的(但我们也会看到一些大不相同的例外)。因此我们直接得出了以下猜想。
性质 D。对于随机排序的无重复主键的数组,插入排序和选择排序的运行时间是平方级别的,两者之比应该是一个较小的常数。
例证。这个结论在过去的半个世纪中已经在许多不同类型的计算机上经过了验证。在 1980 年本书第 1 版完成之时插入排序就比选择排序快一倍,现在仍然是这样,尽管那时这些算法将 10 万条数据排序需要几个小时而现在只需要几秒钟。在你的计算机上插入排序也比选择排序快一些吗?可以通过
SortCompare类来检测。它会使用由命令行参数指定的排序算法名称所对应的sort()方法进行指定次数的实验(将指定大小的数组排序),并打印出所观察到的各种算法的运行时间的比例。
为了证明这一点,我们用 SortCompare(见“比较两种排序算法”)来做几次实验。我们使用 Stopwatch 来计时,右侧的 time() 函数的任务是调用本章中的几种简单排序算法。
public static double time(String alg, Comparable[] a) { Stopwatch timer = new Stopwatch(); if (alg.equals("Insertion")) Insertion.sort(a); if (alg.equals("Selection")) Selection.sort(a); if (alg.equals("Shell")) Shell.sort(a); if (alg.equals("Merge")) Merge.sort(a); if (alg.equals("Quick")) Quick.sort(a); if (alg.equals("Heap")) Heap.sort(a); return timer.elapsedTime(); }针对给定输入,为本章中的一种排序算法计时
随机数组的输入模型由 SortCompare 类中的 timeRandomInput() 方法实现。这个方法会生成随机的 Double 值,将它们排序,并返回指定次测试的总时间。使用 0.0 至 1.0 之间的随机 Double 值比使用类似于 StdRandom.shuffle() 的库函数更简单有效,因为这样几乎不可能产生相等的主键值(请见练习 2.5.31)。如第 1 章中所讨论的,用命令行参数指定重复次数的好处是能够运行大量的测试(测试次数越多,每遍测试所需的平均时间就越接近于真实的平均数据)并且能够减小系统本身的影响。你应该在自己的计算机上用 SortCompare 进行实验,来了解关于插入排序和选择排序的结论是否成立。
比较两种排序算法
public class SortCompare { public static double time(String alg, Double[] a) { /* 请见前面的正文 */ } public static double timeRandomInput(String alg, int N, int T) { // 使用算法alg将T个长度为N的数组排序 double total = 0.0; Double[] a = new Double[N]; for (int t = 0; t < T; t++) { // 进行一次测试(生成一个数组并排序) for (int i = 0; i < N; i++) a[i] = StdRandom.uniform(); total += time(alg, a); } return total; } public static void main(String[] args) { String alg1 = args[0]; String alg2 = args[1]; int N = Integer.parseInt(args[2]); int T = Integer.parseInt(args[3]); double t1 = timeRandomInput(alg1, N, T); // 算法1的总时间 double t2 = timeRandomInput(alg2, N, T); // 算法2的总时间 StdOut.printf(“For %d random Doubles\n %s is”, N, alg1); StdOut.printf(“ %.1f times faster than %s\n”, t2/t1, alg2); } }这个用例会运行由前两个命令行参数指定的排序算法,对长度为
N(由第三个参数指定)的Double型随机数组进行排序,元素值均在 0.0 到 1.0 之间,重复T次(由第四个参数指定),然后输出总运行时间的比例。% java SortCompare Insertion Selection 1000 100 For 1000 random Doubles Insertion is 1.7 times faster than Selection
我们故意将性质 D 描述得不够明确——没有说明那个小常量的值,以及对比较和交换的成本相近的假设,这样性质 D 才能广泛适用于各种情况。可能的话,我们会尽量用这样的语言来抓住我们所研究的每个算法的性能的本质。如第 1 章中讨论的那样,我们提出的每个性质都需要在特定的场景中进行科学测试,也许还需要用一个基于相关 命题(数学定理)的猜想进行补充。
对于实际应用,还有一个很重要的步骤, 那就是用实际数据在实验中验证我们的猜想。我们会在 2.5 节和练习中再考虑这一点。在这种情况下,当主键有重复或是排列不随机,性质 D 就可能会不成立。可以使用 StdRandom.shuffle() 来将一个数组打乱,但有大量重复主键的情况则需要更加细致的分析。
我们对算法分析的讨论是抛砖引玉,而非盖棺定论。如果你想到了关于算法性能的其他问题,可以用 SortCompare 等工具来研究它,后面的练习为你提供了许多机会。
插入排序和选择排序的性能比较就讨论到这里,还存在许多比它们快成千上万倍的算法,我们对此会更感兴趣。当然,仍然有必要学习这些初级算法,因为:
- 它们帮助我们建立了一些基本的规则;
- 它们展示了一些性能基准;
- 在某些特殊情况下它们也是很好的选择;
- 它们是开发更强大的排序算法的基石。
因此,不止是排序,对于本书中的每个问题我们都会沿用这种方式,首先学习的就是最初级的相关算法。 SortCompare 这样的程序对于这种渐进式的算法研究十分重要。每一步,我们都能用这类程序来了解新的或是改进后的算法的性能是否产生了预期的进步。
2.1.6 希尔排序
为了展示初级排序算法性质的价值,接下来我们将学习一种基于插入排序的快速的排序算法。对于大规模乱序数组插入排序很慢,因为它只会交换相邻的元素,因此元素只能一点一点地从数组的一端移动到另一端。例如,如果主键最小的元素正好在数组的尽头,要将它挪到正确的位置就需要 次移动。希尔排序为了加快速度简单地改进了插入排序,交换不相邻的元素以对数组的局部进行排序,并最终用插入排序将局部有序的数组排序。
希尔排序的思想是使数组中任意间隔为 h 的元素都是有序的。这样的数组被称为 h 有序数组。换句话说,一个 h 有序数组 就是 h 个互相独立的有序数组编织在一起组成的一个数组(见图 2.1.2)。在进行排序时,如果 h 很大,我们就能将元素移动到很远的地方,为实现更小的 h 有序 创造方便。用这种方式,对于任意以 1 结尾的 h 序列,我们都能够将数组排序。这就是希尔排序。算法 2.3 的实现使用了序列  ,从
 开始递减至 1。我们把这个序列称为 递增序列。算法 2.3 实时计算了它的 递增序列,另一种方式是将递增序列存储在一个数组中。
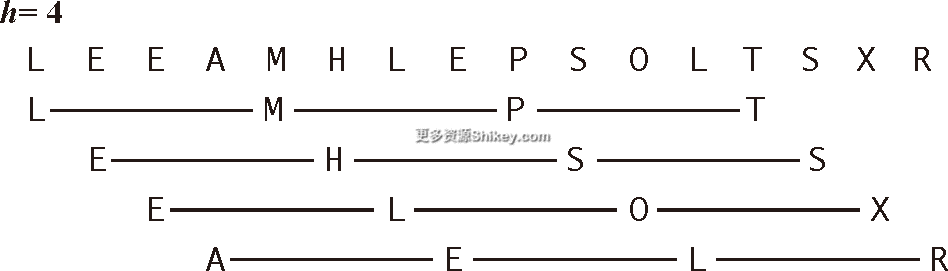
图 2.1.2 一个 h 有序数组即一个由 h 个有序子数组组成的数组
实现希尔排序的一种方法是对于每个 h,用插入排序将 h 个子数组独立地排序。但因为子数组是相互独立的,一个更简单的方法是在 h- 子数组中将每个元素交换到比它大的元素之前去(将比它大的元素向右移动一格)。只需要在插入排序的代码中将移动元素的距离由 1 改为 h 即可。这样,希尔排序的实现就转化为了一个类似于插入排序但使用不同增量的过程。
希尔排序更高效的原因是它权衡了子数组的规模和有序性。排序之初,各个子数组都很短,排序之后子数组都是部分有序的,这两种情况都很适合插入排序。子数组部分有序的程度取决于递增序列的选择。透彻理解希尔排序的性能至今仍然是一项挑战。实际上,算法 2.3 是我们唯一无法准确描述其对于乱序的数组的性能特征的排序方法。
算法 2.3 希尔排序
public class Shell { public static void sort(Comparable[] a) { // 将a[]按升序排列 int N = a.length; int h = 1; while (h < N/3) h = 3*h + 1; // 1, 4, 13, 40, 121, 364, 1093, ... while (h >= 1) { // 将数组变为h有序 for (int i = h; i < N; i++) { // 将a[i]插入到a[i-h], a[i-2*h], a[i-3*h]... 之中 for (int j = i; j >= h && less(a[j], a[j-h]); j -= h) exch(a, j, j-h); } h = h/3; } } // less()、exch()、isSorted()和main()方法见“排序算法类模板” }如果我们在插入排序(算法 2.2)中加入一个外循环来将 h 按照递增序列递减,我们就能得到这个简洁的希尔排序。增幅 h 的初始值是数组长度乘以一个常数因子,最小为 1。
% java SortCompare Shell Insertion 100000 100 For 100000 random Doubles Shell is 600 times faster than Insertion
希尔排序的轨迹(每遍排序后的数组内容)
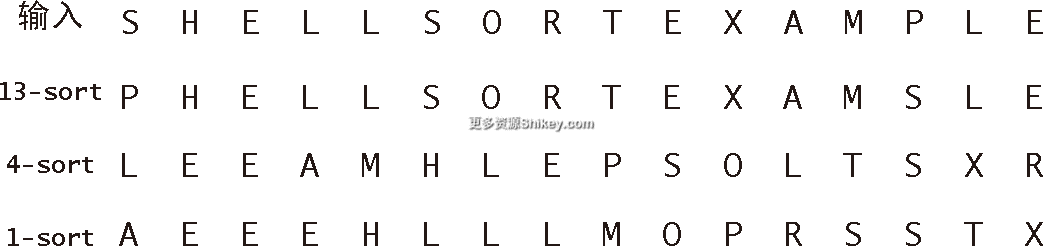
如何选择递增序列呢?要回答这个问题并不简单。算法的性能不仅取决于 h,还取决于 h 之间的数学性质,比如它们的公因子等。有很多论文研究了各种不同的递增序列,但都无法证明某个序列是“最好的”。算法 2.3 中递增序列的计算和使用都很简单,和复杂递增序列的性能接近。但可以证明复杂的序列在最坏情况下的性能要好于我们所使用的递增序列。更加优秀的递增序列有待我们去发现。
和选择排序以及插入排序形成对比的是,希尔排序也可以用于大型数组。它对任意排序(不一定是随机的)的数组表现也很好。实际上,对于一个给定的递增序列,构造一个使希尔排序运行缓慢的数组并不容易。希尔排序的轨迹如图 2.1.3 所示,可视轨迹如图 2.1.4 所示。
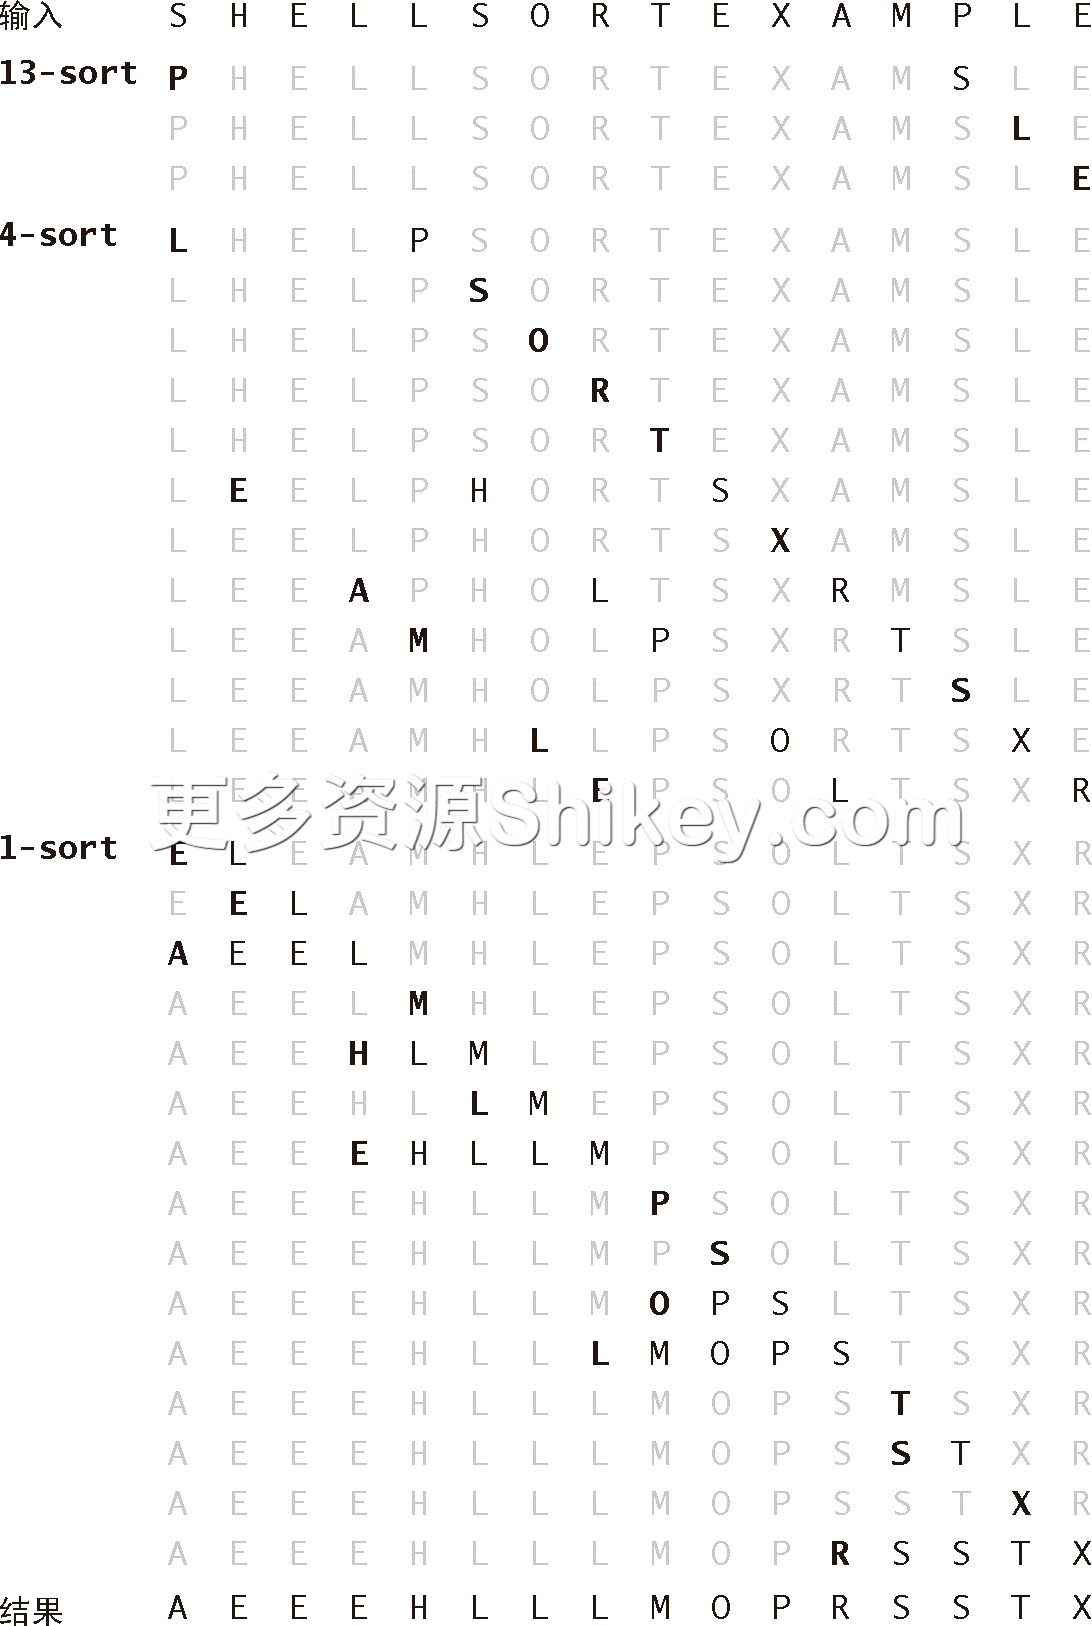
图 2.1.3 希尔排序的详细轨迹(各种插入)
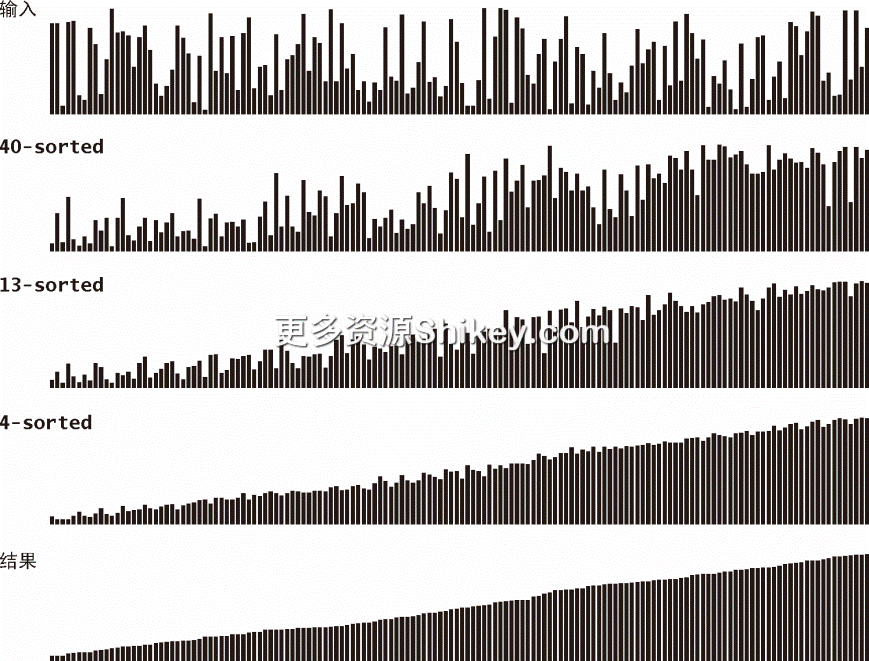
图 2.1.4 希尔排序的可视轨迹
通过 SortCompare 可以看到,希尔排序比插入排序和选择排序要快得多,并且数组越大,优势越大。在继续学习之前,请在你的计算机上用 SortCompare 比较一下希尔排序和插入排序以及选择排序的性能,数组的大小按照 2 的幂次递增(见练习 2.1.27)。你会看到希尔排序能够解决一些初级排序算法无能为力的问题。这个例子是我们第一次用实际应用说明一个贯穿本书的重要理念: 通过提升速度来解决其他方式无法解决的问题是研究算法的设计和性能的主要原因之一。
研究希尔排序性能需要的数学论证超出了本书范围。如果你不相信,可以从证明下面这一点开始: 当一个“h 有序”的数组按照增幅 k 排序之后,它仍然是“h 有序”的。至于算法 2.3 的性能,目前最重要的结论是 它的运行时间达不到平方级别。例如,已知在最坏的情况下算法 2.3 的比较次数和  成正比。有意思的是,由插入排序到希尔排序,一个小小的改变就突破了平方级别的运行时间的屏障。这正是许多算法设计问题想要达到的目标。
在输入随机排序数组的情况下,我们在数学上还不知道希尔排序所需要的平均比较次数。人们发明了很多递增序列来渐进式地改进最坏情况下所需的比较次数(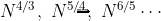 ),但这些结论大多只有学术意义,因为对于实际应用中的 来说它们的递增序列的生成函数(以及与 乘以一个常数因子)之间的区别并不明显。
在实际应用中,使用算法 2.3 中的递增序列基本就足够了(或者是本节最后的练习中提供的一个递增序列,它可能可以将性能改进 20% ~ 40%)。另外,很容易就能验证下面这个猜想。
性质 E。使用递增序列 1, 4, 13, 40, 121, 364… 的希尔排序所需的比较次数不会超出N的若干倍乘以递增序列的长度。
例证。记录算法2.3中比较的数量并将其除以使用的序列长度是一道简单的练习(请见练习 2.1.12)。大量的实验证明平均每个增幅所带来的比较次数约为
,但只有在N很大的时候这个增长幅度才会变得明显。这个性质似乎也和输入模型无关。
有经验的程序员有时会选择希尔排序,因为对于中等大小的数组它的运行时间是可以接受的。它的代码量很小,且不需要使用额外的内存空间。在下面的几节中我们会看到更加高效的算法,但除了对于很大的 ,它们可能只会比希尔排序快两倍(可能还达不到),而且更复杂。如果你需要解决一个排序问题而又没有系统排序函数可用(例如直接接触硬件或是运行于嵌入式系统中的代码),可以先用希尔排序,然后再考虑是否值得将它替换为更加复杂的排序算法。
答疑
问 排序看起来是个很简单的问题,我们用计算机不是可以做很多更有意思的事情吗?
答 也许吧,但快速的排序算法才使得那些更有意思的事情 成为可能。在 2.5 节以及全书的其他章节你都可以找到很多这样的例子。排序算法今天仍然值得我们学习是因为它易于理解,你能从中领会到许多精妙之处。
问 为什么有这么多排序算法?
答 原因之一是许多排序算法的性能都和输入模型有很大的关系,因此不同的算法适用于不同应用场景中的不同输入。例如,对于部分有序和小规模的数组应该选择插入排序。其他限制条件,例如空间和重复的主键,也都是需要考虑的因素。我们将会在 2.5 节中再次讨论这个问题。
问 为什么要使用 less() 和 exch() 这些不起眼的辅助函数?
答 它们抽象了所有排序算法都会用到的共同操作,这种抽象使得代码更便于理解。而且它们增强了代码的可移植性。例如,算法 2.1 和算法 2.2 中的大部分代码在其他几种编程语言中也是可以执行的。即使是在 Java 中,只要将 less() 实现为 v < w,这些算法的代码就可以将不支持 Comparable 接口的基本数据类型排序了。
问 当我运行 SortCompare 时,每次的结果都不一样(而且和书上的也不相同),为什么?
答 对于初学者,你的计算机和我们的计算机不同,操作系统、Java 运行时环境等都不一样。这些不同可能导致算法代码生成的机器码不同。每次运行所得结果不同的原因可能在于当时运行的其他程序或是很多其他原因。大量的重复实验可以淡化这种干扰,我们的经验是现如今算法性能的微小差异很难观察。这就是我们要关注较大差异的原因。
练习
2.1.1 按照算法 2.1 所示轨迹的格式给出选择排序是如何将数组 E A S Y Q U E S T I O N 排序的。
2.1.2 在选择排序中,一个元素最多可能会被交换多少次?平均可能会被交换多少次?
2.1.3 构造一个含有 个元素的数组,使选择排序(算法 2.1)运行过程中 a[j] < a[min](由此 min 会不断更新)成功的次数最大。
2.1.4 按照算法 2.2 所示轨迹的格式给出插入排序是如何将数组 E A S Y Q U E S T I O N 排序的。
2.1.5 构造一个含有 个元素的数组,使插入排序(算法 2.2)运行过程中内循环( for)的两个判断结果总是假。
2.1.6 在所有的主键都相同时,选择排序和插入排序谁更快?
2.1.7 对于逆序数组,选择排序和插入排序谁更快?
2.1.8 假设元素只可能有三种值,使用插入排序处理这样一个随机数组的运行时间是线性的还是平方级别的?或是介于两者之间?
2.1.9 按照算法 2.3 所示轨迹的格式给出希尔排序是如何将数组 E A S Y S H E L L S O R T Q U E S T I O N 排序的。
2.1.10 在希尔排序中为什么在实现 h 有序 时不使用选择排序?
2.1.11 将希尔排序中实时计算递增序列改为预先计算并存储在一个数组中。
2.1.12 令希尔排序打印出递增序列的每个元素所带来的比较次数和数组大小的比值。编写一个测试用例对随机 Double 数组进行希尔排序,验证该值是一个小常数,数组大小按照 10 的幂次递增,不小于 100。
提高题
2.1.13 纸牌排序。说说你会如何将一副扑克牌按花色排序(花色顺序是黑桃、红桃、梅花和方片),限制条件是所有牌都是背面朝上排成一列,而你一次只能翻看两张牌或者交换两张牌(保持背面朝上)。
2.1.14 出列排序。说说你会如何将一副扑克牌排序,限制条件是只能查看最上面的两张牌,交换最上面的两张牌,或是将最上面的一张牌放到这摞牌的最下面。
2.1.15 昂贵的交换。一家货运公司的一位职员得到了一项任务,需要将若干大货箱按照发货时间摆放。比较发货时间很容易(对照标签即可),但将两个货箱交换位置则很困难(移动麻烦)。仓库已经快满了,只有一个空闲的仓位。这位职员应该使用哪种排序算法呢?
2.1.16 验证。编写一个 check() 方法,调用 sort() 对任意数组排序。如果排序成功而且数组中的所有对象均没有被修改则返回 true,否则返回 false。不要假设 sort() 只能通过 exch() 来移动数据,可以信任并使用 Arrays.sort()。
2.1.17 动画。修改插入排序和选择排序的代码,使之将数组内容绘制成正文中所示的棒状图。在每一轮排序后重绘图片来产生动画效果,并以一张“有序”的图片作为结束,即所有圆棒均已按照高度有序排列。 提示:使用类似于正文中的用例来随机生成 Double 值,在排序代码的适当位置调用 show() 方法,并在 show() 方法中清理画布并绘制棒状图。
2.1.18 可视轨迹。修改你为上一题给出的解答,为插入排序和选择排序生成和正文中类似的可视轨迹。 提示:使用 setYscale() 函数是一个明智的选择。 附加题:添加必要的代码,与正文中的图片一样用红色和灰色强调不同角色的元素。
2.1.19 希尔排序的最坏情况。用 1 到 100 构造一个含有 100 个元素的数组并用希尔排序和递增序列 1 4 13 40 对其排序,使比较的次数尽可能多。
2.1.20 希尔排序的最好情况。最好情况是什么?证明你的结论。
2.1.21 可比较的交易。用我们的 Date 类(请见 2.1.1.4 节)作为模板扩展你的 Transaction 类(请见练习 1.2.13),实现 Comparable 接口,使交易能够按照金额排序。
解答:
public class Transaction implements Comparable<Transaction>
{
...
private final double amount;
...
public int compareTo(Transaction that)
{
if (this.amount > that.amount) return +1;
if (this.amount < that.amount) return -1;
return 0;
}
...
}2.1.22 交易排序测试用例。编写一个 SortTransaction 类,在静态方法 main() 中从标准输入读取一系列交易,将它们排序并在标准输出中打印结果(请见练习 1.3.17)。
解答:
public class SortTransactions
{
public static Transaction[] readTransactions()
{ // 请见练习1.3.17 }
public static void main(String[] args)
{
Transaction[] transactions = readTransactions();
Shell.sort(transactions);
for (Transaction t : transactions)
StdOut.println(t);
}
}实验题
2.1.23 纸牌排序。请几位朋友分别将一副扑克牌排序(见练习 2.1.13)。仔细观察并记录他们所使用的方法。
2.1.24 插入排序的哨兵。在插入排序的实现中先找出最小的元素并将其置于数组的最左边,这样就能去掉内循环的判断条件 j>0。使用 SortCompare 来评估这种做法的效果。 注意:这是一种常见的规避边界测试的方法,能够省略判断条件的元素通常被称为 哨兵。
2.1.25 不需要交换的插入排序。在插入排序的实现中使较大元素右移一位只需要访问一次数组(而不用使用 exch())。使用 SortCompare 来评估这种做法的效果。
2.1.26 原始数据类型。编写一个能够处理 int 值的插入排序的新版本,比较它和正文中所给出的实现(能够隐式地用自动装箱和拆箱转换 Integer 值并排序)的性能。
2.1.27 希尔排序的用时是次平方级的。在你的计算机上用 SortCompare 比较希尔排序和插入排序以及选择排序。测试数组的大小按照 2 的幂次递增,从 128 开始。
2.1.28 相等的主键。对于主键仅可能取两种值的数组,评估和验证插入排序和选择排序的性能,假设两种主键值出现的概率相同。
2.1.29 希尔排序的递增序列。通过实验比较算法 2.3 中所使用的递增序列和递增序列 1,5,19,41,109,209,505,929,2161,3905,8929,16 001,36 289,64 769,146 305,260 609(这是通过序列 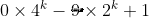 和
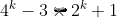 综合得到的)。可以参考练习 2.1.11。
2.1.30 几何级数递增序列。通过实验找到一个  ,使得对于大小为
 的任意随机数组,使用递增序列 1,
 ,
 ,
 ,
 ,…的希尔排序的运行时间最短。给出你能找到的三个最佳 值以及相应的递增序列。
以下 练习描述的是各种用于评估排序算法的测试用例。它们的作用是用随机数据帮助你增进对性能特性的理解。随着命令行指定的实验次数的增大,可以和 SortCompare 一样在它们中使用 time() 函数来得到更精确的结果。在以后的几节中我们会使用这些练习来评估更加复杂的算法。
2.1.31 双倍测试。编写一个能够对排序算法进行双倍测试的用例。数组规模 N 的起始值为 1000,排序后打印 N、估计排序用时、实际排序用时以及在 N 增倍之后两次用时的比例。用这段程序验证在随机输入模型下插入排序和选择排序的运行时间都是平方级别的。对希尔排序的性能作出猜想并验证你的猜想。
2.1.32 运行时间曲线图。编写一个测试用例,使用 StdDraw 在各种不同规模的随机输入下将算法的平均运行时间绘制成一张曲线图。可能需要添加一两个命令行参数,请尽量设计一个实用的工具。
2.1.33 分布图。对于你为练习 2.1.33 给出的测试用例,在一个无穷循环中调用 sort() 方法将由第三个命令行参数指定大小的数组排序,记录每次排序的用时并使用 StdDraw 在图上画出所有平均运行时间,应该能够得到一张运行时间的 分布图。
2.1.34 罕见情况。编写一个测试用例,调用 sort() 方法对实际应用中可能出现困难或极端情况的数组进行排序。比如,数组可能已经是有序的,或是逆序的,数组的所有主键相同,数组的主键只有两种值,大小为 0 或是 1 的数组。
2.1.35 不均匀的概率分布。编写一个测试用例,使用非均匀分布的概率来生成随机排列的数据,包括:
- 高斯分布;
- 泊松分布;
- 几何分布;
- 离散分布(一种特殊情况请见练习 2.1.28)。
评估并验证这些输入数据对本节讨论的算法的性能的影响。
2.1.36 不均匀的数据。编写一个测试用例,生成不均匀的测试 数据,包括:
- 一半数据是 0,一半是 1;
- 一半数据是 0,1/4 是 1,1/4 是 2,以此类推;
- 一半数据是 0,一半是随机
int值。
评估并验证这些输入数据对本节讨论的算法的性能的影响。
2.1.37 部分有序。编写一个测试用例,生成部分有序的数组,包括:
- 95% 有序,其余部分为随机值;
- 所有的元素和它们的正确位置的距离都不超过 10;
- 5% 的元素随机分布在整个数组中,剩下的数据都是有序的。
评估并验证这些输入数据对本节讨论的算法的性能的影响。
2.1.38 不同类型的元素。编写一个测试用例,生成由多种数据类型元素组成的数组,元素的主键值随机,包括:
- 每个元素的主键均为
String类型(至少长 10 个字符),并含有一个double值; - 每个元素的主键均为
double类型,并含有 10 个String值(每个都至少长 10 个字符); - 每个元素的主键均为
int类型,并含有一个int[20]值
评估并验证这些输入数据对本节讨论的算法的性能的影响。