5.1 字符串排序
对于许多排序应用,决定顺序的键都是字符串。本节中,我们将会考察能够利用字符串的特殊性质将字符串键排序的方法,它们将比第 2 章学过的通用排序方法效率更高。
我们将学习两类完全不同的字符串排序方法。它们都是为程序员服务了几十年的强大方法。
第一类方法会从右到左检查键中的字符。这种方法一般被称为低位优先(Least-Significant-Digit First,LSD)的字符串排序。使用 数字(digit)代替 字符(character)的原因要追溯到相同方法在各种数字类型中的应用。如果将一个字符串看作一个 256 进制的数字,那么从右向左检查字符串就等价于先检查数字的最低位。这种方法最适合用于键的长度都相同的字符串排序应用。
第二类方法会从左到右检查键中的字符,首先查看的是最高位的字符。这些方法通常称为高位优先(MSD)的字符串排序——本节将会学习两种此类算法。高位优先的字符串排序的吸引人之处在于,它们不一定需要检查所有的输入就能够完成排序。高位优先的字符串排序和快速排序类似,因为它们都会将需要排序的数组切分为独立的部分并递归地用相同的方法处理子数组来完成排序。它们的区别之处在于高位优先的字符串排序算法在切分时仅使用键的第一个字符,而快速排序的比较则会涉及键的全部。要学习的第一种方法会为每个字符创建一个切分,第二种方法则总会产生三个切分,分别对应被搜索键的第一个字符小于、等于或大于切分键的第一个字符的情况。
在分析字符串排序算法时,字母表的大小是一个重要的因素。尽管我们的重点是基于扩展的 ASCII 字符集的字符串( ),但也会分析来自较小字母表的字符串(例如基因序列)和来自较大字母表的字符串(例如含有 65 536 个字符的 Unicode 字母表,它是自然语言编码的国际标准)。
5.1.1 键索引计数法
作为热身,我们先学习一种适用于小整数键的简单排序方法。这种叫做 键索引计数 的方法本身就很实用,同时也是本节中将要学习的三种字符串排序算法中两种的基础。
老师在统计学生的分数时可能会遇到以下数据处理问题。学生被分为若干组,标号为 1、2、3 等。在某些情况下,我们希望将全班同学按组分类。因为组的编号是较小的整数,使用键索引计数法来排序是很合适的,请见图 5.1.1。为了说明这种方法,假设数组 a[] 中的每个元素都保存了一个名字和一个组号,其中组号在 0 到 R-1 之间,代码 a[i].key() 会返回指定学生的组号。这种方法有 4 个步骤,我们会依次讲解。
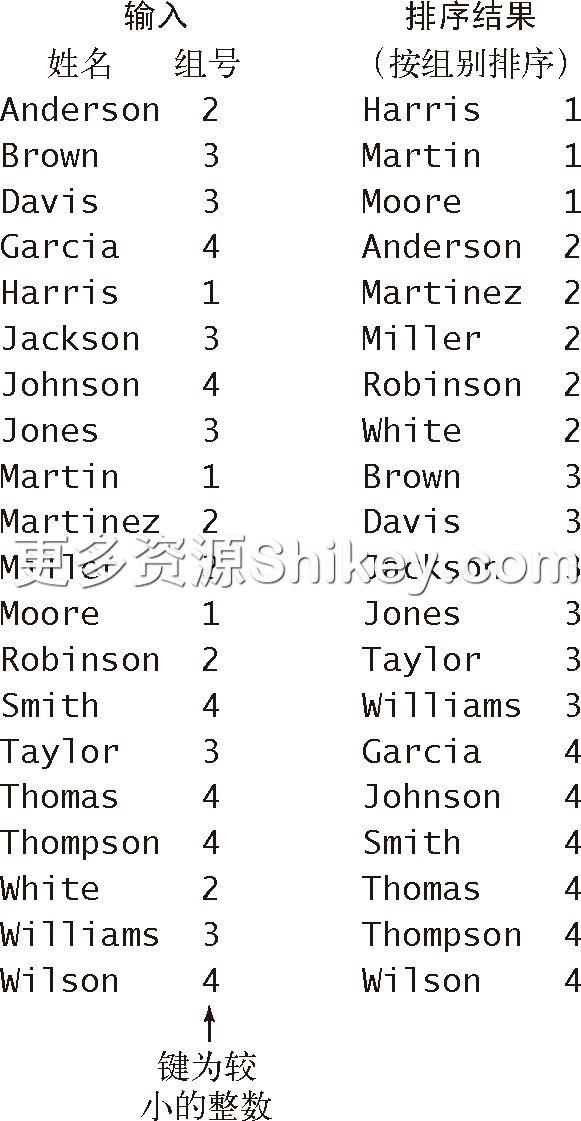
图 5.1.1 适于使用键索引计数法的典型情况
5.1.1.1 频率统计
第一步就是使用 int 数组 count[] 计算每个键出现的频率。对于数组中的每个元素,都使用它的键访问 count[] 中的相应元素并将其加 1。如果键为 r,则将 count[r+1] 加 1。(为什么需要加 1 ?这么做的原因到下一步你就会明白了。)在图 5.1.2 的例子中,首先将 count[3] 加 1,因为 Anderson 在第二组中,然后会将 count[4] 加 2,因为 Brown 和 Davis 都在第三组中,如此继续。注意, count[0] 的值总是 0,在这个示例中 count[1] 的值也为 0(第零组中没有学生)。
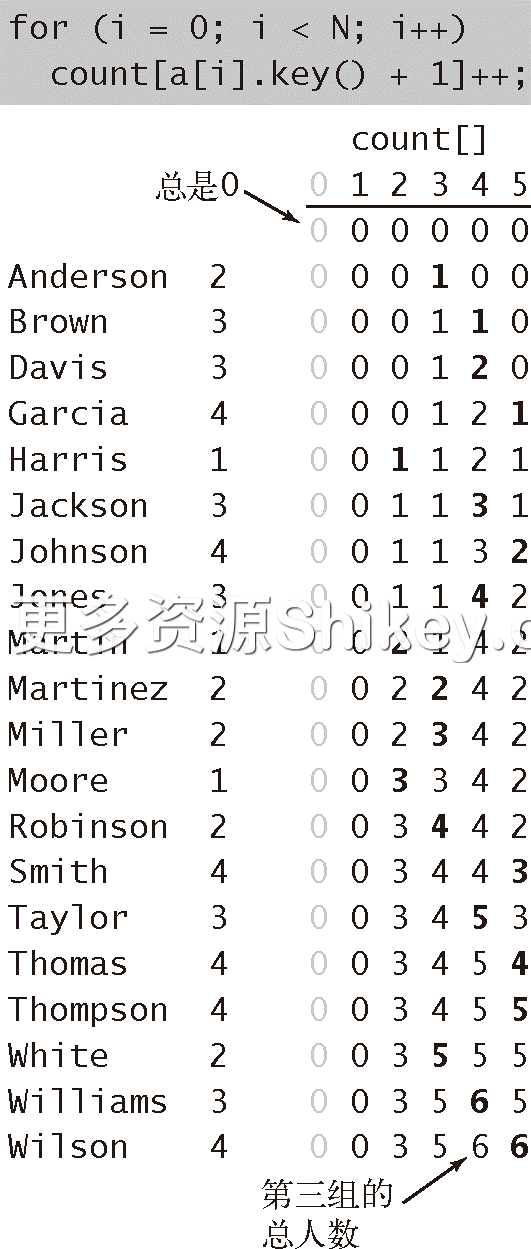
图 5.1.2 计算出现频率
5.1.1.2 将频率转换为索引
接下来,我们会使用 count[] 来计算每个键在排序结果中的起始索引位置。在这个示例中,因为第一组中有 3 个人,第二组中有 5 个人,因此第三组中的同学在排序结果数组中的起始位置为 8。一般来说,任意给定的键的起始索引均为所有较小的键所对应的出现频率之和。对于每个键值 r,小于 r+1 的键的频率之和为小于 r 的键的频率之和加上 count[r],因此从左向右将 count[] 转化为一张用于排序的索引表是很容易的(请见图 5.1.3)。
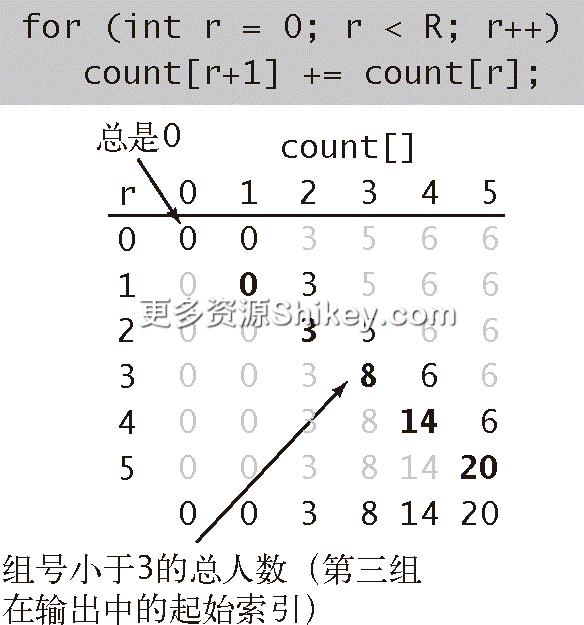
图 5.1.3 将频率转换为起始索引
5.1.1.3 数据分类
在将 count[] 数组转换为一张索引表之后,将所有元素(学生)移动到一个辅助数组 aux[] 中以进行排序。每个元素在 aux[] 中的位置是由它的键(组别)对应的 count[] 值决定,在移动之后将 count[] 中对应元素的值加 1,以保证 count[r] 总是下一个键为 r 的元素在 aux[] 中的索引位置。这个过程只需遍历一遍数据即可产生排序结果,如图 5.1.4 所示。 注意:在我们的一个应用中,这种实现方式的稳定性是很关键的——键相同的元素在排序后会被聚集到一起,但相对顺序没有变化,请见图 5.1.5。
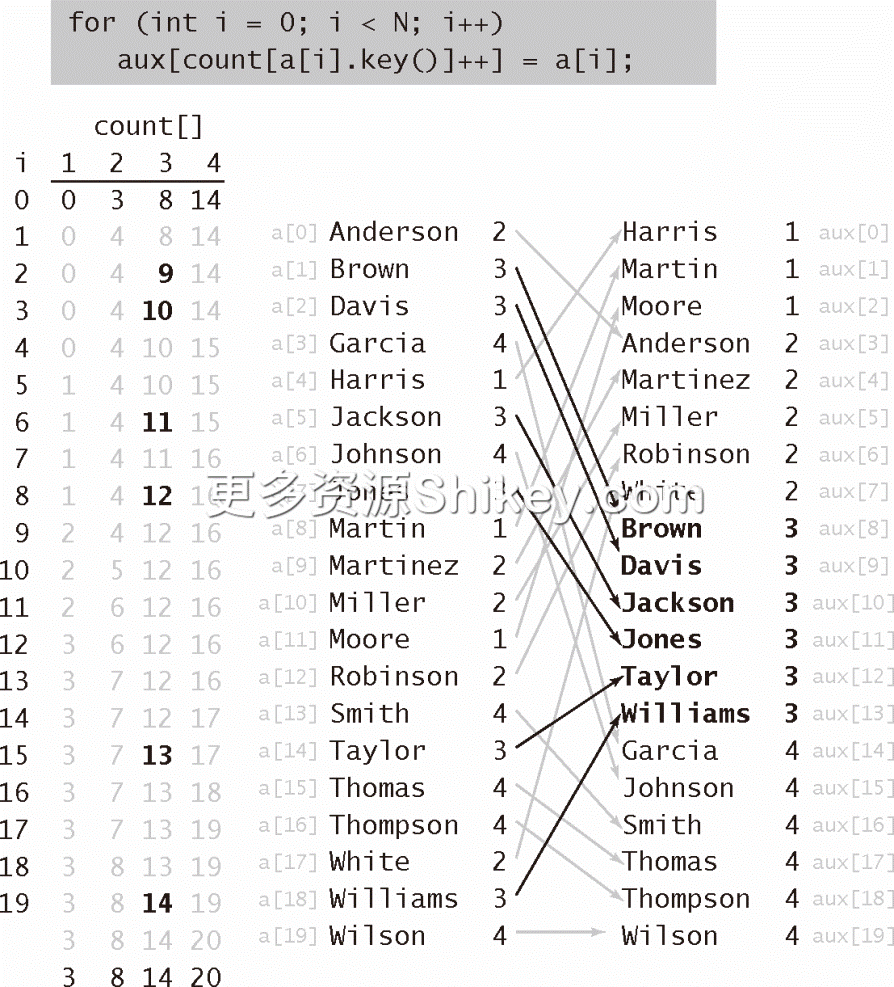
图 5.1.4 将数据分类(键为 3 的条目均突出显示)
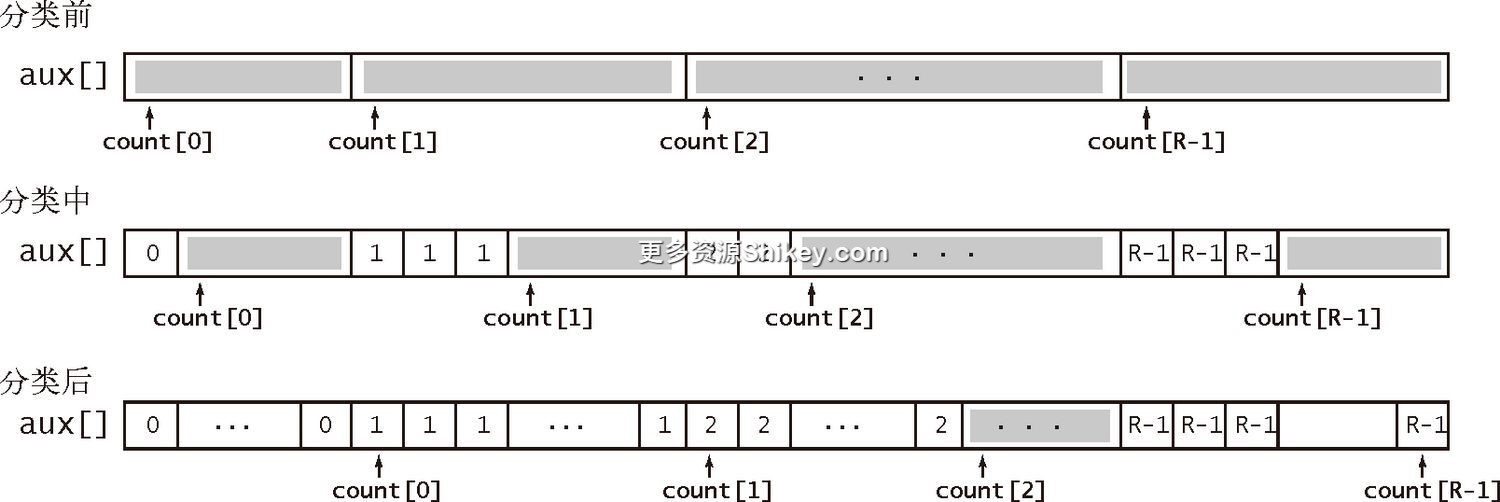
图 5.1.5 键索引计数法(分类阶段)
5.1.1.4 回写
因为我们在将元素移动到辅助数组的过程中完成了排序,所以最后一步就是将排序的结果复制回原数组中。
命题 A。键索引计数法排序
个键为 0 到
之间的整数的元素需要访问数组
次。
证明。根据代码可得,初始化数组会访问数组
次。在第一次循环中,
次);第二次循环会进行
次加法(访问数组
次);第三次循环会使计数器的值增大
次);第四次循环会移动数据
键索引计数法是一种对于小整数键排序非常有效却常常被忽略的排序方法。理解它的工作原理是理解字符串排序的第一步。命题 A 意味着键索引计数法突破了  的排序算法运行时间下限(之前已经证明过)。它是怎么做到的呢?2.2 节中的命题 I 证明的是所需的 比较次数 的下限(只能通过
compareTo() 访问数据)——键索引计数法不需要比较(它只通过 key() 方法访问数据)。只要当 在 的一个常数因子范围之内,它都是一个线性时间级别的排序方法。
int N = a.length;
String[] aux = new String[N];
int[] count = new int[R+1];
// 计算出现频率
for (int i = 0; i < N; i++)
count[a[i].key() + 1]++;
// 将频率转换为索引
for (int r = 0; r < R; r++)
count[r+1] += count[r];
// 将元素分类
for (int i = 0; i < N; i++)
aux[count[a[i].key()]++] = a[i];
// 回写
for (int i = 0; i < N; i++)
a[i] = aux[i];键索引计数法( a[].key() 为 [0,R) 之间的一个整数)
5.1.2 低位优先的字符串排序
我们学习的第一个字符串排序算法叫做 低位优先(LSD)的字符串排序。考虑以下应用:假设有一位工程师架设了一个设备来记录给定时间段内某条忙碌的高速公路上所有车辆的车牌号,他希望知道总共有多少辆 不同 的车辆经过了这段高速公路。根据 2.1 节你可以知道,解决这个问题的一种简单方法就是将所有车牌号排序,然后遍历并找出所有不同的车牌号的数量,如 Dedup 所示(请见 3.5.2.1 节框注“ Dedup 过滤器”)。车牌号由数字和字母混合组成,因此一般都将它们表示为字符串。在最简单的情况中(例如图 5.1.6 所示的加利福尼亚州的车牌号),这些字符串的长度都是相同的。这种情况在排序应用中很常见——比如电话号码、银行账号、IP 地址等都是典型的定长字符串。
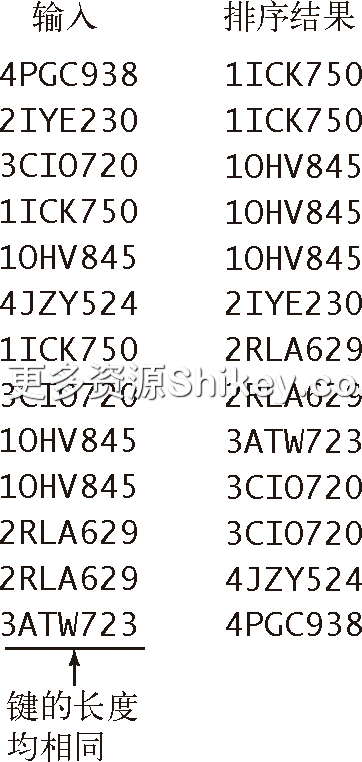
图 5.1.6 适于使用低位优先的字符串排序算法的典型情况
将此类字符串排序可以通过键索引计数法来完成,如算法 5.1(LSD)和其下方的例子所示。如果字符串的长度均为  ,那就从右向左以每个位置的字符作为键,用键索引计数法将字符串排序 遍。乍一看你很难相信这种方法能够产生一个有序的数组——事实上,除非键索引计数法是稳定的,否则这种方法是行不通的。在研究以下证明时请记住这一点并参考后面的示例。
命题 B。低位优先的字符串排序算法能够稳定地将定长字符串排序。
证明。该命题完全依赖于键索引计数法的实现是稳定的,这种稳定性已经在命题 A 中指出了。在将它们的最后
i个字符作为键(用稳定的方式)进行排序之后,可以知道,任意两个键在数组中的顺序都是正确的(只考虑这些字符)。要么因为它们的倒数第i个字符不同,所以排序方法已经将它们的顺序摆放正确;要么它们的倒数第i个字符相同,所以由于排序的稳定性它们仍然有序(由归纳法可知,对于i-1这一点仍然正确)。
算法 5.1 低位优先的字符串排序
public class LSD { public static void sort(String[] a, int W) { // 通过前W个字符将a[]排序 int N = a.length; int R = 256; String[] aux = new String[N]; for (int d = W-1; d >= 0; d--) { // 根据第d个字符用键索引计数法排序 int[] count = new int[R+1]; // 计算出现频率 for (int i = 0; i < N; i++) count[a[i].charAt(d) + 1]++; for (int r = 0; r < R; r++) // 将频率转换为索引 count[r+1] += count[r]; for (int i = 0; i < N; i++) // 将元素分类 aux[count[a[i].charAt(d)]++] = a[i]; for (int i = 0; i < N; i++) // 回写 a[i] = aux[i]; } } }要将每个元素均为含有
W个字符的字符串数组a[]排序,要进行W次键索引计数排序:从右向左,以每个位置的字符为键排序一次。
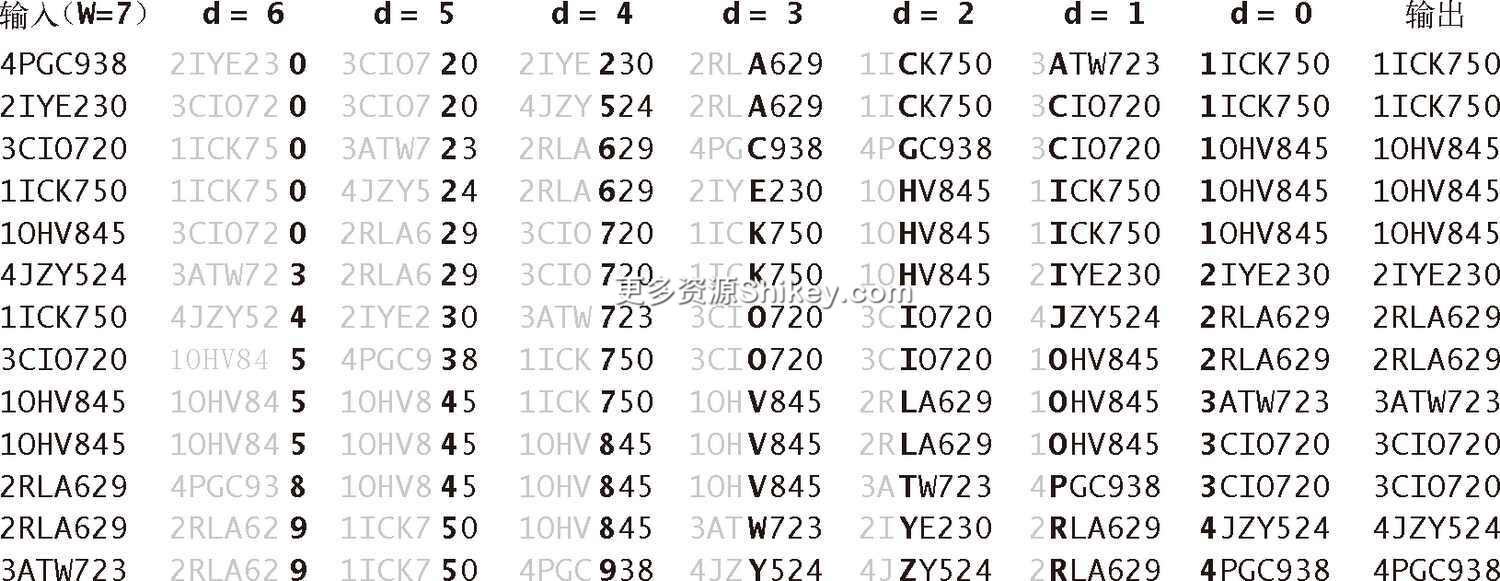
证明该命题的另一种方法是向前看:如果有两个键,它们中还没有被检查过的字符都是完全相同的,那么键的不同之处就仅限于已经被检查过的字符。因为两个键已经被排序过,所以出于稳定性它们将一直保持有序。另外,如果还没被检查过的部分是不同的,那么已经被检查过的字符对于两者的最终顺序没有意义,之后的某轮处理会根据更高位字符的不同修正这对键的顺序。
老式的卡片打孔排序机使用的就是低位优先的基数排序法。这类机器开发于 20 世纪初期,比用计算机处理商业数据的时代早了数十年。这种机器能够根据卡片上被选定列中孔的模式将一组卡片分别放入 10 个盒子中。如果多个数字被打在这组卡片的多个列上,操作员将所有卡片排序的方法就是先根据最右边的数字排序,然后将所有卡片按照顺序叠好并再次根据倒数第二个数字排序,如此这般直到排序第一个数字为止。将所有已被排序的卡片按顺序再次叠放就是一个稳定的过程,键索引计数法模仿了这个过程。在整个 20 世纪 70 年代,这个版本的低位优先基数排序法不仅在商业领域非常重要,许多严谨的程序员(和学生!)也使用它,因为他们需要将程序保存在打了孔的卡片上(每张卡片上一行)并且会在一组完整表示某个程序的卡片的最后几列打上序号,这样即使卡片散乱之后也能将它们重新按顺序排列。这也是一种将扑克牌排序的简洁方法:将所有牌(按大小)分成 13 堆,按顺序从 13 堆排中抽取同种花色的扑克牌,最后将 13 堆排(按花色)变为 4 堆。分牌的过程是稳定的,因此花色中的牌也是有序的,所以按照花色将这 4 堆牌合并即可得到一副已排序的扑克牌,请见图 5.1.7。
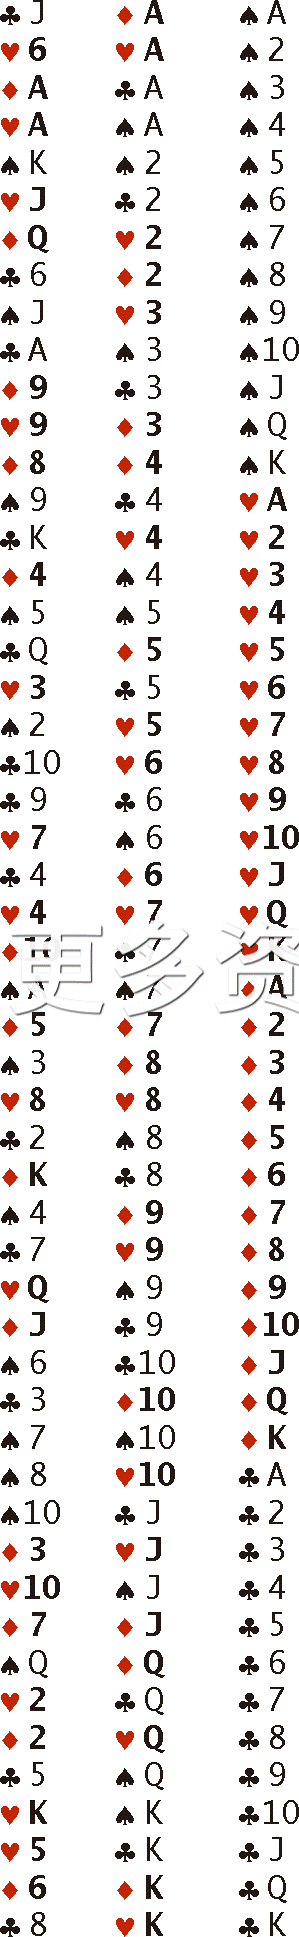
图 5.1.7 用低位优先的字符串排序算法将一副扑克牌排序
在许多字符串排序的应用中(甚至对于某些州的车牌号),键的长度可能互不相同。改进后的低位优先的字符串排序是可以适应这些情况的,但我们将这个任务留作练习,因为下面将学习两种专门处理变长键排序的算法。
从理论上说,低位优先的字符串排序的意义重大,因为它是一种适用于一般应用的 线性 时间排序算法。无论 有多大,它都只遍历 次数据。具体描述如下。
命题 B(续)。对于基于
次数组,使用的额外空间与
成正比。
证明。该方法等价于进行
aux[]只会被初始化一次。根据前面的代码和命题 A 即可得到算法访问数组和使用空间的总数。
对于典型的应用, 远小于 ,因此命题 B 说明算法的总运行时间与  成正比。 个长为 的字符串的输入总共含有 个字符,因此低位优先的字符串排序的运行时间与输入的规模成正比。
5.1.3 高位优先的字符串排序
要实现一个通用的字符串排序算法(字符串的长度不一定相同),我们应该考虑从左向右遍历所有字符。我们知道,以 a 开头的字符串应该排在以 b 开头的字符串前面,等等。实现这种思想的一个很自然方法就是一种递归算法,被称为 高位优先(MSD)的字符串排序,请见图 5.1.8。首先用键索引计数法将所有字符串按照首字母排序,然后(递归地)再将每个首字母所对应的子数组排序(忽略首字母,因为每一类中的所有字符串的首字母都是相同的)。和快速排序一样,高位优先的字符串排序会将数组切分为能够独立排序的子数组来完成排序任务,但它的切分会为每个首字母得到一个子数组,而不是像快速排序中那样产生固定的两个或三个切分,请见图 5.1.9。
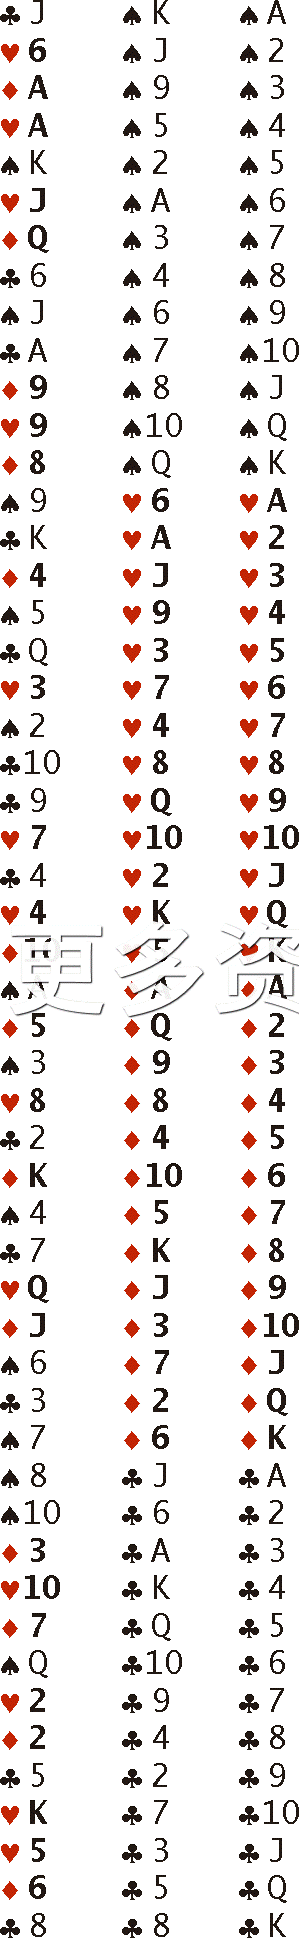
图 5.1.8 用高位优先的字符串排序算法将一副扑克牌排序
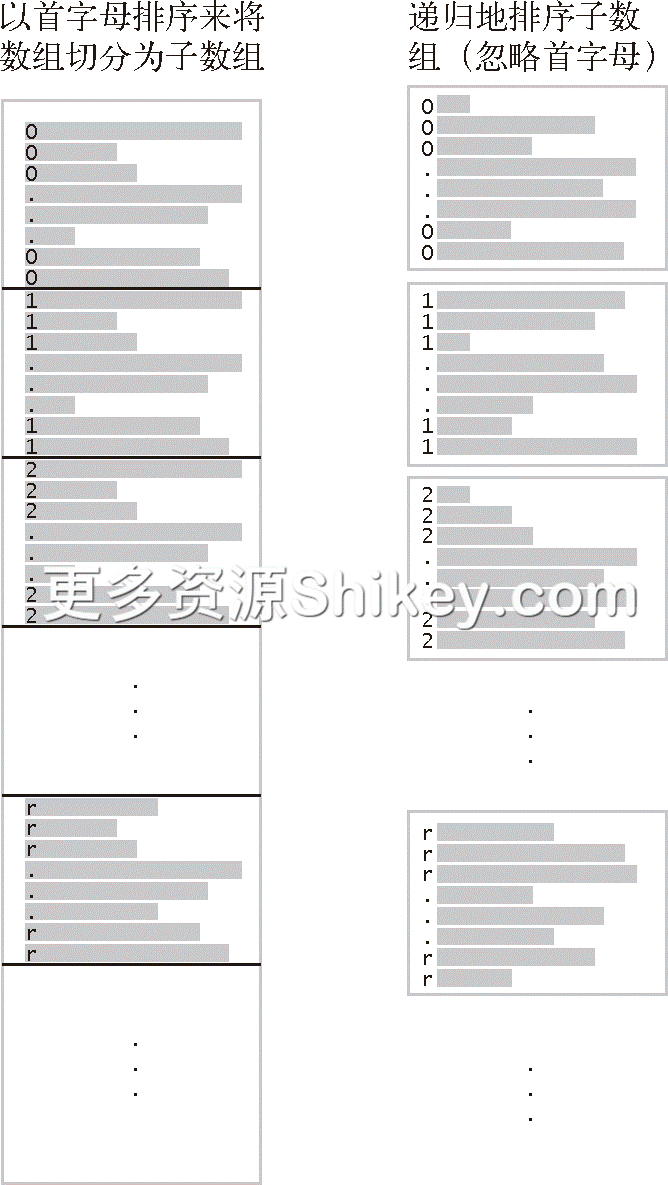
图 5.1.9 高位优先的字符串排序的示意图
5.1.3.1 对字符串末尾的约定
在高位优先的字符串排序算法中,要特别注意到达字符串末尾的情况。在排序中,合理的做法是将所有字符都已被检查过的字符串所在的子数组排在所有子数组的前面,这样就不需要递归地将该子数组排序,请见图 5.1.10。为了简化这两步计算,我们使用了一个接受两个参数的私有方法 toChar() 来将字符串中字符索引转化为数组索引,当指定的位置超过了字符串的末尾时该方法返回 -1。然后将所有返回值加 1,得到一个非负的 int 值并用它作为 count[] 的索引。这种转换意味着字符串中的每个字符都可能产生 R+1 中不同的值:0 表示 字符串的结尾,1 表示字母表的第一个字符,2 表示字母表的第二个字符,等等。因为键索引计数法本来就需要一个额外的位置,所以使用代码 int count[] = new int[R+2];创建记录统计频率的数组(将所有值设为 0)。 注意:某些编程语言,特别是 C 和 C++,已经约定了字符串结束的表示方法,因此对于这类语言本节的代码需要进行相应的调整。
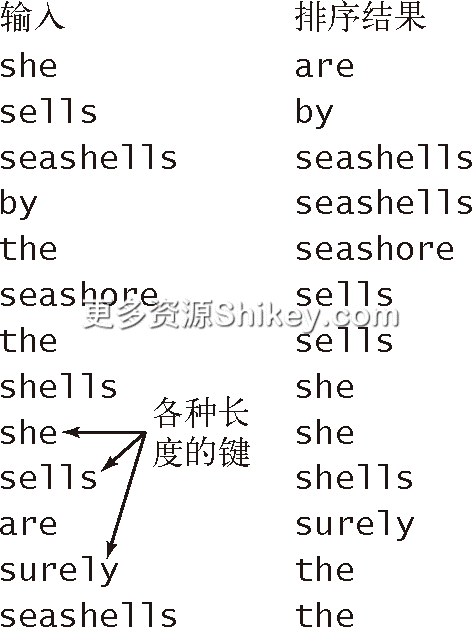
图 5.1.10 适于使用高位优先的字符串排序的典型情况
有了这些预备知识,就会知道算法 5.2 实现高位优先的字符串排序算法所需的新代码其实并不多。增加了一个条件语句以在子数组较小时切换插入排序,(这里使用的是一个特殊版本的插入排序,我们会在稍后考察。)还添加了一个键索引计数法的循环来完成递归调用。从表 5.1.1 可知, count[] 数组中的值(在统计频率、转换为索引并将数据分类之后)正是将每个字符所对应的子数组(递归地)排序时所需要的值。
表 5.1.1 高位优先的字符串排序中 count[] 数组的意义
第 d 个字符排序的完成阶段count[r] 的值r=0``r=1``r 在 2 与 R-1 之间r=R``r=R+1频率统计0(未使用)长度为 d 的字符串数量第 d 个字符的索引值是 r-2 的字符串的数量将频率转化为索引长度为 d 的字符串的子数组的起始索引第 d 个字符的索引值是 r-1 的字符串的子数组的起始索引未使用数据分类第 d 个字符的索引值为 r 的字符串的子数组的起始索引未使用1+ 长度为 d 的字符串的子数组的结束索引1+ 第 d 个字符串的索引值是 r-1 的字符串的子数组的结束索引未使用
5.1.3.2 指定的字母表
高位优先的字符串排序的成本与字母表中的字符数量有很大关系。我们可以很容易地令排序算法修接受一个 Alphabet 对象作为参数,以改进基于较小的字母表的字符串排序程序的性能。完成这一点需要进行如下改动:
- 在构造函数中用一个
alpha对象保存字母表; - 在构造函数中将
R设为alpha.R(); - 在
charAt()方法中将s.charAt(d)替换为alpha.toIndex(s.charAt(d))。
在本节的示例中,字符串都是由小写字母组成的。扩展低位优先的字符串排序算法以支持这种特性也很简单,但带来的性能提升一般比高位优先的字符串排序小得多。
算法 5.2 高位优先的字符串排序
public class MSD { private static int R = 256; // 基数 private static final int M = 15; // 小数组的切换阈值 private static String[] aux; // 数据分类的辅助数组 private static int charAt(String s, int d) { if (d < s.length()) return s.charAt(d); else return -1; } public static void sort(String[] a) { int N = a.length; aux = new String[N]; sort(a, 0, N-1, 0); } private static void sort(String[] a, int lo, int hi, int d) { // 以第d个字符为键将a[lo]至a[hi]排序 if (hi <= lo + M) { Insertion.sort(a, lo, hi, d); return; } int[] count = new int[R+2]; // 计算频率 for (int i = lo; i <= hi; i++) count[charAt(a[i], d) + 2]++; for (int r = 0; r < R+1; r++) // 将频率转换为索引 count[r+1] += count[r]; for (int i = lo; i <= hi; i++) // 数据分类 aux[count[charAt(a[i], d) + 1]++] = a[i]; for (int i = lo; i <= hi; i++) // 回写 a[i] = aux[i - lo]; // 递归的以每个字符为键进行排序 for (int r = 0; r < R; r++) sort(a, lo + count[r], lo + count[r+1] - 1, d+1); } }在将一个字符串数组
a[]排序时,首先根据它们的首字母用键索引计数法进行排序,然后(递归地)根据子数组中的字符串的首字母将子数组排序。
算法 5.2 中的代码的简洁令人刮目相看,它隐藏了一些非常复杂的计算。花些时间深入研究图 5.1.11 所示的算法顶层调用轨迹和图 5.1.12 中递归调用的轨迹以确保你理解了这个算法的精妙之处,这些时间不会白花。在这段轨迹中,小数组的插入排序切换阈值( M)为 0,因此你可以看到完整的排序过程。在这个例子中,字符串来自于 Alphabet.LOWERCASE,其中  。一般的应用使用的大都是 的
Alphabet.EXTENDED_ASCII,或是  的
Alphabet.UNICODE16。对于较大的字母表,高位优先的排序算法虽然简单但可能会很危险——如果使用不当,它可能会消耗令人无法承受的时间和空间。在仔细研究它的性能特点之前,我们要先讨论三个在任何应用中都必须解决的重要的问题(这些问题曾在第 2 章中讨论过)。
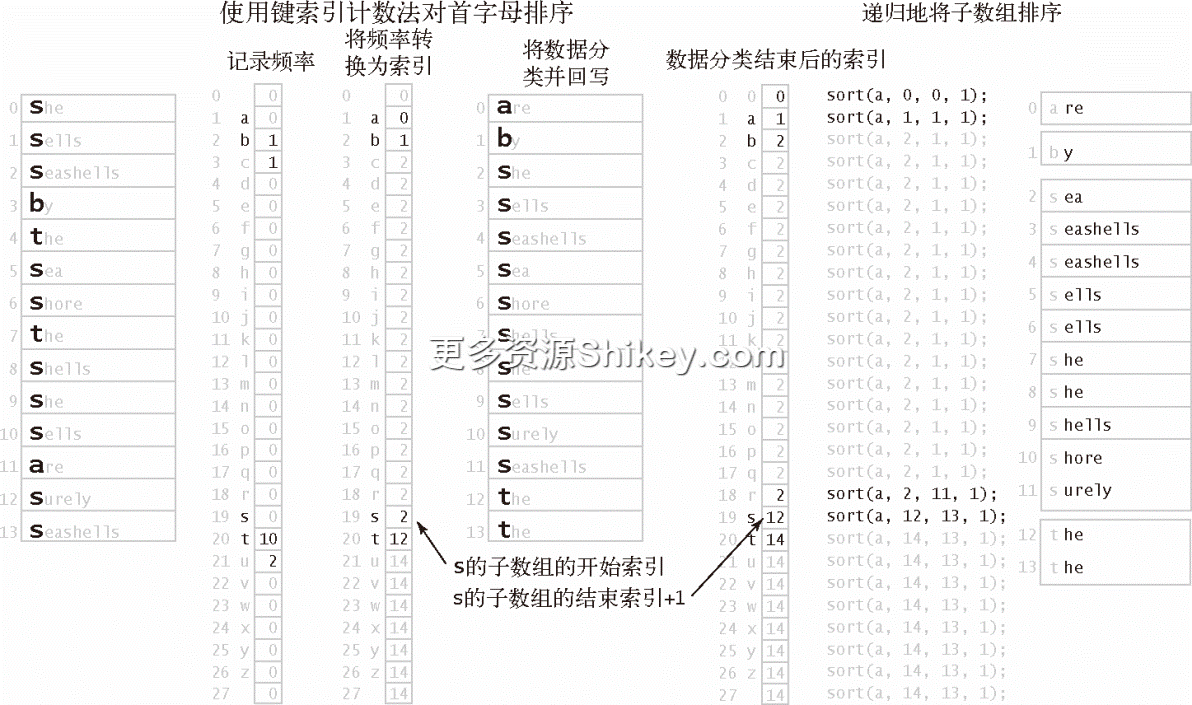
图 5.1.11 高位优先的字符串排序: sort(a, 0, 14, 0) 的顶层轨迹
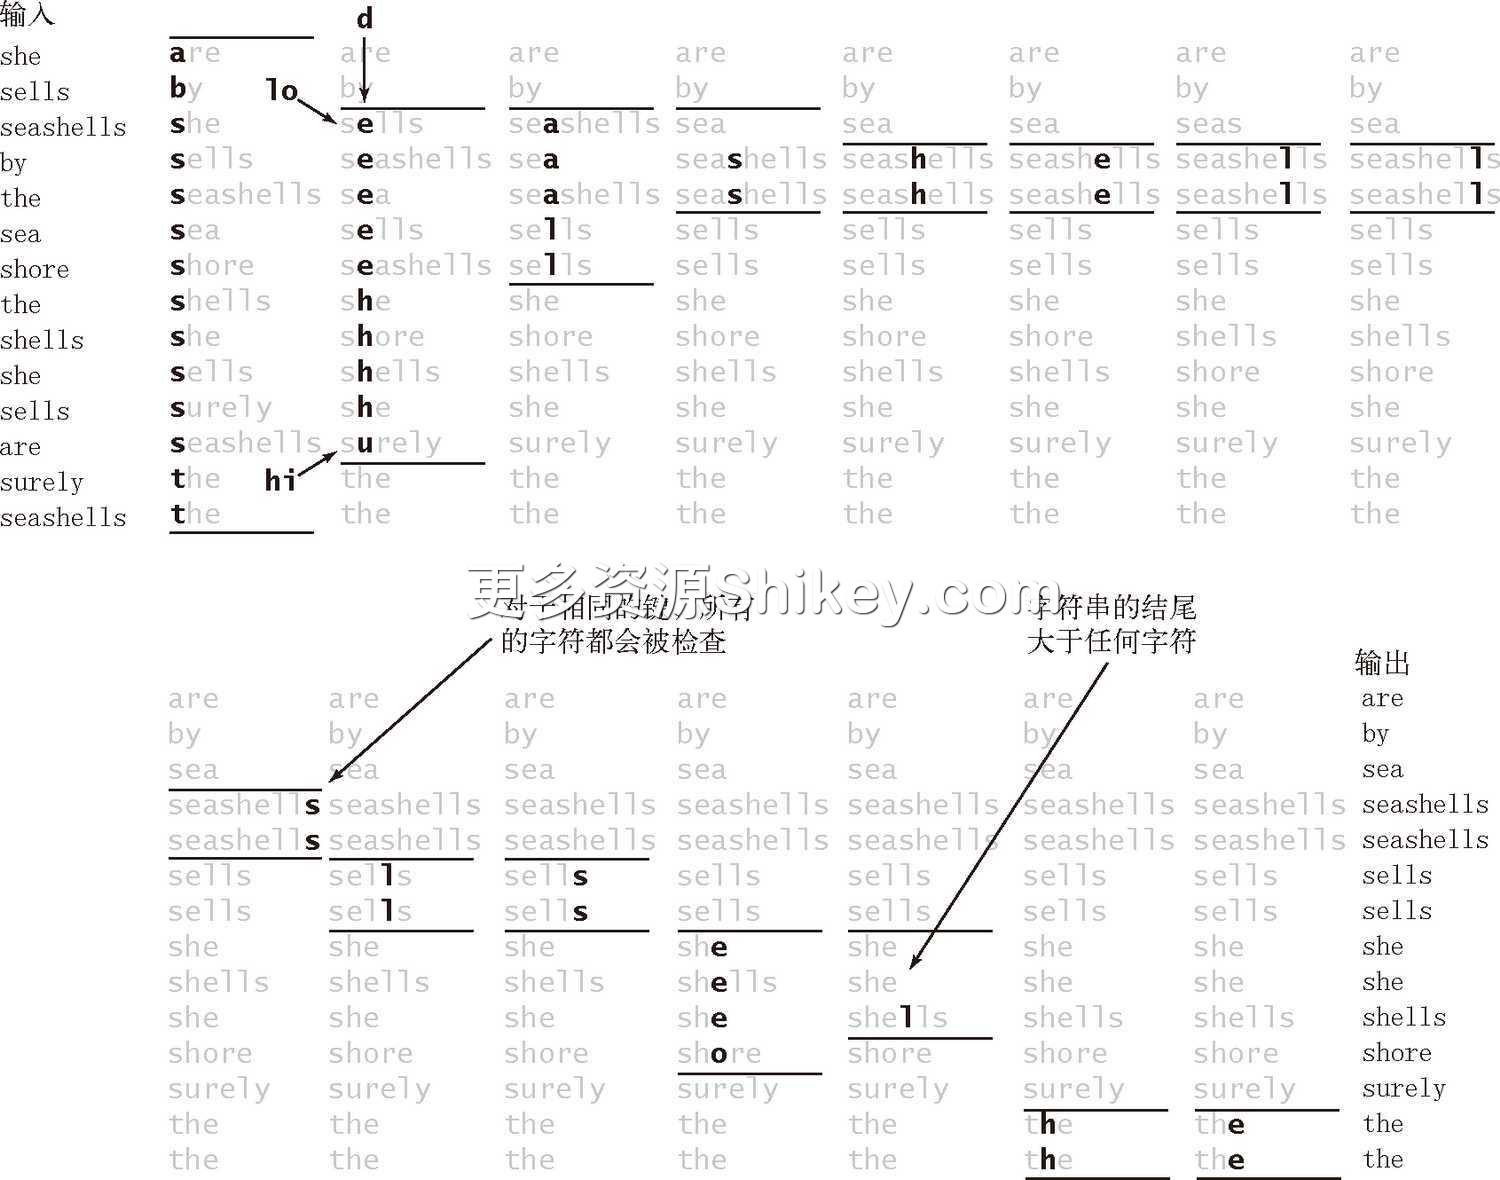
图 5.1.12 高位优先的字符串排序的递归调用轨迹(小数组不会切换到插入排序,大小为 0 和 1 的子数组已被省略)
5.1.3.3 小型子数组
高位优先的字符串排序的基本思想是很有效的:在一般的应用中,只需检查若干个字符就能完成所有字符串的排序。换句话说,这种方法能够快速地将需要排序的数组切分为较小的数组。但这种切分也是一把双刃剑:我们肯定会需要处理大量微型数组,因此必须快速处理它们。 小型子数组对于高位优先的字符串排序的性能至关重要。我们在其他递归排序算法中也遇到过这种情况(快速排序和归并排序),但小数组对于高位优先的字符串排序的影响尤其强烈。例如,假设你需要将数百万个不同的 ASCII 字符串()排序且不会对小数组进行特殊处理。每个字符串最终都会产生一个只含有它自己的子数组,因此你需要将数百万个大小为 1 的子数组排序。但每次排序都需要将 count[] 的 258 个元素初始化为 0 并将它们都转化为索引。这种代价比排序的其他部分要高很多。在使用 Unicode 时(),排序过程可能会减慢 上千 倍。事实上,正因为如此,许多使用排序但考虑不周的程序在从 ASCII 切换到 Unicode 后运行时间从几分钟暴涨到几个小时。因此,将小数组切换到插入排序对于高位优先的字符串排序算法是 必须 的。为了避免重复检查已知相同的字符所带来的成本,我们使用了后面框注“对前 d 个字符均相同的字符串执行插入排序”中给出的一个版本的插入排序。它接受一个额外的参数 d 并假设所有需要排序的字符串的前 d 个字符都是相同的。这段代码的效率取决于 substring() 方法所需的时间是否为常数。和快速排序以及归并排序一样,一个较小的转换阈值就能将性能提高很多,但对于高位优先的字符串排序算法它节约的时间是非常可观的。图 5.1.13 显示了一个典型应用中的实验结果。在长度小于等于 10 时将子数组切换到插入排序能够将运行时间降低为原来的十分之一。
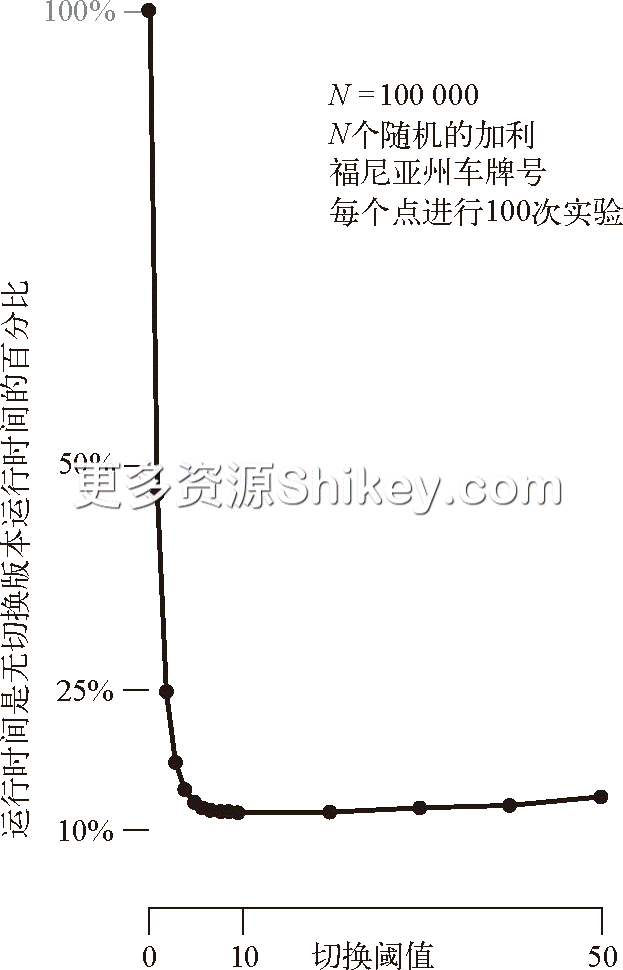
图 5.1.13 高位优先的字符串排序算法中切换小型子数组的排序方法的实际效果
5.1.3.4 等值键
高位优先的字符串排序中的第二个陷阱是,对于含有大量等值键的子数组的排序会较慢。如果相同的子字符串出现得过多,切换排序方法条件将不会出现,那么递归方法就会检查所有相同键中的每一个字符。另外,键索引计数法无法有效判断字符串中的字符是否全部相同:它不仅需要检查每个字符和移动每个字符串,还需要初始化所有的频率统计并将它们转换为索引等。因此,高位优先的字符串排序的最坏情况就是所有的键均相同。大量含有相同前缀的键也会产生同样的问题,这在一般的应用场景中是很常见的。
5.1.3.5 额外空间
为了进行切分,高位优先的算法使用了两个辅助数组:一个用来将数据分类的临时数组( aux[])和一个用来保存将会被转化为切分索引的统计频率的数组( count[])。 aux[] 的大小为 且可以在递归方法 sort() 外创建。如果牺牲稳定性,则可以去掉 aux[] 数组(请见练习 5.1.17),但它并不是高位优先的字符串排序算法在实际应用中所关注的内容。相反, count[] 所需的空间才是主要问题(因为它不能在递归方法 sort() 之外创建),如下文的命题 D 所述。
public static void sort(String[] a, int lo, int hi, int d)
{ // 从第d个字符开始对a[lo]到a[hi]排序
for (int i = lo; i <= hi; i++)
for (int j = i; j > lo && less(a[j], a[j-1], d); j--)
exch(a, j, j-1);
}
private static boolean less(String v, String w, int d)
{ return v.substring(d).compareTo(w.substring(d)) < 0; }对前 d 个字符均相同的字符串执行插入排序
5.1.3.6 随机字符串模型
为了研究高位优先的字符串排序算法的性能,我们使用了一个 随机字符串模型,其中每个字符串都(独立的)由随机字符组成,长度没有限制。这实际上排除了出现较长的等值键的情况,因为它们出现的几率非常小。高位优先的字符串排序算法在这个模型中的表现和随机定长键模型中的表现类似,也和它在一般的真实数据中的性能类似。我们将会看到,在这三种情况中,高位优先的字符串排序算法通常都只需要检查每个键开头的若干个字符即可。
5.1.3.7 性能
高位优先的字符串排序算法的性能取决于数据。对于基于比较的方法,我们主要关注的是键的 顺序;对于高位优先的字符串排序算法,键的顺序并不重要,我们关注的是键所对应的值,请见图 5.1.14。
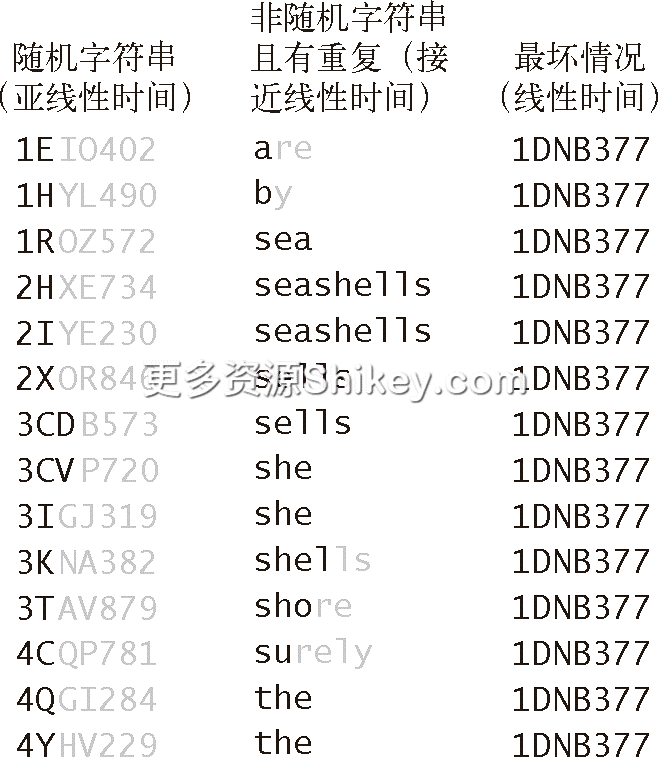
图 5.1.14 高位优先的字符串排序算法的
- 对于 随机 输入,高位优先的字符串排序算法只会检查足以区别字符串所需的字符。相对于输入数据中的字符总数,算法的运行时间是 亚线性 的(它只会检查输入字符中的一小部分)。
- 对于 非随机 的输入,高位优先的字符串排序算法可能仍然是亚线性的,但需要检查的字符可能比随机情况下更多。特别是对于相等的键,它需要检查它们的所有字符,所以当存在大量等值键时它所需的运行时间是接近线性的。
- 在 最坏 情况下,高位优先的字符串排序算法会检查所有键中的所有字符,所以相对于数据中的所有字符它所需的运行时间是线性的(和低位优先的字符串排序算法相同)。最坏情况下的输入中所有的字符串均相同。
某些应用程序所处理的键和随机字符串模型能很好匹配,而有些则含有很多重复的键或是较长的公共前缀,这种情况下排序所需的时间和最坏情况接近。比如,在我们的车牌号处理应用程序中这两种极端情况都可能出现:如果工程师选取一条繁忙的州际公路一小时的数据,那么数据中的重复项会很少,符合随机模型;如果取的是一条乡间小道一个星期的数据,那么数据中肯定会有大量的重复项,算法的性能将会和最坏情况类似。
命题 C。要将基于大小为
个字符。
简略证明。我们希望子数组的大小几乎都是相同的,因此递推关系
可以近似地描述算法的性能并得到命题所述的结果。它也是第 2 章中快速排序性能证明的一般化证明。另一方面,这种描述并不完全准确,因为
并不一定能够得到整数,子数组的大小相同也仅是平均而言(而且在现实中键的长度是有限的)。这些因素对高位优先的字符串排序算法的影响比对标准快速排序算法的影响小,因此算法运行时间中的最大项就是这个递推关系的答案。这个问题的详细证明是算法分析中的经典例子,最早由 Knuth 完成于 20 世纪 70 年代早期。
作为提示以及对为何该证明已经超出了本书的范围的说明,我在这里提醒大家注意,命题的结论和键的长度是无关的。事实上,随机字符串模型所允许的键长接近无限。两个键之间有任意多的字符相吻合,这个可能性不是零,但这个可能性非常小,在估计性能时可以将其忽略。
由以上讨论可以知道,检查的字符数量并不是高位优先的字符串排序算法性能的全部。我们还需要考虑统计字符的出现频率以及将频率转化为索引所需要的时间和空间。
命题 D。要将基于大小为
到
之间,其中w是字符串的平均长度。
证明。由代码、命题 A 和命题 B 可得,在最好情况下高位优先的排序算法只需遍历数据一轮;而在最坏情况下,它和低位优先的字符串排序算法的性能类似。
当 较小时,是主要因子。尽管对总成本的精确分析是困难而复杂的,但你只需考虑无重复键的情况下所有较小的子数组就可以估计出该成本的实际效果。在不为较小的子数组切换排序方法的情况下,每个键都会产生一个单独的子数组,因此仅为处理这些子数组就需要访问  次数组。如果为小于
 的数组切换排序方法,将会有
 个大小为 的子数组,因此等于是在用
 次比较换取
 次数组访问,这说明应该选择与 的平方根成正比的 。
命题 D(续)。要将基于大小为
证明。
count[]数组必须在sort()中创建,因此空间需求的总量与
正如刚才所讨论的,相等的键使得递归的深度和键的长度成正比。由命题 D 马上可以推论出,在用高位优先的字符串排序算法将基于大型字母表的长字符串排序时,它很有可能消耗过多的时间或者空间,特别是在已知可能出现较长的等值键的情况下。例如,如果使用的是 Alphabet.UNICODE16 且某些字符串中公共前缀的长度超过 1000 个字符,那么 MSD.sort() 将需要为超过 6500 万个计数器元素分配空间!
在将长字符串排序时,令高位优先的字符串排序算法发挥出最大效率的主要挑战在于处理数据中的非随机因素。一般来说,一些键可能存在较长的公共部分,或者部分键的取值范围有限。比如,在处理学生信息的应用程序中,数据的键可能是毕业年份(4 个字节,但只有 4 种可能的值),州名(可能需要 10 个字节,但只有 50 种可能的值),性别(1 个字节,2 种值)以及学生的姓名(和随机字符串最接近,但有可能很长,字母出现频率的分布并不均匀且当该栏长度固定时字符串的末尾会被添加许多空格)。这些限制使得高位优先的字符串排序算法会产生许多空子数组。下面我们将学习一种能够漂亮地解决这个问题的算法。
5.1.4 三向字符串快速排序
我们也可以根据高位优先的字符串排序算法改进快速排序,根据键的首字母进行三向切分,仅在中间子数组中的下一个字符(因为键的首字母都与切分字符相等)继续递归排序。这个算法的实现并不困难,请见算法 5.3:我们只是为算法 2.5 中的递归方法添加了一个参数来保存当前的切分字母并令三向切分的代码使用该字符,然后适当修改递归调用,请见图 5.1.15。
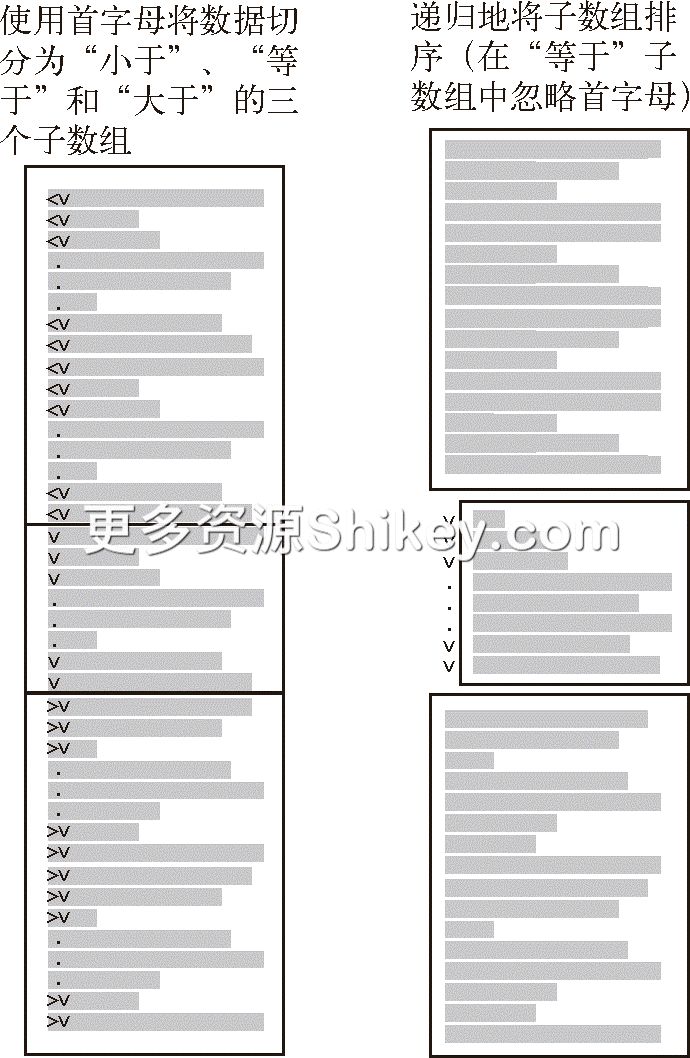
图 5.1.15 三向字符串快速排序的示意图
尽管排序的方式有所不同,但三向字符串快速排序根据的仍然是键的首字母并使用递归方法将其余部分的键排序。对于字符串的排序,这个方法比普通的快速排序和高位优先的字符串排序更友好。实际上,它就是这两种算法的结合。
三向字符串快速排序只将数组切分为三部分,因此当相应的高位优先的字符串排序产生的非空切分较多时,它需要移动的数据量就会变大,因为它需要进行一系列的三向切分才能取得多向切分的效果。但是,高位优先的字符串排序可能会创建大量(空)子数组,而三向字符串快速排序的切分总是只有三个。因此三向字符串快速排序能够很好处理等值键、有较长公共前缀的键、取值范围较小的键和小数组——所有高位优先的字符串排序算法不擅长的各种情况,请见图 5.1.16。特别重要的一点是,这种切分方法能够适应键的不同部分的不同结构。和快速排序一样,三向字符串快速排序也不需要额外的空间(递归所需的隐式栈除外),这是它相比高位优先的字符串排序的一大优点,后者在统计频率和使用辅助数组时都需要空间。
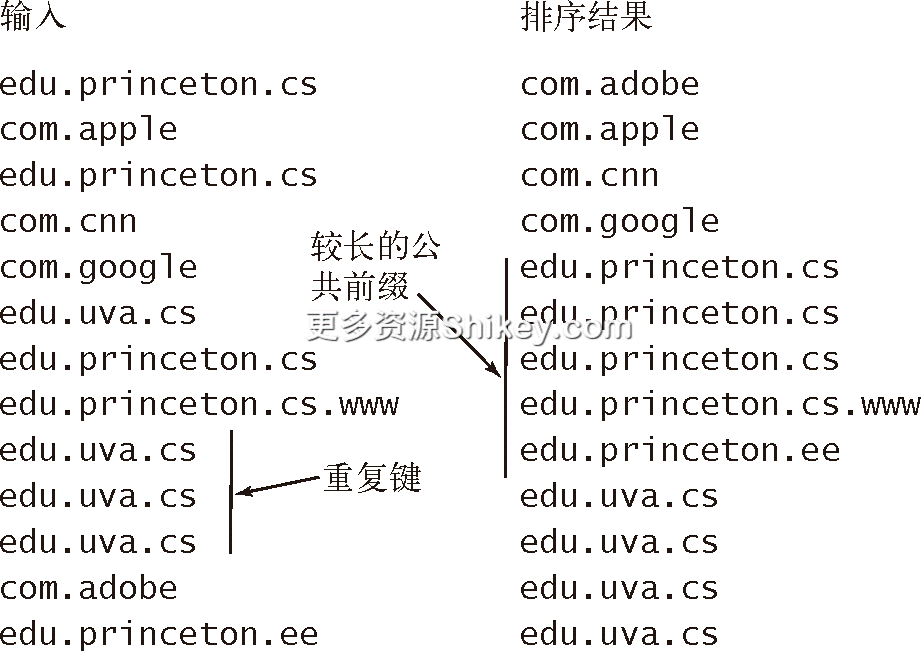
图 5.1.16 适于使用三向字符串快速排序的典型情况
图 5.1.17 显示了 Quick3string 在处理样例数据时产生的所有递归调用。每个子数组都正好只用了三个递归调用就完成了排序,只是省略了中间子数组中到达(相等的)字符串的结尾时的递归调用。
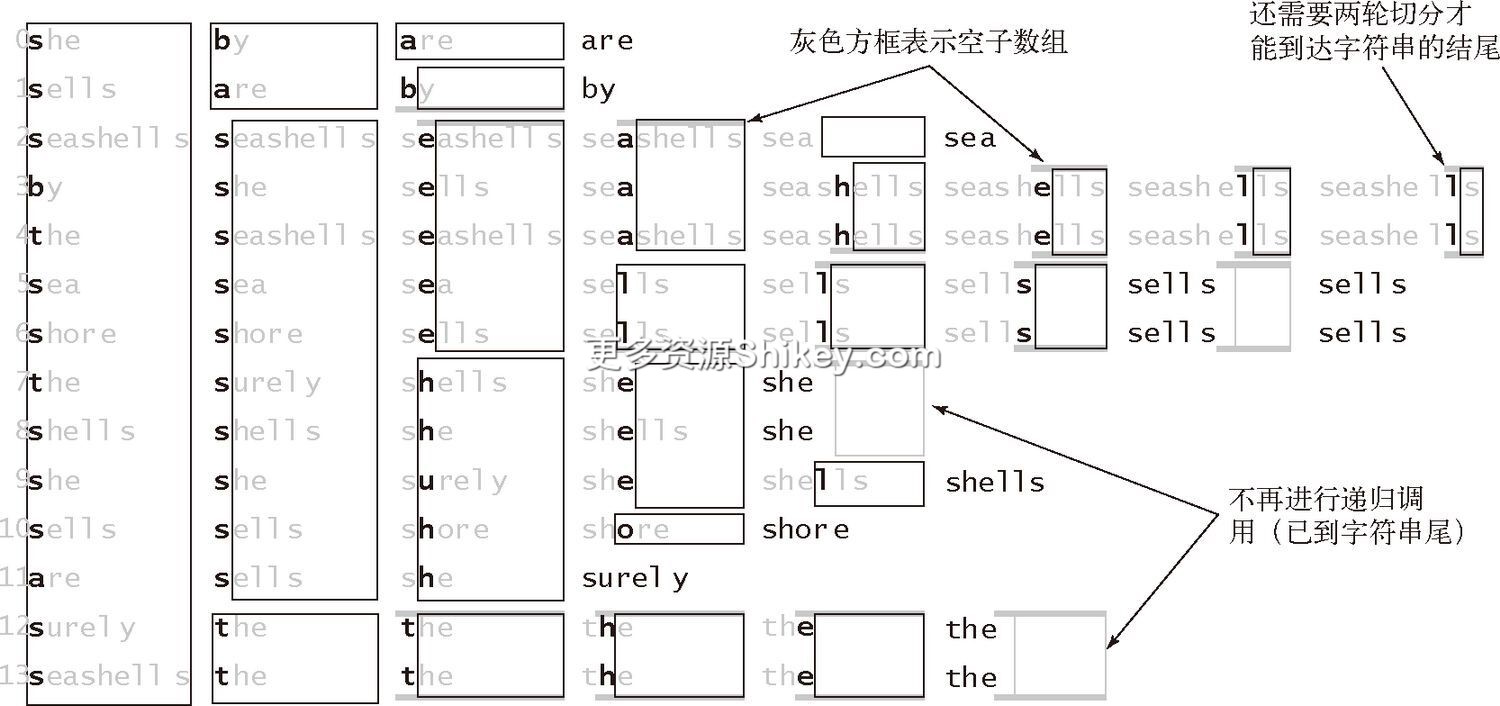
图 5.1.17 三向字符串快速排序的递归调用轨迹(不在子数组较小时切换排序方法)
和以前一样,在实际应用中下列对算法 5.3 的标准改进都是很值得考虑的。
5.1.4.1 小型子数组
在所有的递归算法中,我们都可以通过对小型子数组进行特殊处理来提高效率。这里使用的是 5.1.3.3 小节的框注中的“对前 d 个字符均相同的字符串执行插入排序”中的插入排序,它能够跳过已知相等的字符。这项修改带来的改进会很明显,尽管它在三向字符串排序的重要性远不如它在高位优先的字符串排序的重要性高。
5.1.4.2 有限的字母表
为了处理特殊的字母表,可以为所有方法添加一个 Alphabet 类型的参数 alpha 并在 charAt() 方法中将 s.charAt(d) 替换为 alpha.toIndex(s.charAt(d))。在这里,这么做并不能得到什么收益,相反添加这段代码可能会大幅降低算法的运行速度,因为它在内循环之中。
算法 5.3 三向字符串快速排序
在将字符串数组
a[]排序时,根据它们的首字母进行三向切分,然后(递归地)将得到的三个子数组排序:一个含有所有首字母小于切分字符的字符串子数组,一个含有所有首字母等于切分字符的字符串的子数组(排序时忽略它们的首字母),一个含有所有首字母大于切分字符的字符串的子数组。
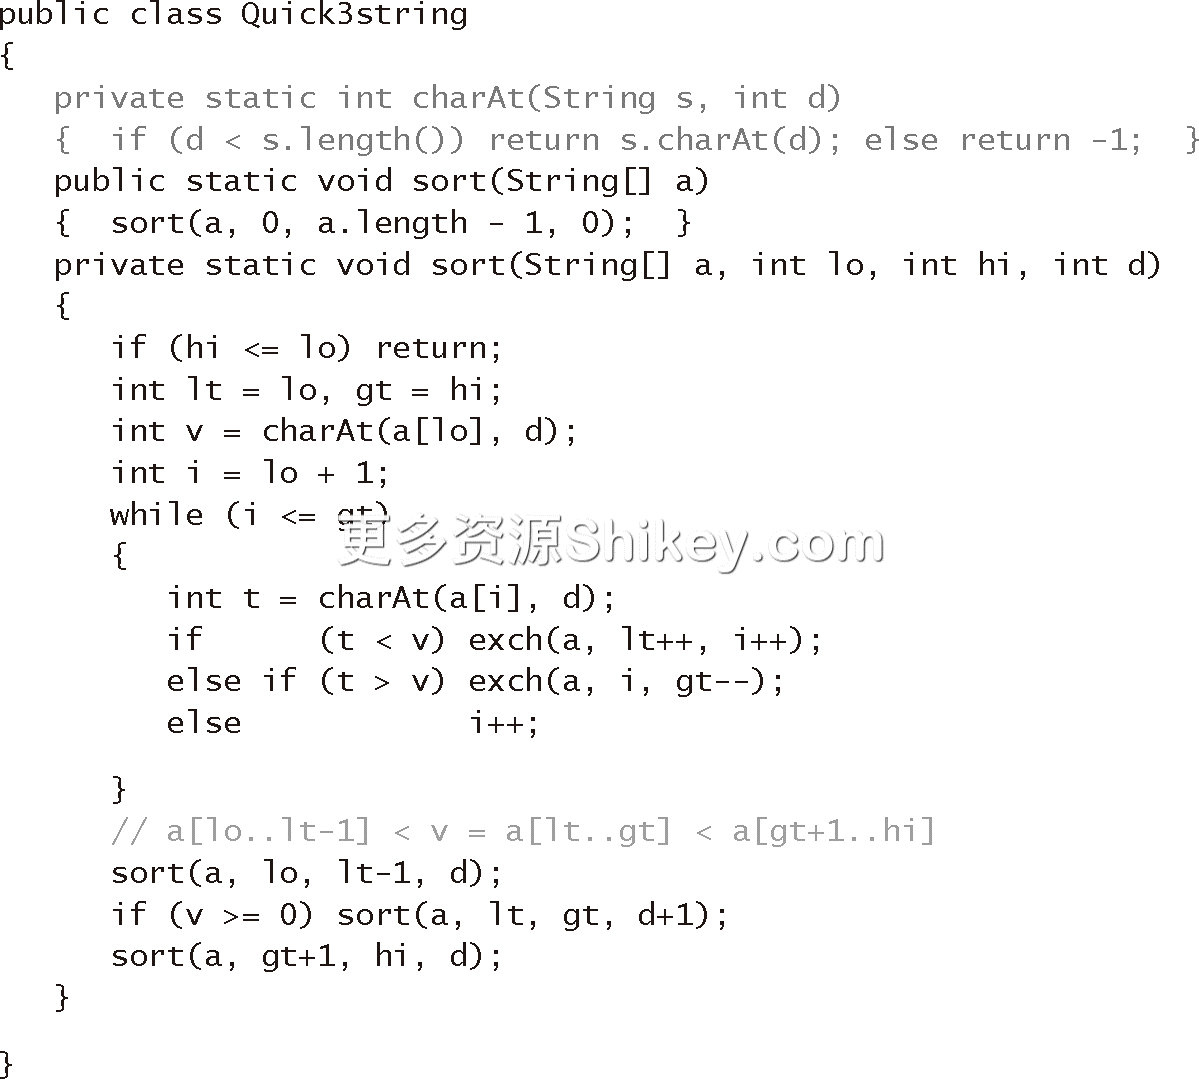
5.1.4.3 随机化
和快速排序一样,最好在排序之前将数组打乱或是将第一个元素和一个随机位置的元素交换以得到一个随机的切分元素。这么做主要是为了预防数组已经有序或是接近有序的最坏情况。
对于字符串类型的键,标准的快速排序以及第 2 章中的其他排序方法实际上都是高位优先类的字符串排序算法,这是因为 String 类的 compareTo() 方法是从左到右访问字符串中的所有字符的。也就是说, compareTo() 在首字母不同时只会访问首字母,在首字母相同且第二个字母不同时只会访问它们的前两个字母,等等。例如,如果所有字符串的首字母均不相同,标准的排序算法只会检查这些首字母,这就自动实现了一些我们希望对高位优先的字符串排序算法的改进。三向字符串排序背后的核心思想是对首字母相同的键采取特殊的策略。实际上你可以把算法 5.3 看作对标准快速排序的改进,使之能够记录已知相同的多个开头字母。在较小的子数组中,排序所需的大多数比较都已经完成,其中的字符串很可能含有多个相同的开头字母。标准的方法在每次比较时仍然需要扫描整个字符串,但三向字符串快速排序则可以避免这一点。
5.1.4.4 性能
考虑字符串键都很长的情况(简单起见,长度均相同)且键前面的大半部分字母均相同。在这种情况下,标准快速排序的性能与字符串的长度乘以  成正比,而三向字符串排序的运行时间则与 乘以字符串的长度(需要发现所有的相同开头字母) 再加上 次比较(对剩下的较短部分进行排序)的和成正比。也就是说,三向字符串快速排序所需比较的字符最多比普通的快速排序少
 个。实际排序应用中处理的键和这个例子类似的情况也并不少见。
命题 E。要将含有
次。
证明。我们可以用两种方式来理解这个结论。首先,将这个方法看作在快速排序中用首字母切分并(递归地)调用相同的方法将子数组排序,那么它所需的操作数量和普通的快速排序相同就一点也不奇怪了——但这只是比较单个字符所需的操作,而非比较整个键所需的次数。其次,可以将这个方法看作用快速排序代替了键索引计数法,根据命题 C,我们预计的运行时间为
步来将
我们曾在 5.1.3.7 节强调过,随机字符串模型是很有用的,但要预测实际情况下算法的性能还需要更仔细的分析。研究者已经对这个算法进行了深入的研究并已经证明在非常一般的假设下,其他算法最多比三向字符串快速排序快常数级别(以比较的字符数量衡量)。它的应用非常广泛,因为三向字符串快速排序的性能并不直接取决于字母表的大小。
5.1.4.5 举例:网站日志
作为三向字符串快速排序鹤立鸡群的一个示例,我们来考察一个现代系统中的典型数据处理任务。假设你架设了一个网站并希望分析它产生的流量。你可以从系统管理员那里得到网站的所有活动,每项活动的信息中都含有发起者的域名。例如,本书网站上的 week.log.txt 文件中包含的就是该网站一个星期中的所有活动。为什么三向字符串快速排序能够有效处理这种文件呢?因为排序结果中许多字符串都有很长的公共前缀,而这种算法不会重复检查它们。
5.1.5 字符串排序算法的选择
我们很自然会对这里的字符串排序算法和第 2 章中的通用排序算法的对比感兴趣。表 5.1.2 总结了本节所讨论过的字符串排序算法的重要特征(快速排序、归并排序和三向快速排序的数据来自第 2 章,以供比较)。
表 5.1.2 各种字符串排序算法的性能特点
算法是否稳定原地排序在将基于大小为 R 的字母表的N个字符串排序的过程中调用 charAt() 方法次数的增长数量级(平均长度为 w,最大长度为 W)优势领域运行时间额外空间字符串的插入排序是是 到  之间1小数组或是已经有序的数组快速排序否是

 通用排序算法,特别适合用于空间不足的情况归并排序是否稳定的通用排序算法三向快速排序否是 到 之间大量重复键低位优先的字符串排序是否
 较短的定长字符串高位优先的字符串排序是否 到
 之间
 随机字符串三向字符串快速排序否是 到 之间
 通用排序算法,特别适合用于含有较长公共前缀的字符串
和第 2 章一样,根据具体的算法和数据将这些增长数量级乘以适当的常数就可以估计出程序所需的运行时间。
我们已经看到过许多示例和练习中的许多示例,不同的情况需要用不同的算法和参数来处理。在专家的指导下(现在也许就是你),在特定的场景下算法的性能也许能够得到大幅度提高。
答疑
问 Java 系统的排序使用了这些方法来处理
String对象吗?答 没有,但 Java 的标准实现中的字符串比较非常快,它使得标准排序的性能与本节中讨论的这些算法不相上下。
问 那么,我只需要使用系统排序来处理
String类型的键就可以了吗?答 在 Java 中可能是这样的。当然如果你要处理的字符串非常多或者需要一个极快的算法,就可能需要用
char数组代替String对象并使用基数排序算法。问 表 5.1.2 中的
是怎么回事?
答 说明这些算法中的大多数比较都是在含有长度约为
练习
5.1.1 实现一种排序算法,首先统计不同键的数量,然后使用一个符号表来实现键索引计数法并将数组排序。(这种方法不适用于不同键的数量很大的情况)。
5.1.2 给出使用低位优先的字符串排序算法处理下面这些键的轨迹: no is th ti fo al go pe to co to th ai of th pa。
5.1.3 给出使用高位优先的字符串排序算法处理下面这些键的轨迹: no is th ti fo al go pe to co to th ai of th pa。
5.1.4 给出使用三向字符串快速排序算法处理下面这些键的轨迹: no is th ti fo al go pe to co to th ai of th pa。
5.1.5 给出使用高位优先的字符串排序算法处理下面这些键的轨迹: now is the time for all good people to come to the aid of。
5.1.6 给出使用三向字符串快速排序算法处理下面这些键的轨迹: now is the time for all good people to come to the aid of。
5.1.7 用一个 Queue 对象的数组实现键索引计数法。
5.1.8 对于一个含有 个键 a, aa, aaa, aaaa, ... 的文件,给出高位优先的字符串排序和三向字符串快速排序所检查的字符数量。
5.1.9 实现能够处理变长字符串的低位优先的字符串排序算法。
5.1.10 要将 个定长字符串排序(长度均为 ),在最坏情况下三向字符串快速排序总共需要检查多少个字符?
提高题
5.1.11 队列排序。按照以下方法使用队列实现高位优先的字符串排序:为每个盒子1设置一个队列。在第一次遍历所有元素时,将每个元素根据首字母插入到适当的队列中。然后,将每个子列表排序并合并所有队列得到一个完整的排序结果。注意,在这种方法中 count[] 数组不需要在递归方法内创建。
5.1.12 字母表。实现 5.0.2 节给出的 Alphabet 类的 API 并用它实现能够处理任意字母表的低位优先的和高位优先的字符串排序算法。
5.1.13 混合排序。利用标准的高位优先的字符串排序的多向切分优势处理大型数组,利用三向字符串快速排序能够避免产生大量空子数组的特点处理小型数组。研究这种想法的可行性。
5.1.14 数组排序。编写一个方法,使用三向字符串快速排序处理以整型 数组 作为键的情况。
5.1.15 亚线性排序。编写一个处理 int 值的排序算法,遍历数组两遍,第一遍根据所有键的高 16 位进行低位优先的排序,第二遍进行插入排序。
5.1.16 链表排序。编写一个排序算法,接受一条以 String 为键值参数的结点链表并重新按顺序排列所有结点(返回一个指向键值最小的结点的指针)。使用三向字符串快速排序。
5.1.17 原地键索引计数法。实现一个仅使用常数级别的额外空间的键索引计数法。证明你的实现是稳定的或者提供一个反例。
实验题
5.1.18 随机小数键。编写一个静态方法 randomDecimalKeys,接受整型参数 N 和 W 并返回一个含有 N 个字符串的数组,每个字符串都是一个含有 W 位数的小数。
5.1.19 随机的加利福尼亚州车牌号。编写一个静态方法 randomPlatesCA,接受一个整型参数 N 并返回一个含有 N 个字符串的数组,每个字符串都是与本节的示例类似的加利福尼亚州的车牌号。
5.1.20 随机定长单词。编写一个静态方法 randomFixedLengthWords,接受整型参数 N 和 W 并返回一个含有 N 个字符串的数组,每个字符串都基于英文字母表且长度为 W。
5.1.21 随机元素。写一个静态方法 randomItems,接受整型参数 N 并返回一个含有 N 个字符串的数组,每个字符串的长度均在 15 到 30 之间且由三个部分组成:第一个部分含有 4 个字符,来自于 10 个固定的字符串;第二个部分含有 10 个字符,来自于 50 个固定的字符串;第三个部分含有 1 个字符,来自于 2 个固定的字符串;第四个部分长 15 个字节,值为长度在 4 到 15 之间且向左对齐的随机字符串。
5.1.22 运行时间。使用多种键生成器比较高位优先的字符串排序与三向字符串快速排序的运行时间。对于定长的键,在比较中加入低位优先的字符串排序算法。
5.1.23 数组访问。使用多种键生成器比较高位优先的字符串排序与三向字符串快速排序的数组访问次数。对于定长的键,在比较中加入低位优先的字符串排序算法。
5.1.24 被访问的最靠右的字符。使用多种键生成器比较高位优先的字符串排序与三向字符串快速排序能够访问到的最靠右的字符的位置。