01|架构演进:从 Framework 到 Harness,Agent 到底需要怎样的底层支撑?
作者:Tony Bai
驾驭工程(Harness Engineering)正在崛起
你好,我是Tony Bai。欢迎来到《从0开始构建 Agent Harness》的第一讲。
在开篇词中,我们用“操作系统(OS)”作了一个高维度的类比,指出了当前 AI Agent 开发面临的严重摩擦力,并抛出了一个核心洞见:框架层正在坍塌,驾驭工程(Harness Engineering)正在崛起。
开篇词从宏观上回答了“为什么”我们要重塑认知。而从今天这一讲开始,我们将脱下概念的外衣,穿上架构师的工装,深入到软件工程的骨骼和经络中去,回答“怎么做”的问题。如果不用 LangChain 或者 AutoGen等框架,一个原生的、能够稳定运行于工业环境的 Agent 到底长什么样?OpenClaw 这样的顶级开源引擎,其底层架构究竟精妙在哪里?
今天,我们将从软件架构演进的视角,彻底剖析 Framework 与 Harness 的底层差异,并为你即将亲手编写的 go-tiny-claw 引擎绘制出第一张全景工程蓝图,敲下最核心的第一行数据结构代码。
剖析黑盒:传统 Framework 的架构陷阱
要理解 Harness,我们必须先从代码层面弄清楚,为什么传统的 Agent 框架在面对复杂生产任务时会显得如此脆弱。
早期如 GPT-3 时代,由于模型原生缺乏强大的逻辑规划和工具调用(Function Calling)能力,开发者们发明了各种基于 “链(Chain)” 和 “有向无环图(DAG)” 的框架。
在这些框架中,逻辑是硬编码的。比如,为了完成一个“分析报错并搜索解决方案”的任务,框架会要求你这样编写代码:
- 定义一个
ErrorAnalyzerNode。 - 定义一个
WebSearchNode。 - 通过代码配置一条边(Edge),规定当分析器输出特定关键词时,数据流向搜索节点。
我们用一张图来直观感受传统框架的执行流:
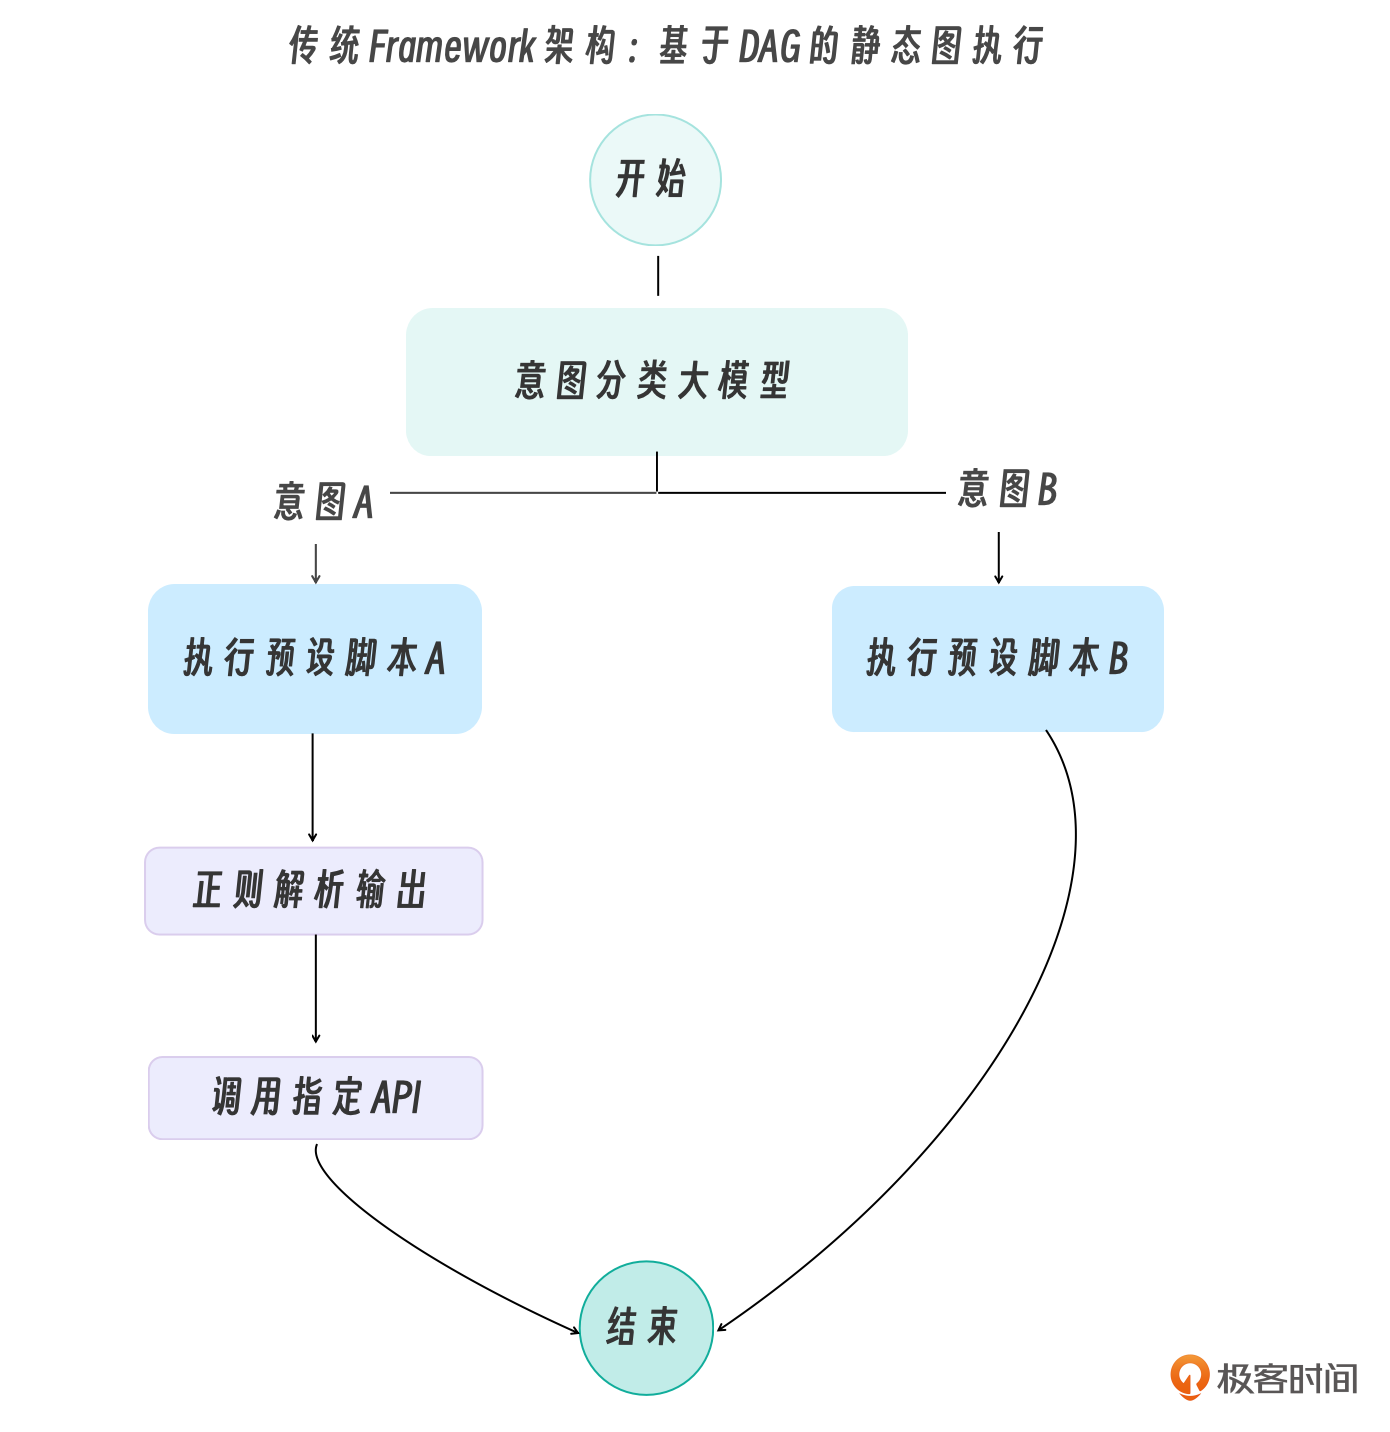
这种架构的致命缺陷在于“静态”与“过度干预”。
真实世界的排障过程是千变万化的。如果在 NodeA 执行工具时,网络超时了,或者返回了一个预期之外的 JSON 格式,传统的 DAG 图往往缺乏弹性的回退机制,直接抛出异常导致进程崩溃。
更严重的是,框架为了实现这种节点间的跳转,在底层维护了极其复杂的、人类难以阅读的隐式状态机(State Machine)。一旦发生死循环,在图的中间开发者根本无法插手干预。
Harness(驾驭工程):极简的动态运行时
随着 Claude 3.5 Sonnet、GPT-4o 等前沿模型的问世,大模型本身已经进化成了一个拥有极强自主规划能力的 CPU。它不需要你用代码去规定“先执行 A,再执行 B”。它只需要你给它一个包含当前状态的上下文(Context),并告诉它“这里有几个工具”,它就能自主推导出下一步该干什么。
基于这个前提,Harness(驾驭工程)应运而生。它不再是一个定义业务逻辑的图结构,而是一个极简的、动态的运行时环境(Runtime Environment)。
在 OpenClaw 等现代底层引擎中,架构被极大地拉平了。它抛弃了 DAG,转而回归了计算机科学中最古老也最可靠的结构:一个无限循环(Main Loop)+ 一组事件驱动的拦截器(Interceptors/Middlewares)。
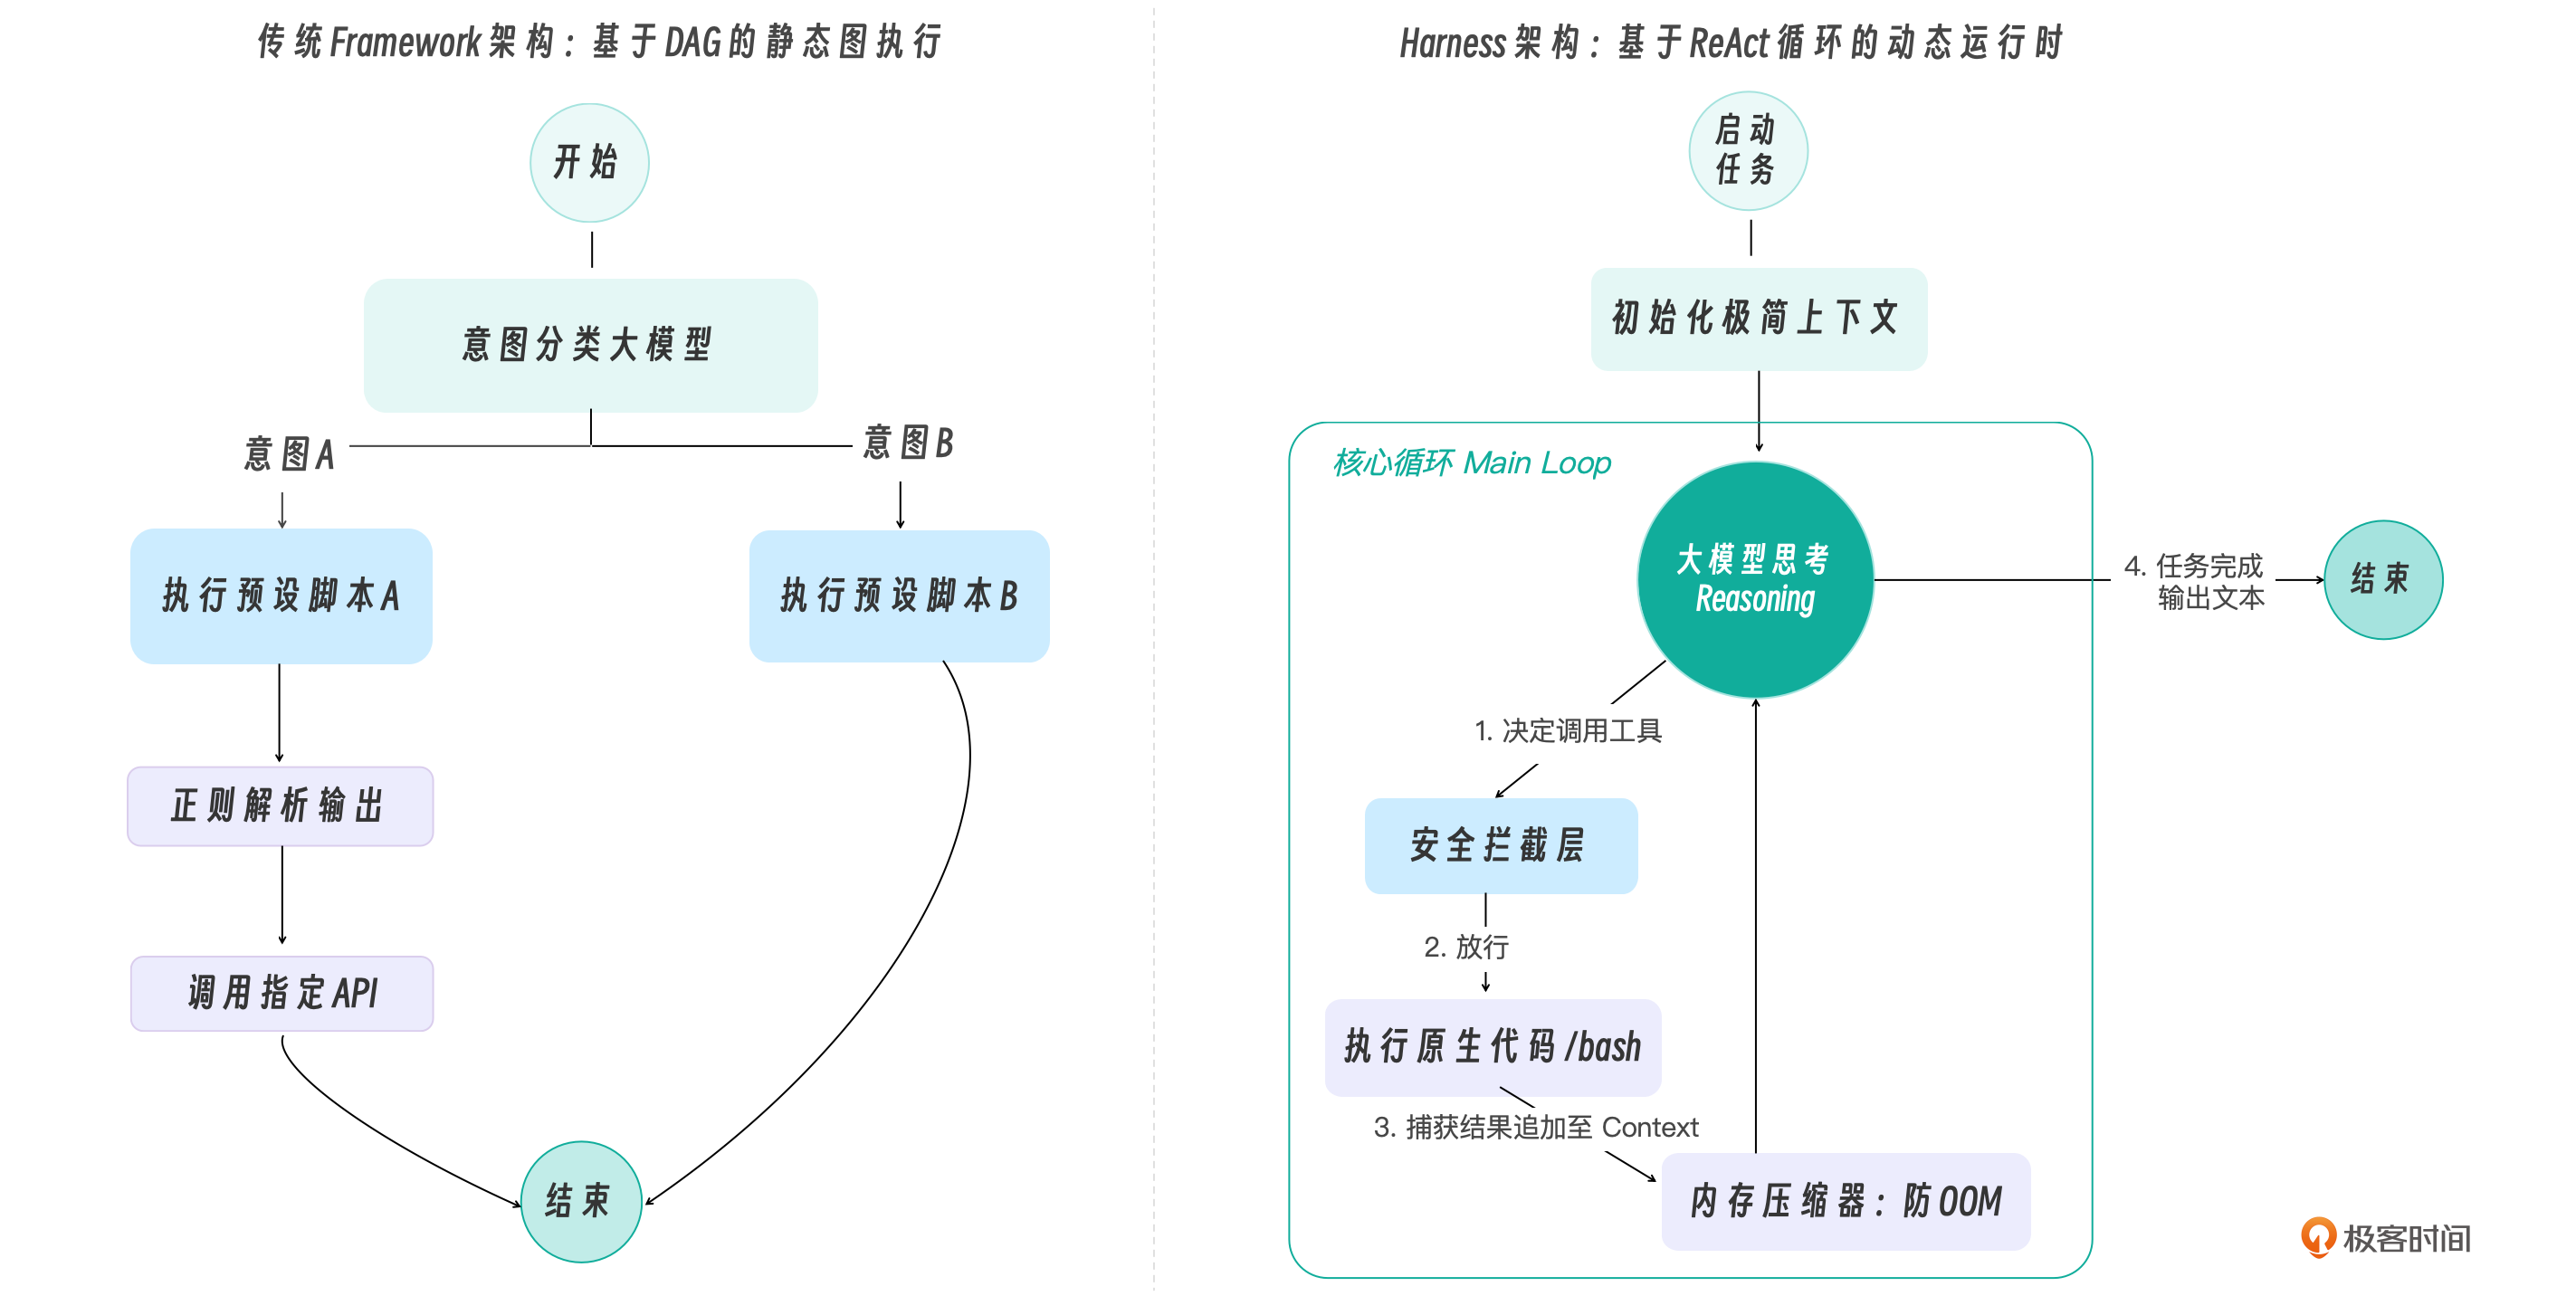
对比两张图,你可以清晰地看到 Harness 的三大革命性转变:
- 控制反转(IoC):业务流程的控制权从“Go/Python 代码”完全转移到了“大模型的实时推理和规划”中。代码只提供物理定律(如文件读写和编辑、沙箱执行等),不干涉任务走向。
- 防线前移:既然大模型是自由的,它就可能犯错或搞破坏。因此 Harness 的核心代码全部集中在了
Middleware(防止搞破坏)和Compactor(防止内存被撑爆)上。 - 状态透明:循环只依赖一个单一的数据结构——也就是不断累加的
Context消息列表。没有任何隐式的树节点或图节点变量。
绘制 go-tiny-claw 的工程蓝图
理解了 Harness 的本质,我们现在就可以开始为 go-tiny-claw 设计 Go 语言的工程架构了。
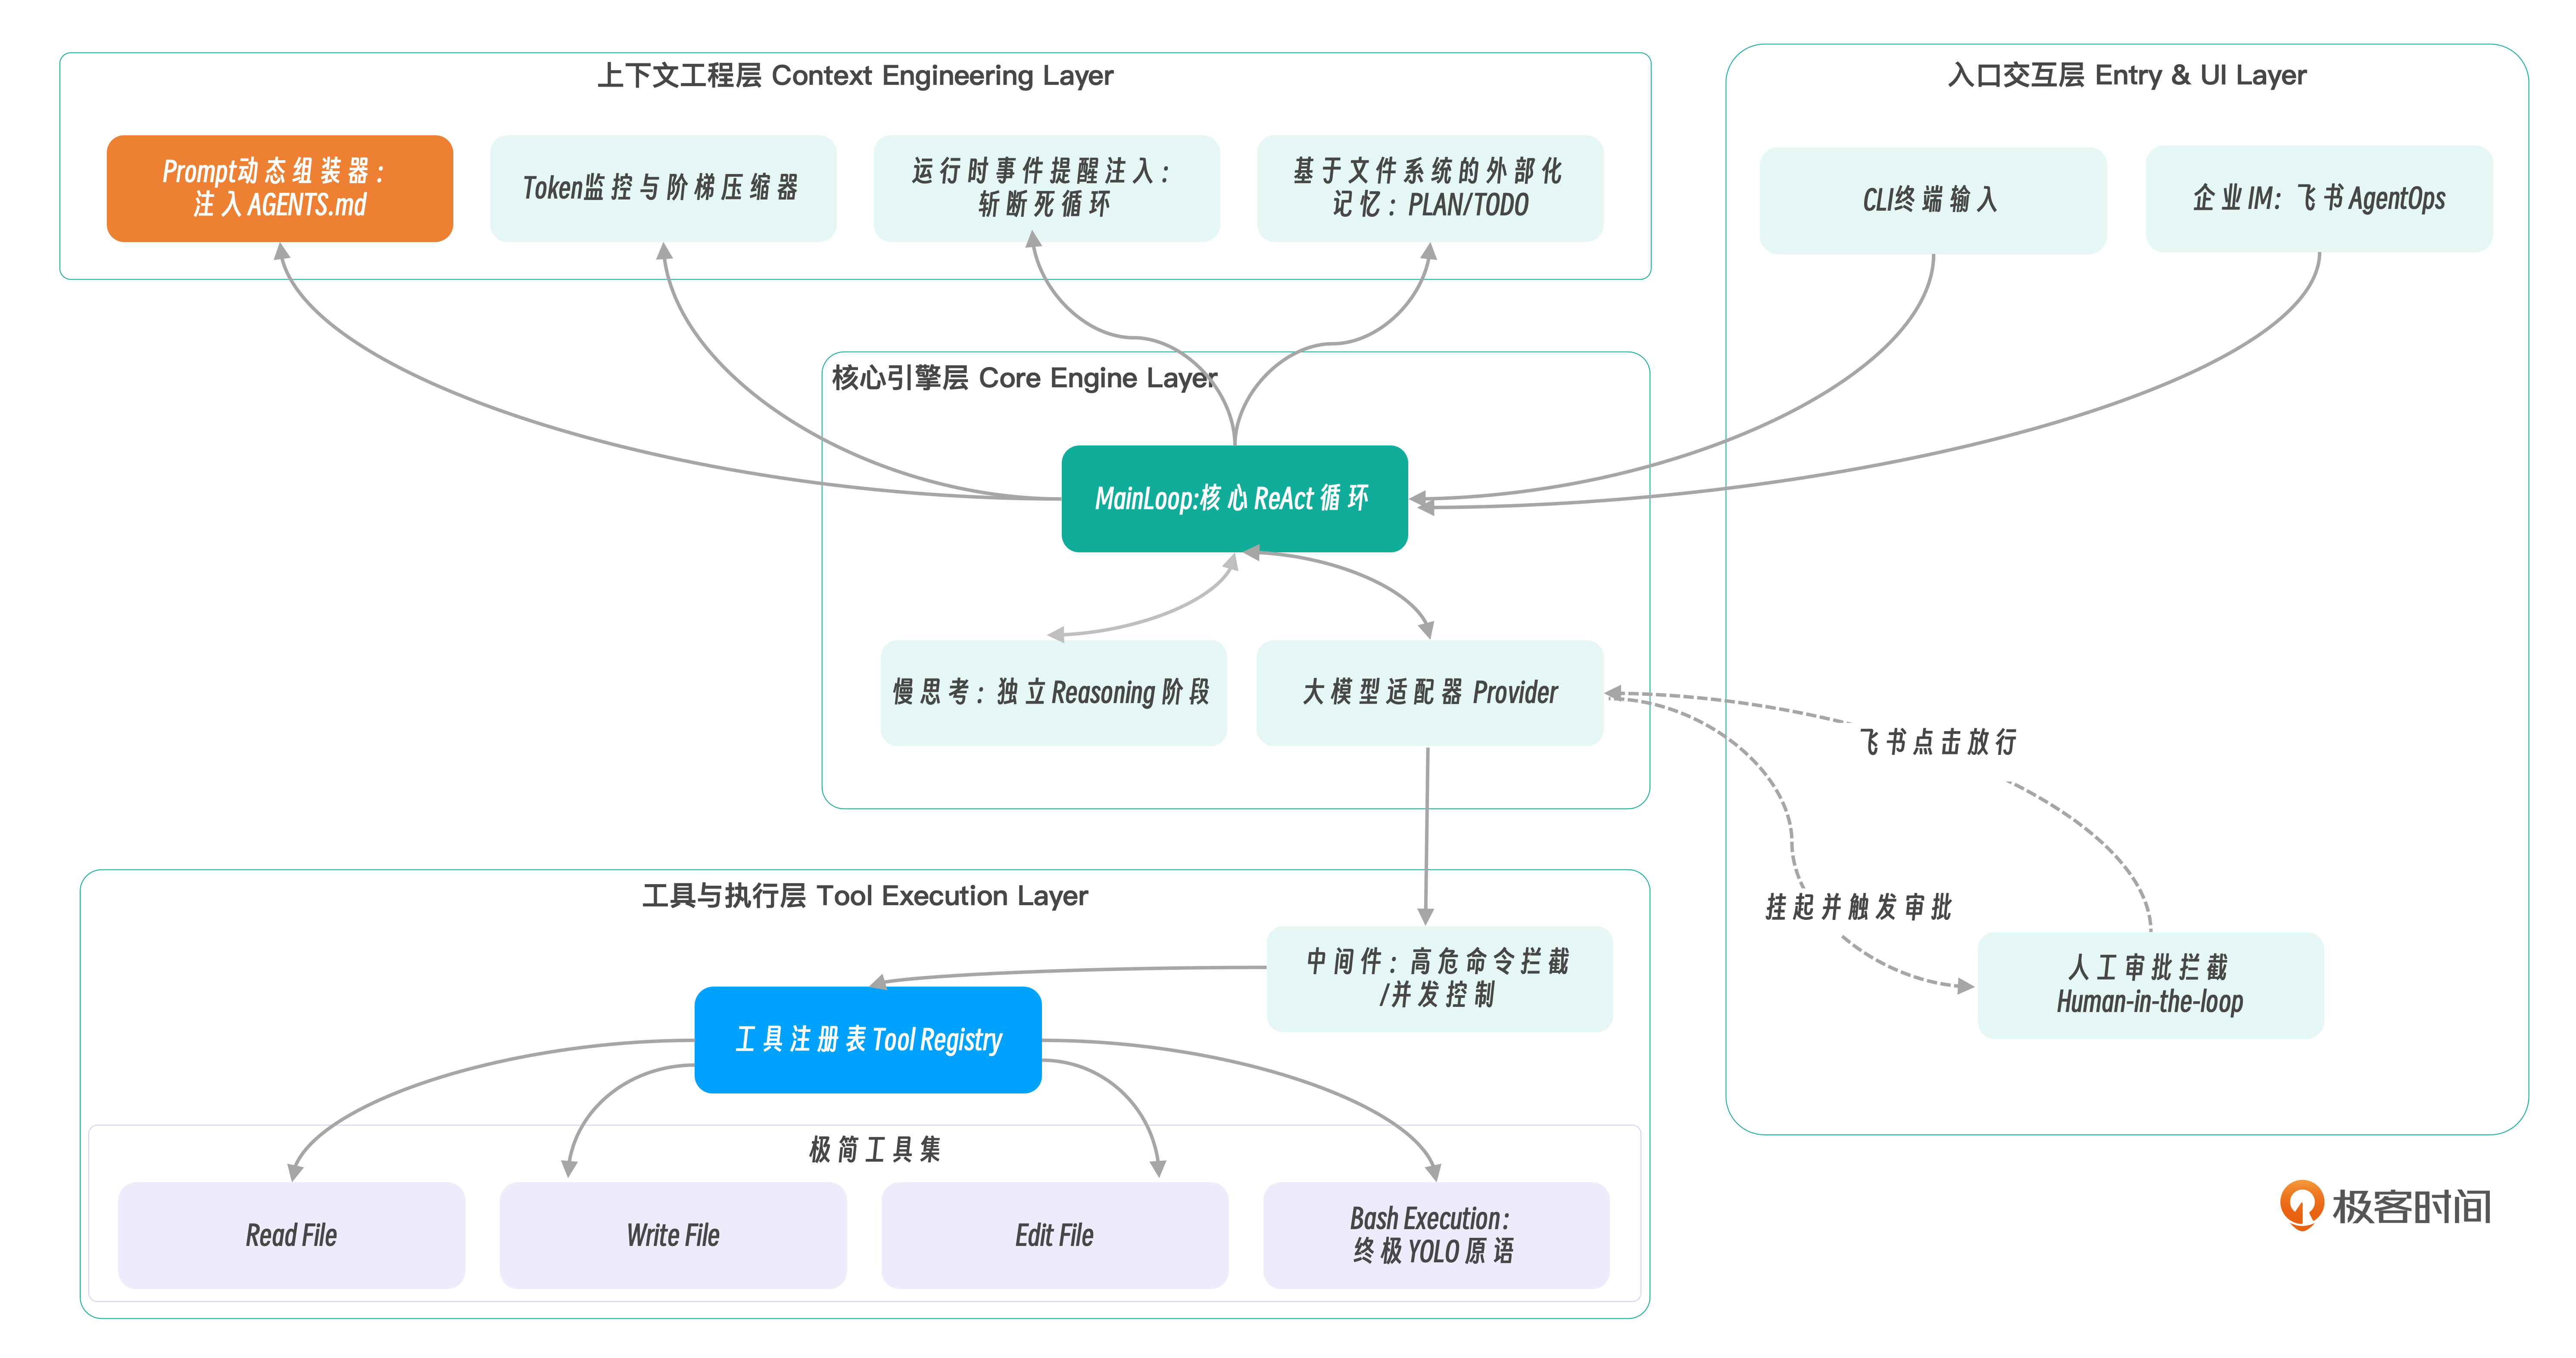
结合 Harness 驾驭工程的理念,我将 go-tiny-claw 的架构划分为四个核心层:入口交互层(Entry & UI Layer)、核心引擎层(Core Engine Layer)、上下文工程层(Context Engineering Layer)和工具与执行层(Tool Execution Layer)。
请仔细看下面这张图,它将作为我们整个专栏的“航海图”贯穿始终:
架构分层解析
入口交互层:引擎对外的触角。我们将支持终端命令行(CLI)输入,并将其接入飞书。更重要的是,这一层包含了人工审批(Human-in-the-loop)的异步回调机制。
核心引擎层(心脏):系统的控制中枢。
Main Loop负责维持 ReAct 循环。旁边的大模型适配器是“大脑接口”,抹平不同大模型(如 Claude 和 OpenAI兼容)底层 API 的差异。新增的Thinking模块则负责在行动前强制模型进行慢思考。上下文工程层(内存管理器):决定 Agent 能够跑多远的关键。
a. Prompt 动态组装器:动态拼装模块化的系统规则(如读取
AGENTS.md)。b. Token 监控与阶梯压缩器:像 OS 的内存回收器一样,时刻盯着 Token 水位线触发压缩。
c. 运行时事件提醒注入:是防走神的利器,在模型做决定的前一刻注入干预指令。
基于文件系统的状态与记忆则是极简哲学的核心——抛弃内部变量,直接把进度写在本地
TODO.md里。工具与执行层(四肢与手脚):挂载了让模型改变物理世界的组件。动态的
ToolRegistry配合极简工具集(read/write/edit/bash),让模型组合出无限可能。强大的Middleware机制则死死把守大门,拦截危险命令并对接审批。
建立项目:go-tiny-claw 的代码骨架
作为一门追求工业级标准的专栏,我们需要遵循 Go 语言的经典项目布局(Standard Go Project Layout),将上述架构图映射到代码目录中,以确保各个模块(引擎、工具、上下文、适配器)之间高内聚、低耦合。
千里之行,始于足下。今天,我们将敲下 go-tiny-claw 的第一段极其朴素但意义深远的骨架代码。
步骤 1:初始化项目
请打开你的终端,执行以下命令初始化项目模块:
mkdir go-tiny-claw
cd go-tiny-claw
go mod init github.com/yourname/go-tiny-claw步骤 2:创建目录骨架
根据我们刚刚设计的架构蓝图,在项目根目录下创建如下的基础目录结构:
mkdir -p cmd/claw
mkdir -p internal/engine # 核心引擎层 (Main Loop)
mkdir -p internal/provider # 模型适配层 (Claude/Zhipu Adapter)
mkdir -p internal/context # 上下文工程层 (Compactor, Prompt Composer)
mkdir -p internal/tools # 工具与执行层 (Registry, Built-in Tools)
mkdir -p internal/memory # 状态与记忆层 (基于文件的 PLAN/TODO)
mkdir -p internal/feishu # 飞书集成层创建完毕后,你的项目目录布局应该如下所示:
go-tiny-claw/
├── cmd/
│ └── claw/
│ └── main.go # 程序入口
├── internal/
│ ├── engine/ # MainLoop 核心实现
│ ├── provider/ # 大模型接口抽象与具体厂商 SDK 实现
│ ├── context/ # Token 监控、Prompt 动态组装
│ ├── tools/ # 工具注册表、Middleware、基础极简工具(bash/edit等)
│ ├── memory/ # 基于文件系统的记忆状态存取
│ └── feishu/ # 飞书机器人交互回调
├── go.mod
└── README.md步骤 3:编写入口骨架与占位符
在 cmd/claw/main.go 中,我们写下这个引擎的第一段极其朴素的骨架代码。这段代码虽然是被注释掉的 TODO,但它精确地描绘了 Harness 驾驭引擎的启动流程:
// cmd/claw/main.go
package main
import (
"fmt"
"log"
)
func main() {
fmt.Println("🚀 欢迎来到 go-tiny-claw 引擎启动序列")
// TODO: 1. 初始化模型 Provider (大脑)
// provider := provider.NewClaudeProvider(...)
// TODO: 2. 初始化 Tool Registry (手脚)
// registry := tools.NewRegistry()
// registry.Register(tools.NewBashTool())
// TODO: 3. 初始化上下文管理器 (内存管理器)
// ctxManager := context.NewManager(...)
// TODO: 4. 组装并启动核心 Engine (操作系统心脏)
// engine := engine.NewAgentEngine(provider, registry, ctxManager)
// fmt.Println("开始执行任务...")
// err := engine.Run("帮我检查一下当前目录下的文件并输出一个 README.md 大纲")
// if err != nil {
// log.Fatalf("引擎运行崩溃: %v", err)
// }
log.Println("架构蓝图搭建完毕,等待各核心模块注入!")
}运行与验证
在终端中执行以下命令,验证我们的基础项目结构和骨架代码是否能正常编译与输出:
go run cmd/claw/main.go预期输出:
🚀 欢迎来到 go-tiny-claw 引擎启动序列
2026/03/29 14:36:01 骨架搭建完毕,等待各核心模块注入!这几行被注释掉的 TODO 代码,就是我们接下来整个专栏的全部航程。在下一讲中,我们就将深入 internal/engine 目录,撕开 Agent 最神秘的面纱,用纯 Go 代码手写出一个健壮的 ReAct 循环(Main Loop)。
本讲小结
今天这一讲,我们完成了一次重要的认知重构。这是支撑你能否写出一个真正好用的工业级 Agent 的分水岭。
- 突破“调包”局限:当我们在生产环境中遇到上下文溢出、死循环、行为失控等问题时,单纯修改 Prompt 或依赖厚重的应用框架(Framework)往往无济于事,静态的 DAG 图无法应对千变万化的真实世界。
- Harness 驾驭工程的本质:Agent 的尽头是操作系统(OS)。我们将大模型视为 CPU,将 Context 视为内存。我们要做的 Harness 工程,就是为大模型编写一个微型 OS,核心职责包括:调度 Main Loop、精细化回收 Context 内存、安全管控极简的原生工具,以及处理中断与异常。
- 确立架构蓝图:我们推导出了
go-tiny-claw的多层架构(入口交互层、核心引擎层、上下文工程层、工具与执行层),并用 Go 语言搭建了清晰的高内聚工程骨架,写下了串联各大模块的启动伪代码,为后续实战做好了准备。
注:本讲的示例代码,可以在这里下载。
思考题
在经典的计算机操作系统中,当内存(RAM)不足时,系统会触发 OOM(Out Of Memory)Killer 强杀进程,或者将不常用的内存页置换到磁盘上(Swap)。
结合今天所学的 Harness 理念,如果大模型的上下文窗口(Context Window)逼近了极限限制(比如 128k Tokens),你认为在我们的 go-tiny-claw 引擎中,应该采取哪些类似 OS 的策略,来避免整个 Agent 因为 API 报错而彻底崩溃失忆?
欢迎在留言区分享你的思考与灵感。我们下一讲,正式开始手写核心引擎!
精选评论
文涛: 经典计算机:强杀进程 or 内存置换磁盘 tine-claw:上下文压缩 -> 添加到 context.md 磁盘中 -> 重新开启对话,并加载上次的context.md 文件
作者回复: 👍
zhangwq: 老师的这个类比,有点看懂 agent 进化的路线的感觉了;Harness 看起来更像是职责分离了,你卷你的大模型(cpu),他做他的外设(harness),大家分工合作提供用户价值(收割用户);然后框架进行了更多的认为的认为编排,harness是把这一部分交给大模型处理,但是这样的输入的确定性怎么处理呢?
作者回复: 我理解Harness追求的是“结果的确定性”。 我们不再用代码写死 A -> B 的路径,而是通过“物理约束”(比如:参数不合法不给运行、报错了注入锦囊提示、高危操作必须人类在环审批)来确保大模型无论怎么跑,最终都能被导向正确的、安全的结果。
Void: 有向无环图(DAG)代表经典的工作流模式,在大模型早期,模型能力偏弱,特别是指令等的遵循能力,基本还处于prompting阶段,通过DAG构建大模型工作流其实算是一个比较务实的,可落地的方案。典型代表就是Difi,N8N等。OpenAI自己的Agent Builder事实上也是这种模式。
但DAG的缺点也非常明显,工作流是预定义的,场景是固化的。
作者回复: 👍 再做一个可能不恰当的比喻;DAG 是“剧本”表演,而 Harness 是“即兴表演”。😄
许则: 虽然是来学习 Harness 的,但是也不是完全不用 Framework 了。Framework 虽然面对复杂生产任务,有它的瓶颈。但生产中什么叫做复杂任务,复杂任务的占比是多少?我的经验是,大部分业务场景都不复杂,项目初期用 dify 编排 workflow 都是够用的。学习的目的是解决问题。当然,Harness 也是必须学习的,😊
作者回复: 👍
jarvis: 用户给任务 ↓ contextHistory 记录任务 ↓ LLMProvider.Generate 让大模型思考 ↓ 大模型返回: 要么是最终答案 要么是 ToolCall ↓ 如果是 ToolCall ↓ Registry.Execute 执行工具 ↓ 工具结果变成 Observation ↓ Observation 追加回 contextHistory ↓ 再次发给大模型 ↓ 循环
作者回复: 👍
Isaac: 再理解一下这门课的适用场景:Planning交给LLM,而不是Framework,这个做法是不是更适合不确定性较高的场景?如果我在实现企业中SOP,是不是Framework更能带来确定性?
作者回复: 非常有见地的观察!你说得对,这是一个关于“灵活度”与“确定性”的权衡。 传统的 Framework(如 DAG 工作流)本质上是“硬连线”,适合路径极其固定、容错率极低的 SOP 场景。而Harness 架构(LLM Planning)是将控制权交还给模型,适合处理长尾、复杂的工程任务(比如重构代码,你无法预知会遇到什么编译报错)。
佳佳的爸: 问题: 如果大模型的上下文窗口(Context Window)逼近了极限限制(比如 128k Tokens),你认为在我们的 go-tiny-claw 引擎中,应该采取哪些类似 OS 的策略,来避免整个 Agent 因为 API 报错而彻底崩溃失忆?
回答: 首先,跟大多数文件系统类似,得维护一个后台的守护进程(daemon)实时监控上下文的长度,如果到达阈值(默认最大token的80%,或者85%,90%等), 启动上下文压缩(compact), 同时自动归档备份当前的上下文。
其次,要给用户一个友好的提示信息,告诉用户上下文即将超限,并提出可选方案: 新开会话或者继续当前会话。如果用户选择新开会话,引擎也必须先整理先对当前会话做摘要整理,否则在新的会话中就会面临会话失忆的问题。
作者回复: 👍
子豪sirius: 来学习第一课。针对思考题,我们传统的程序(比如Java),在面临内存不足时,是会采用垃圾回收机制。要回收的垃圾是那些没有被引用的对象(认为是不再使用)。类比到这里,我的想法是如果监控token数量接近阈值,是否也有这个“回收”,这需要判断token里面哪些是不需要的部分进行删除,或者可以对token进行压缩。我初学者,不知道有没有这样的方法或方案能做到
作者回复: 你的直觉极其准确👍,这种“垃圾回收”和“压缩”正是我们在 第 12 讲 (Context Compaction)的主题。我们会实现一套“阶梯压缩策略”,不仅清理无用Token,还会通过掐头去尾截断超长废话。当然关于上下文压缩的研究和前沿工程实践依然在进行中,后续业界可能会诞生更多效果更好的方案。在这方面,也希望大家集思广益,在上下文压缩那一讲后面分享大家的最佳实践。
Jaising: 和操作系统的共通之处是如何在资源有限的情况下持续运行——操作系统的 CPU、内存、IO 等都是稀缺资源,而且各种应用进程可能报错;相应的,Agent Runtime 会面临 Context Window 有限、token 成本有限、工具集可能输出爆炸的问题——把有限资源分配给最重要的任务,尽可能保证核心稳定让系统具备恢复能力,于是可以: 1、类似程序计数器一样记录当前执行状态,结构化保存可追溯可恢复不受模型调用影响; 2、类似分级缓存一样设计 token 使用阶梯,提前约束资源使用量减少频繁超额请求; 3、类似分层存储一样设计数据索引,热数据放 prompt、原始日志放 memory、按需调用
作者回复: 👍
Dragon baby: 老师,那是不是代表Framework框架,比如vercel Ai sdk 、langchain、langGraph不适合harness了,我们如何在项目上判断是否该不该使用Framework
作者回复: 也不完全是排斥关系。Harness 是一种底层架构模式(Architecture Pattern),而这些 Framework是一些工具箱(Toolkit)。
如果你的项目是重交互、长周期、需要人类随时介入(Human-in-the-loop)、极度抠 Token 成本的复杂运维/编码 Agent,要么选择自己写 Harness,要么利用业界成熟的前沿harness(比如openclaw、hermes等);如果只是写一个“智能客服问答”或者简单的单步数据提取,也许用成熟的 Framework会快得多。
发飙的蜗牛: 有学习 java 的同学吗?我自己跟着老师实现了 java 版本,可分享给学习 java 的同学
作者回复: 👍
gevin: 可以按滑动窗口的思路,舍弃早期的token ,也可以让LLM压缩已有的记忆
作者回复: 👍
Geek_wsdllll: 大模型越来越“智能”,Harness感觉是将编排的决策交给LLM处理,“人”帮AI打工,回归到工程规范和安全边界的处理上;随着AI发展(上下文的逐渐扩大),AI将逐步接替“人”所负责的工作,“人”只能靠着长时间经验积累下来的上下文实现自己的价值,而且可能也会被替代。
作者回复: 👍
Geek_7532f3: 根据在 Claudecode 的相关实现中,认为可以有以下策略
- 对于部分工具 Tools的输出结果可以省略,精简
- 对于历史的Input,Output可以根据队列先入先出进行旧信息淘汰
- 根据滑动窗口移动上下文边界
- 实在无法压缩 ,可以使用LLM,触发总结 来重新压缩上下文,但是不知道现在具体的最佳实践如何
作者回复: 👍
大菠萝: 在处理的数据量比较大的情况下,基于文件系统上文件来管理记忆是否会成为瓶颈?是否有必要引入向量数据库?
作者回复: 很多开发者误以为记忆就是 RAG。 实际上,对于 Agent来说,弄清楚“我刚才干了啥”比“我两年前学了啥”重要得多。专栏先带大家掌握最核心、最有效的“文件记忆”,这是Agent 走向工业级的第一步。
当然,关于agent memory,业界依旧还在探索和演进,这块我也会持续跟进。
Geek_055a06: 上文窗口管理可以借鉴OS的内存虚拟化机制
作者回复: 👍
Dexter: ReAct 循环 ----老师为什么叫react循环?
作者回复: 这个02讲有详细说明[手动抱拳]。
Geek_bd0069: 总觉得现在的A agentI工程化的一些做法跟原来java后端spring中的思维有点像,但说不出来,看了这篇文章IOC确实是那样的,才反应过来
作者回复: 👍
Egthat: 监控上下文窗口阈值,并自动触发compact
作者回复: 👍
MClink: 几个月没有手写过一行代码了。打算让Claude自己读文章内容帮我把代码写了。😂
Aaron Liu: 提炼压缩之前的内容,丢弃部分旧的信息
小小,梦想: 一般的做法都是智能压缩,滑动窗口吧?但是大模型总有上下文焦虑,快到上限,就一直提醒先做一部分什么的,glm5尤其明显