05|动作延伸:构建强扩展性的 Tool Registry 与分发机制
作者:Tony Bai
将抽象的意图落地为具体的物理执行
你好,我是Tony Bai。欢迎来到《从0开始构建 Agent Harness》专栏的第五讲。
在上一讲中,我们通过设计优雅的 Provider 适配层,成功为 go-tiny-claw 接入了真实的“大脑”(兼容 OpenAI/Claude 协议的智谱 GLM 模型)。并且,我们前瞻性地探讨了自适应推理(Adaptive Reasoning),通过一个开关控制大模型是否进行“慢思考”。
然而,那个聪明的“大脑”,目前只能通过一个伪造的 mockRegistry 查询一段固定的“假天气”数据。
一个真正的工业级 Agent,它的使命是改变现实世界,比如:它需要读取本地代码、修改配置、执行终端命令,甚至调用集群的微服务。如果面对成百上千种潜在的工具需求,我们在核心引擎(Main Loop)里用一堆 if-else 或 switch-case 去硬编码每个工具的解析和执行逻辑,代码很快就会变成一座无法维护的垃圾山。
这就是为什么顶级开源 Agent(如 OpenClaw)在底层架构中,都必不可少地引入了一个核心中间件:Tool Registry(工具注册表)。
今天,我们将正式踏入专栏的第二章:极简工具与物理交互(Action & Tools)。我们将拔掉假肢,亲手用 Go 语言构建一个强扩展、高内聚的 Tool Registry,并实现我们的第一个物理级工具:read_file(读取本地文件)。
架构设计:为什么需要 Tool Registry?
在 Harness(驾驭工程)的理念中,Main Loop 永远是“瞎子”和“聋子”。它不应该知道 bash 命令怎么调用,也不应该知道 read_file 需要什么参数格式。它只负责维护上下文,并将模型吐出来的 JSON 字符串丢给执行层。
因此,Tool Registry 扮演了一个极其关键的“集线器(Hub)”和“路由器(Router)”的角色。它的核心职责有三:
- 动态挂载(Register):允许开发者在引擎启动时,随时随地向系统插拔新的工具实现(在Go中,其本质上是实现了特定 Go 接口的结构体)。
- 描述暴露(Expose Schema):在每次向大模型发起推理前,Registry 负责把当前所有已挂载工具的名称、描述以及 JSON Schema 打包成列表,交给
Provider翻译给大模型听。 - 路由分发与执行(Dispatch & Execute):当大模型决定调用某个工具,并吐出一串 JSON 参数(
ToolCall)时,Registry 负责找到对应的 Go 函数,把 JSON 丢给它执行,最后将结果封装成统一的ToolResult返回给 Main Loop。
我们可以用一张示意图来清晰地展示这个解耦过程:
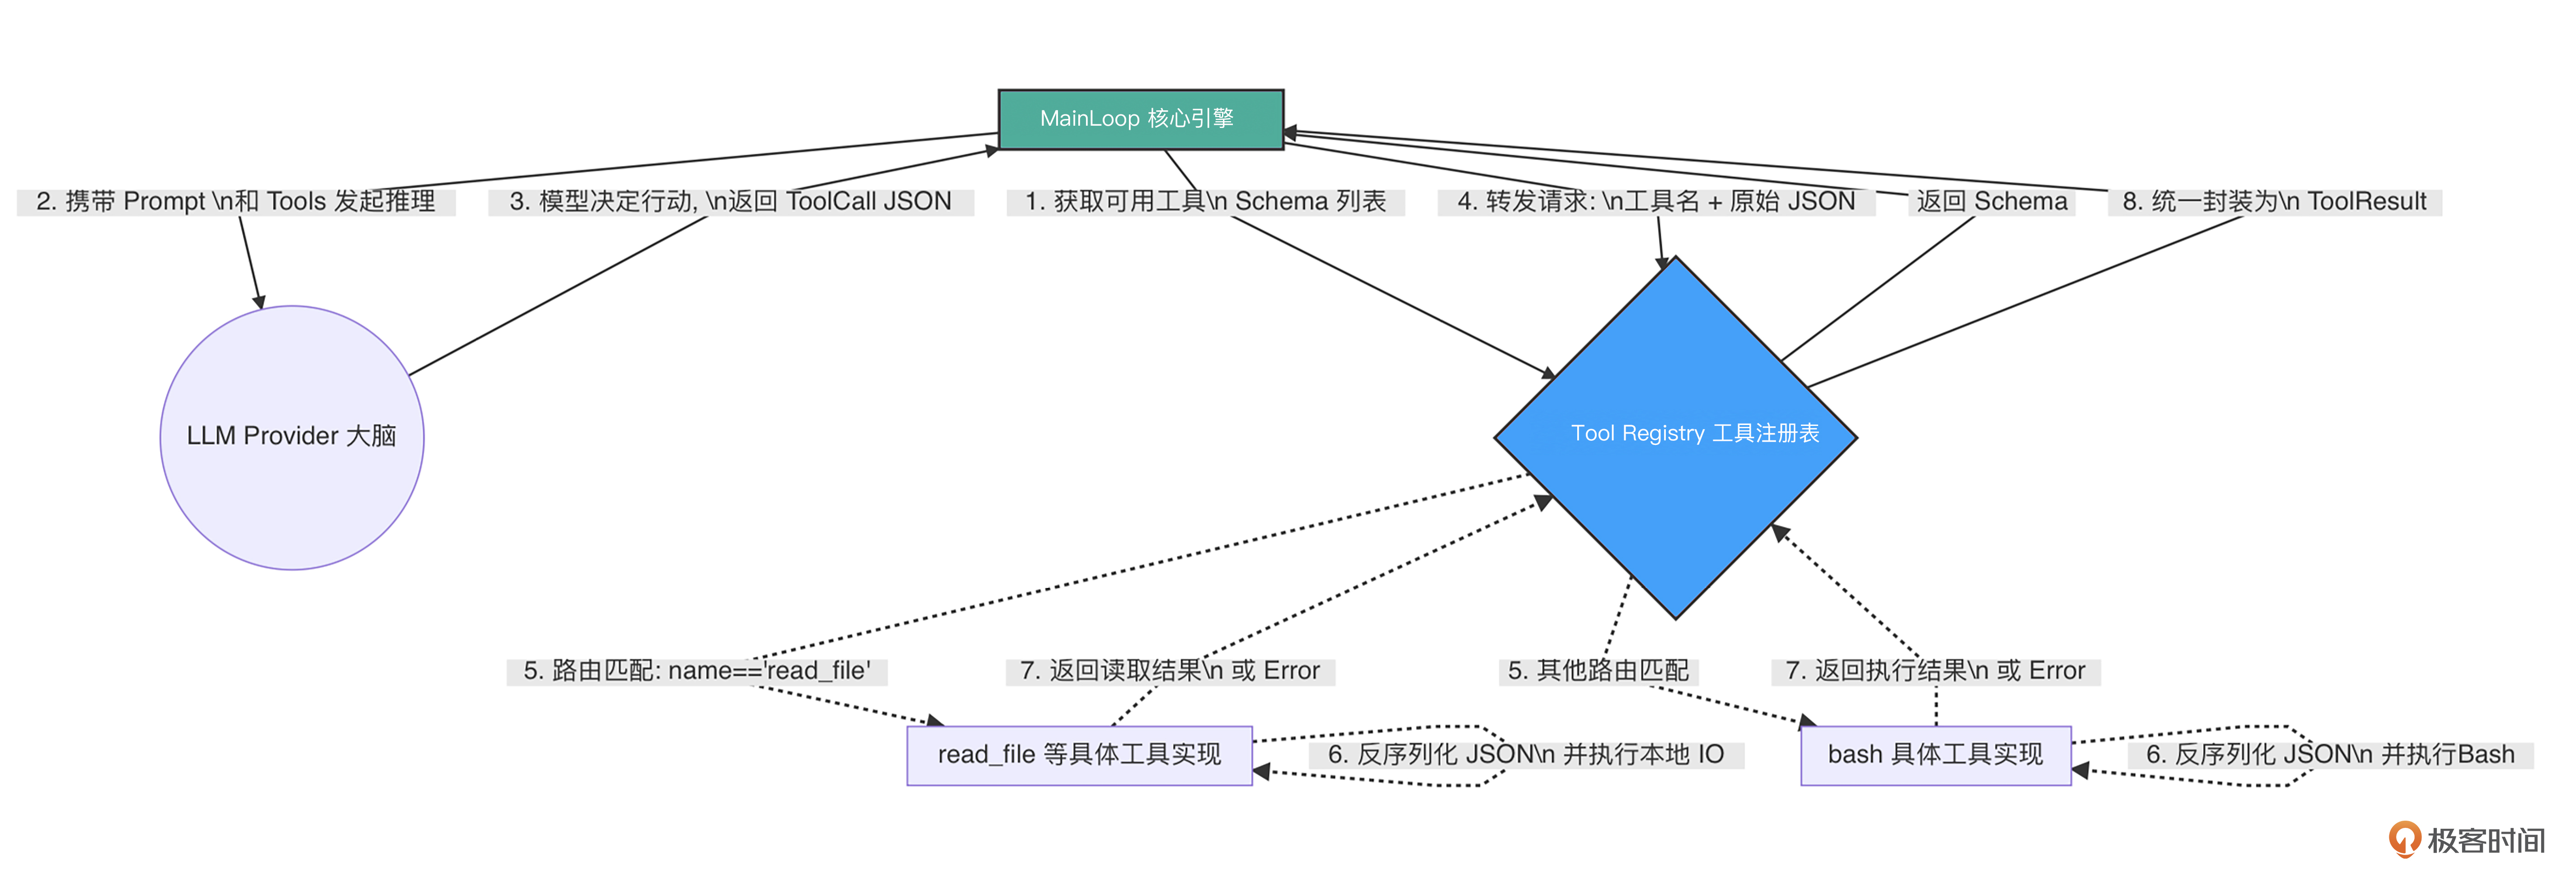
有了这个 Registry,我们未来给 Agent 添加任何新能力,都只需要写一个独立的源码文件实现特定接口,然后 Register 进去即可,核心引擎(Main Loop)一行代码都不用改!
代码实战:构建动态 Registry 与 Tool 接口
接下来,我们将把理论转化为纯粹的 Go 代码。
目录结构回顾与更新
今天我们将清空之前测试用的 mockRegistry,并在 internal/tools 目录下实现真正的核心逻辑和 read_file 工具。
go-tiny-claw/
├── cmd/
│ └── claw/
│ └── main.go # 【修改】接入真实的 Registry 和 read_file 工具
├── internal/
│ ├── engine/ # 保持不变
│ ├── provider/ # 保持不变
│ ├── schema/ # 保持不变
│ └── tools/ # 【工具与执行层】(本次核心)
│ ├── registry.go # 【新增】Tool Registry 接口与实现
│ └── read_file.go # 【新增】真实的 read_file 工具实现
├── go.mod
└── go.sum第 1 步:定义 BaseTool 接口
在 internal/tools/registry.go 中,我们首先规范什么样的数据结构可以被称为一个“工具”。
对于 go-tiny-claw 来说,一个工具必须能说出自己的名字、描述,能给出严谨的参数要求(JSON Schema),并且能接收一段原始的 JSON 字节数组去执行具体逻辑。
// internal/tools/registry.go
package tools
import (
"context"
"encoding/json"
"fmt"
"log"
"github.com/yourname/go-tiny-claw/internal/schema"
)
// BaseTool 是所有具体工具必须实现的通用接口
type BaseTool interface {
// Name 返回工具的全局唯一名称 (大模型通过这个名字调用它)
Name() string
// Definition 返回用于提交给大模型的工具元信息和参数 JSON Schema
Definition() schema.ToolDefinition
// Execute 接收大模型吐出的 JSON 参数,执行具体业务逻辑
// 注意:参数是 json.RawMessage,反序列化由各个具体工具内部自行处理
Execute(ctx context.Context, args json.RawMessage) (string, error)
}第 2 步:实现 Registry 的路由与分发
紧接着在同一个文件里,我们实现注册表的挂载和执行逻辑。
// internal/tools/registry.go (续)
// Registry 定义了工具的注册与分发接口
type Registry interface {
// Register 挂载一个新的工具到系统中
Register(tool BaseTool)
// GetAvailableTools 返回当前系统挂载的所有工具的 Schema,供 Main Loop 交给 Provider
GetAvailableTools() []schema.ToolDefinition
// Execute 实际路由并执行模型请求的工具调用
Execute(ctx context.Context, call schema.ToolCall) schema.ToolResult
}
// registryImpl 是 Registry 接口的默认实现
type registryImpl struct {
// 使用 map 以工具的 Name 作为 Key 进行快速 O(1) 路由查找
tools map[string]BaseTool
}
func NewRegistry() Registry {
return ®istryImpl{
tools: make(map[string]BaseTool),
}
}
func (r *registryImpl) Register(tool BaseTool) {
name := tool.Name()
if _, exists := r.tools[name]; exists {
log.Printf("[Warning] 工具 '%s' 已经被注册,将被覆盖。\n", name)
}
r.tools[name] = tool
log.Printf("[Registry] 成功挂载工具: %s\n", name)
}
func (r *registryImpl) GetAvailableTools() []schema.ToolDefinition {
var defs []schema.ToolDefinition
for _, tool := range r.tools {
defs = append(defs, tool.Definition())
}
return defs
}
func (r *registryImpl) Execute(ctx context.Context, call schema.ToolCall) schema.ToolResult {
// 1. 路由查找:如果在注册表中找不到该工具,这是模型产生了幻觉,直接向模型抛出错误
tool, exists := r.tools[call.Name]
if !exists {
errMsg := fmt.Sprintf("Error: 系统中不存在名为 '%s' 的工具。", call.Name)
return schema.ToolResult{
ToolCallID: call.ID,
Output: errMsg,
IsError: true, // 标记为错误,模型看到后会尝试纠正
}
}
// 2. 执行工具逻辑:将原始的 JSON 字节流直接丢给具体工具
output, err := tool.Execute(ctx, call.Arguments)
// 3. 封装结果:将执行结果或底层物理错误封装后返回给 Main Loop
if err != nil {
errMsg := fmt.Sprintf("Error executing %s: %v", call.Name, err)
return schema.ToolResult{
ToolCallID: call.ID,
Output: errMsg,
IsError: true,
}
}
return schema.ToolResult{
ToolCallID: call.ID,
Output: output,
IsError: false,
}
}代码非常清爽。Registry 就像一个忠实的前台总机,只负责接线(接收 ToolCall),查黄页(找 tools map),然后转接给具体的业务部门(具体工具的 Execute 方法)。
第 3 步:编写第一个物理工具 read_file
对于一个 Coding Agent 来说,阅读源代码是它感知物理环境的最基础能力。我们将实现 read_file 工具。
在实现这个工具时,我们将注入驾驭工程(Harness Engineering)中极其重要的防御底线思维:容错与截断。
新建 internal/tools/read_file.go:
// internal/tools/read_file.go
package tools
import (
"context"
"encoding/json"
"fmt"
"io"
"os"
"path/filepath"
"github.com/yourname/go-tiny-claw/internal/schema"
)
// ReadFileTool 实现了读取本地文件内容的工具
type ReadFileTool struct {
// 将引擎的 WorkDir 注入给工具,限制它只能在此目录及其子目录下操作
workDir string
}
func NewReadFileTool(workDir string) *ReadFileTool {
return &ReadFileTool{workDir: workDir}
}
func (t *ReadFileTool) Name() string {
return "read_file"
}
// Definition 向大模型清晰地描述这个工具的用途和参数格式
func (t *ReadFileTool) Definition() schema.ToolDefinition {
return schema.ToolDefinition{
Name: t.Name(),
Description: "读取指定路径的文件内容。请提供相对工作区的路径。",
// 遵循 JSON Schema 规范定义参数
InputSchema: map[string]interface{}{
"type": "object",
"properties": map[string]interface{}{
"path": map[string]interface{}{
"type": "string",
"description": "要读取的文件路径,如 cmd/claw/main.go",
},
},
"required": []string{"path"},
},
}
}
// readFileArgs 内部定义用于反序列化的结构体
type readFileArgs struct {
Path string `json:"path"`
}
func (t *ReadFileTool) Execute(ctx context.Context, args json.RawMessage) (string, error) {
// 1. 延迟解析:将大模型传过来的 JSON 参数解析为强类型结构体
var input readFileArgs
if err := json.Unmarshal(args, &input); err != nil {
// 返回 error 会被 Registry 捕获并传给大模型,模型会知道自己 JSON 格式写错了
return "", fmt.Errorf("参数解析失败: %w", err)
}
// 2. 拼接绝对路径 (注意:生产环境中需要做路径穿越检测防范,防止 ../../etc/passwd)
fullPath := filepath.Join(t.workDir, input.Path)
// 3. 执行物理 IO 操作
file, err := os.Open(fullPath)
if err != nil {
return "", fmt.Errorf("打开文件失败: %w", err)
}
defer file.Close()
content, err := io.ReadAll(file)
if err != nil {
return "", fmt.Errorf("读取文件内容失败: %w", err)
}
// 4. 【核心防线】长度截断保护
// 为了防止大模型读取几百 MB 的日志文件导致 Context 瞬间爆炸 (OOM),
// 我们在工具内部直接进行物理截断。
const maxLen = 8000
if len(content) > maxLen {
truncatedMsg := fmt.Sprintf("%s\n\n...[由于内容过长,已被系统截断至前 %d 字节]...", string(content[:maxLen]), maxLen)
return truncatedMsg, nil
}
return string(content), nil
}请仔细体会这 4 步中的第 4 步(长度截断保护)。
在大模型的 API 调用中,Token 就是金钱,Context 就是生命线。如果你放任大模型读取超大文件,不仅会引发高昂的账单,还会导致上下文爆炸,甚至导致 API 拒绝服务。驾驭工程的真谛就是:绝不把系统的安全性寄希望于大模型的理智,而是在底层的工具实现中强制兜底。
运行与验证:连接真实大脑与真实手脚
一切就绪。让我们回到程序的入口,把“真实的大脑”连接到“真实的手脚”上。为了测试效果,请在你的项目根目录下创建一个测试文件 hello.txt:
echo "Hello, go-tiny-claw 引擎!我是来自物理文件系统的一段神秘文本。大模型今天终于看到了我!" > hello.txt现在,修改 cmd/claw/main.go,移除之前的 mockRegistry,接入正规军:
// cmd/claw/main.go
package main
import (
"context"
"log"
"os"
"github.com/yourname/go-tiny-claw/internal/engine"
"github.com/yourname/go-tiny-claw/internal/provider"
"github.com/yourname/go-tiny-claw/internal/tools"
)
func main() {
// 确保设置了 ZHIPU_API_KEY
if os.Getenv("ZHIPU_API_KEY") == "" {
log.Fatal("请先导出 ZHIPU_API_KEY 环境变量")
}
// 1. 获取工作区物理边界
workDir, _ := os.Getwd()
// 2. 初始化真实的大脑 (指向智谱 GLM-4.5,使用上一讲的 OpenAI 适配器)
llmProvider := provider.NewZhipuOpenAIProvider("glm-4.5-air")
// 3. 初始化真实的 Tool Registry
registry := tools.NewRegistry()
// 4. 将真实的 ReadFile 工具挂载到注册表中
readFileTool := tools.NewReadFileTool(workDir)
registry.Register(readFileTool)
// 5. 实例化核心引擎,由于任务简单,我们关闭思考阶段 (EnableThinking = false) 以加快速度
eng := engine.NewAgentEngine(llmProvider, registry, workDir, false)
// 6. 下发一个必须通过真实工具才能完成的任务
prompt := "请调用工具读取一下当前工作区目录下 hello.txt 文件的内容,并用一句话向我总结它说了什么。"
err := eng.Run(context.Background(), prompt)
if err != nil {
log.Fatalf("引擎运行崩溃: %v", err)
}
}奇迹时刻:Agent 的第一次物理交互
在终端中执行启动命令:
go run cmd/claw/main.go你将看到如下振奋人心的日志流转:
2026/04/06 07:18:05 [Registry] 成功挂载工具: read_file
2026/04/06 07:18:05 [Engine] 引擎启动,锁定工作区: build-agent-harness-from-scratch/part2/source/ch05/go-tiny-claw
2026/04/06 07:18:05 [Engine] 慢思考模式 (Thinking Phase): false
2026/04/06 07:18:05
========== [Turn 1] 开始 ==========
2026/04/06 07:18:05 [Engine][Phase 2] 恢复工具挂载,等待模型采取行动...
🤖 [对外回复]:
2026/04/06 07:18:07 [Engine] 模型请求调用 1 个工具...
2026/04/06 07:18:07 -> 🛠️ 执行工具: read_file, 参数: {"path":"hello.txt"}
2026/04/06 07:18:07 -> ✅ 工具执行成功 (返回 120 字节)
2026/04/06 07:18:07
========== [Turn 2] 开始 ==========
2026/04/06 07:18:07 [Engine][Phase 2] 恢复工具挂载,等待模型采取行动...
🤖 [对外回复]:
文件内容是一个问候语,神秘文本向 go-tiny-claw 引擎打招呼并表达被大模型发现的喜悦。
2026/04/06 07:18:14 [Engine] 模型未请求调用工具,任务宣告完成。看!整个流程行云流水:
- 大模型阅读了 Registry 暴露的
read_file的 JSON Schema,精准推断出需要调用它。 - 模型输出符合要求的 JSON 参数
{"path":"hello.txt"}。 Registry成功将 JSON 路由给ReadFileTool的Execute方法。- Go 语言底层利用
os.Open执行物理 I/O,读取了文本。 - 文本被安全地包装进
ToolResult,反馈给大模型所在的 Main Loop。 - 模型在 Turn 2 中阅读了文件内容,给出了完美的总结!
至此,我们的 go-tiny-claw 真正地睁开了眼睛,看到了现实世界。
反思:关于文件读取截断的思考
在本讲的 read_file 实现中,我们采用了极其“粗暴”的 8000 字符硬截断(Hard Truncation)。作为单工具的兜底防御,这确实能防止单次读取把大模型撑爆。但在真实的实践中,比如代码库探索场景中,如果大模型需要分析一个 20000 行的核心业务类,这种粗暴截断会让模型永远看不到文件的后半部分,导致任务必然失败。
更成熟的解决方案是什么?
工具输出卸载(Tool Call Offloading):工业级 Harness 的主流做法是在工具执行层实现输出卸载策略——当文件或命令输出超过阈值(通常为数千至数万字符)时,Harness 自动将完整内容写入磁盘临时目录,并向模型返回一段“头部预览 + 尾部预览 + 文件路径引用”的摘要消息,例如:“文件过长(共 5000 行,已卸载至 <path>)。以下为首尾预览,如需完整内容请调用 read_file('<path>')。” 通过这种方式,既保留了模型的决策依据,又倒逼其按需局部读取。
结合全局 Context Compaction:即使我们在单工具内通过卸载策略放宽了读取限制,在引擎的全局层面,工业级 Harness 依然在 Main Loop 中设有上下文窗口监控机制。当 Token 使用量接近模型上下文窗口的预设阈值(通常为 75%~98%)时,Harness 会触发 Compaction——对历史会话进行压缩(策略有多种,比如智能摘要等),保留架构决策、未解决的 Bug 等高价值信息,裁剪冗余工具输出,使 Agent 得以在不丢失关键上下文的前提下继续长时运行。关于这道全局级别的终极防 OOM(内存溢出)防线,我们将在专栏的 第 12 讲 为你揭秘。
本讲小结
今天,我们完成了 Harness 工程中极度核心的一环:将抽象的意图落地为具体的物理执行。
- Tool Registry 架构之美:它充当了模型意图(JSON)与系统级代码(Go Function)之间的绝缘层。有了它,为 Agent 扩充新技能变得像堆乐高积木一样简单,且不会污染核心控制流。
- 严格的契约精神:通过实现
BaseTool接口,我们强制每个工具必须清晰地描述自己的能力和InputSchema。这是大模型能够准确调用工具的基础前提。 - 底线防御思维:在实现
read_file时,我们主动加入了基于长度的物理截断。记住:大模型是冲动且无知的,一切可能导致系统 OOM(内存溢出)或超支的风险,必须在执行层被死死按住。
有了注册表,我们是不是应该趁热打铁,给 Agent 挂载几十个、上百个工具,甚至引入极其复杂的 MCP(Model Context Protocol)协议,把它打造成一个“万能兵器”呢?
恰恰相反!在下一讲中,我们将探索 OpenClaw 中最受争议但也最伟大的设计哲学——极简工具集法则与 YOLO(You Only Live Once)模式。我们将剖析为什么顶级 Coding Agent 只需要 Read、Write、Bash 这寥寥几个基础工具,就能实现近乎无所不能的复杂功能。
注:本讲的示例代码,可以在这里下载。
思考题
在目前的 Registry.Execute 方法中,如果工具执行返回了 error,我们将错误信息格式化为了纯文本,并通过 schema.ToolResult{ IsError: true } 的形式反馈给了大模型。
大模型收到错误日志后(比如:“文件不存在:路径解析错误”),通常会在下一个 Turn 尝试自己修改路径参数并重新发起请求。这被称为大模型的自纠错能力(Self-Correction)。
结合驾驭工程的理念,你认为这种“完全依靠大模型去盲目试错重试”的机制,在真实的工业场景下会存在什么致命隐患?如果在 Registry 层面或者外围框架层面,你会设计什么样的防线来控制这种潜在的失控重试?
欢迎在留言区分享你的工程设计思路,我们将在后续的第14和15 讲中为你揭晓解法。我们下一讲见!
精选评论
heel: https://github.com/QDeepFlow/my-harness 基于课程内容采用python实现的
编辑回复: 感谢,已经置顶了,可以给Python的同学参考👍
shuff1e: 完全依赖大模型自纠错重试,在工业场景有三大隐患:放大故障、误操作风险、成本失控。模型基于不完整错误信息盲目试错,可能越修越错,甚至形成无限循环。
工程上必须加防线:返回结构化错误(标明是否可重试)、设置重试预算、区分工具风险等级(写操作需严格限制)、约束参数变化范围、引入熔断机制。
本质:让模型负责“想”,系统负责“控”,避免失控执行。
编辑回复: 很棒的思考
兵戈: 我会设计 三层防御,从内到外分别是:Registry 层、ReAct 引擎层、外围框架层。
第一层:Registry 层 — 快速失败 + 错误分类
工具执行返回 error 时,不要直接扔给大模型去猜。Registry 应该对错误进行分类, 对于不可恢复的错误直接阻断重试。
第二层:ReAct 引擎层 — 重试预算 + 循环检测
即使 Registry 允许重试,ReAct 循环也需要控制重试的上限和模式。
第三层:外围框架层 — 断路器 + 人工介入 框架层负责全局的安全兜底。
核心理念:大模型的自纠错能力是宝贵的,但不能让它裸奔。 驾驭工程的核心思想是:给予能力,同时设置护栏。让大模型在安全范围内发挥创造力,在边界之外用确定性逻辑兜底。
作者回复: 👍
一群人儿: 大模型收到错误日志后(比如:“文件不存在:路径解析错误”),通常会在下一个 Turn 尝试自己修改路径参数并重新发起请求。这被称为大模型的自纠错能力(Self-Correction),我使用的模型,直接告诉我,文件不存在,没有自纠错行为啊
作者回复: 两个原因:
- 模型智商不够:某些参数较小的模型(如 7B/14B)没有涌现出强大的 Self-Correction 能力。
- 缺乏系统级诱导:这就是我们在 第 14 讲 (Error Recovery) 要解决的问题!仅仅返回 文件不存在 往往不够,你还需要在底层加上一些错误处理的引导指令,这样即便小模型可能也会去重试纠错。
晴天了: 老师认为 Agent的代码 是应该由AI写还是由程序员去写?
作者回复: 我理解这没有应该不应该。
目前从anthropic暴露出的公共资料来看,当前的claude code的代码基本都是由ai来写的了。但我觉得最早的claude code代码应该是人工编写的。中期可能是混合编写,目前全是ai写。
所以这可能是一个不同阶段/不同时期有着不同答案的问题。
黑马程序员: https://github.com/lastwhispers/timegeek-java-agent-harness 基于课程内容采用java实现的
作者回复: 👍
Jaising: 完全靠模型推理就违背了前面提到的 Harness 设计原则——模型负责想,Registry / Runtime 负责控,除了上下文污染、token 消耗外,最大的隐患是如果是 bash、write_file 这些操作就不只是多读几个文件的问题了,都有可能触发堪比 rm -rf 的破坏性,解决方法可以是增加 ToolResult 错误状态诱导模型重试路线,并在 Registry 增加熔断措施,比如根据 tool 类型判断是否自纠错、路径穿越检查、人工核验等
我也来补充一个基于 Tony Bai 课程内容指导 GPT 完成 Java 版本实现的:git@github.com:JaisingZ/java-tiny-claw.git
作者回复: 👍
Cy23: 水平有限,啃起来有点费劲,还好有AI辅助讲解,我一定要坚持下来,加油
编辑回复: 加油,一定可以的
davix: "底层加上一些错误处理的引导指令"這種“系统级诱导”的思想,是不是跟RESTful 類似,每個 API 都包含可能的下一步操作?
作者回复: 非常好的想法。14讲有和你“异曲同工”的思路。
TheOne: 当文件或命令输出超过阈值(通常为数千至数万字符)时,Harness 自动将完整内容写入磁盘临时目录,并向模型返回一段“头部预览 + 尾部预览 + 文件路径引用”的摘要消息
如果文件是 1 个 G,难道要复制1个G吗?不可能吧? 我理解如果是文件,就生成摘要,然后让llm部分读取就解决了文件过大的问题 如果是命令行的返回值过大,那确实只能写到临时文件里,所以我理解复制文件的操作,只发生在命令行上
作者回复: 👍。后续上下文压缩的章节中,还有有进一步探讨。本专栏的讲解思路也是逐步演进和优化的。当前的实现不一定是最后的、最终实现,可能只是一个阶段性的。
麦耀锋: 按照渐进式披露的原则, 工具的结构上还可以将Definition拆分为两个,一个是描述(有一定的长度限制),用于初始化加载,让大模型知道哪些工具能干什么;另一部分是详细描述,包括输入输出参数、调用方式等,让大模型确定具体调用哪个工具后,再读取这部分内容来确定更详细信息。
当然,上述说法更适合那种自定义的工具,如果是按老师说的如果整个系统只有这么极简的4个工具,那么就没有必要。
作者回复: 👍
欧雄虎(Badguy): 架构好清晰
作者回复: [手动抱拳]
窥视未来: 工具输出卸载到磁盘后,假如重新从磁盘读取还是超过上下文大小呢?
作者回复: 我们在 read_file 工具里同样设计了物理级的硬截断(第05讲步骤3)。哪怕它在下个 Turn 试图强读那个几十 MB的临时文件,read_file 也只会返回前 N 个字节。
在后续章节讲解上下文压缩后,也可以考虑放开read_file的限制,而在上下文压缩这一层来设置“屏障”,比如通过摘要算法获得摘要信息,再提供给大模型。
整个专栏是一个循序渐进,不断重构的节奏。你现在遇到的问题,在后面都会有涉及和一些解决方案。
Geek_376f3f: 没有冒犯之意但是 这样的在 tools pkg 下 ReadFileTool 这样的 registryImpl 真是一股子 ai 味,根本不符合 go 命名的社区规范
Ryan: 完全依赖大模型的盲目试错会存在误操作风险
lJ: 问题一
- 错误上下文累积导致模型判断力下降
- 危险操作在错误状态下的破坏力放大
- 成本失控
问题二
- 添加连续失败计数器,防止固执重试
- 对错误分类,区分可重试/参数错误/致命错误
- Budget 熔断, 控制资源消耗