07|容错艺术:实现支持多级模糊匹配的稳健 Edit 工具
作者:Tony Bai
加入专属的 edit_file(代码编辑)工具
你好,我是Tony Bai。欢迎来到《从0开始构建 Agent Harness》专栏的第七讲。
在上一讲中,我们探讨了OpenClaw的极简工具法则,并用 Go 原生的 os/exec 为 Agent 打造了终极武器——bash 工具。配合 read_file 和 write_file,我们的 go-tiny-claw 已经能够在文件系统中自由穿梭。
现在,设想这样一个真实的业务场景:你的代码库里有一个长达 2000 行的 server.go 文件。你让 Agent 去修复其中第 543 行的一个空指针逻辑 Bug。
Agent 读懂了代码,它知道怎么改。但接下来,它应该如何把改动落回磁盘?
如果用 write_file,它必须把这 2000 行代码完整地重新生成一遍。这不仅极其消耗 API Token(既慢又贵),而且大模型在长文本生成中极易发生截断或引入新的语法错误。
如果用 bash,大模型需要手写一段极其复杂的 sed 或 awk 正则表达式。但经验表明,大模型在处理包含特殊转义字符的多行正则表达式时,翻车率高达 80% 以上,极易把整个文件搞坏。
这就是为什么在驾驭工程(Harness Engineering)中,除了提供底层的原语外,我们必须为大模型提供一把“外科手术刀”——也就是专属的 edit_file(代码编辑)工具。
然而,大模型是一台基于概率的机器,它常常带有幻觉。今天,我们就来直面大模型最大的幻觉之一:格式丢失。我们将亲手实现一个带有多级模糊匹配(Fuzzy Match)容错机制的强健 Edit 工具,学习驾驭工程中的容错艺术。
大模型的“缩进幻觉”与模糊匹配
对于一个理想的 edit 工具,它的 JSON Schema 应该非常简单:提供 path(文件路径)、old_text(你要替换的旧代码)和 new_text(新代码)。
如果用 Go 语言的思路,底层实现无非就是一句 strings.Replace(fileContent, oldText, newText, 1)。但在 AI Agent 的世界里,绝对不能这么写。
大模型在输出 old_text 时,经常会犯一种极其顽固的错误——格式幻觉。
假设原始代码是这样的(前面带有 8 个空格的缩进):
if user == nil {
return err
}大模型在返回的 JSON 工具参数中,为了节省字数或者受限于其内部的注意力机制,它吐出的 old_text 很可能是去掉了缩进的:
if user == nil {
return err
}如果你使用精确匹配,strings.Replace 会直接失败,因为找不到要替换的字符串。在没有容错机制的 Harness 中,Agent 会收到 Error: old_text not found。接着,Agent 会在下一个 Turn 拼命重试,依然不带缩进,最终陷入死循环,任务宣告失败。
降级策略:多级模糊匹配链(Chain of Responsibility)
顶级引擎(如 Claude Code/OpenClaw)是如何解决这个问题的?答案是:把容错做在底层工具里,吸收大模型的误差。
我们不再要求精确匹配,而是实现一条多级模糊匹配链。
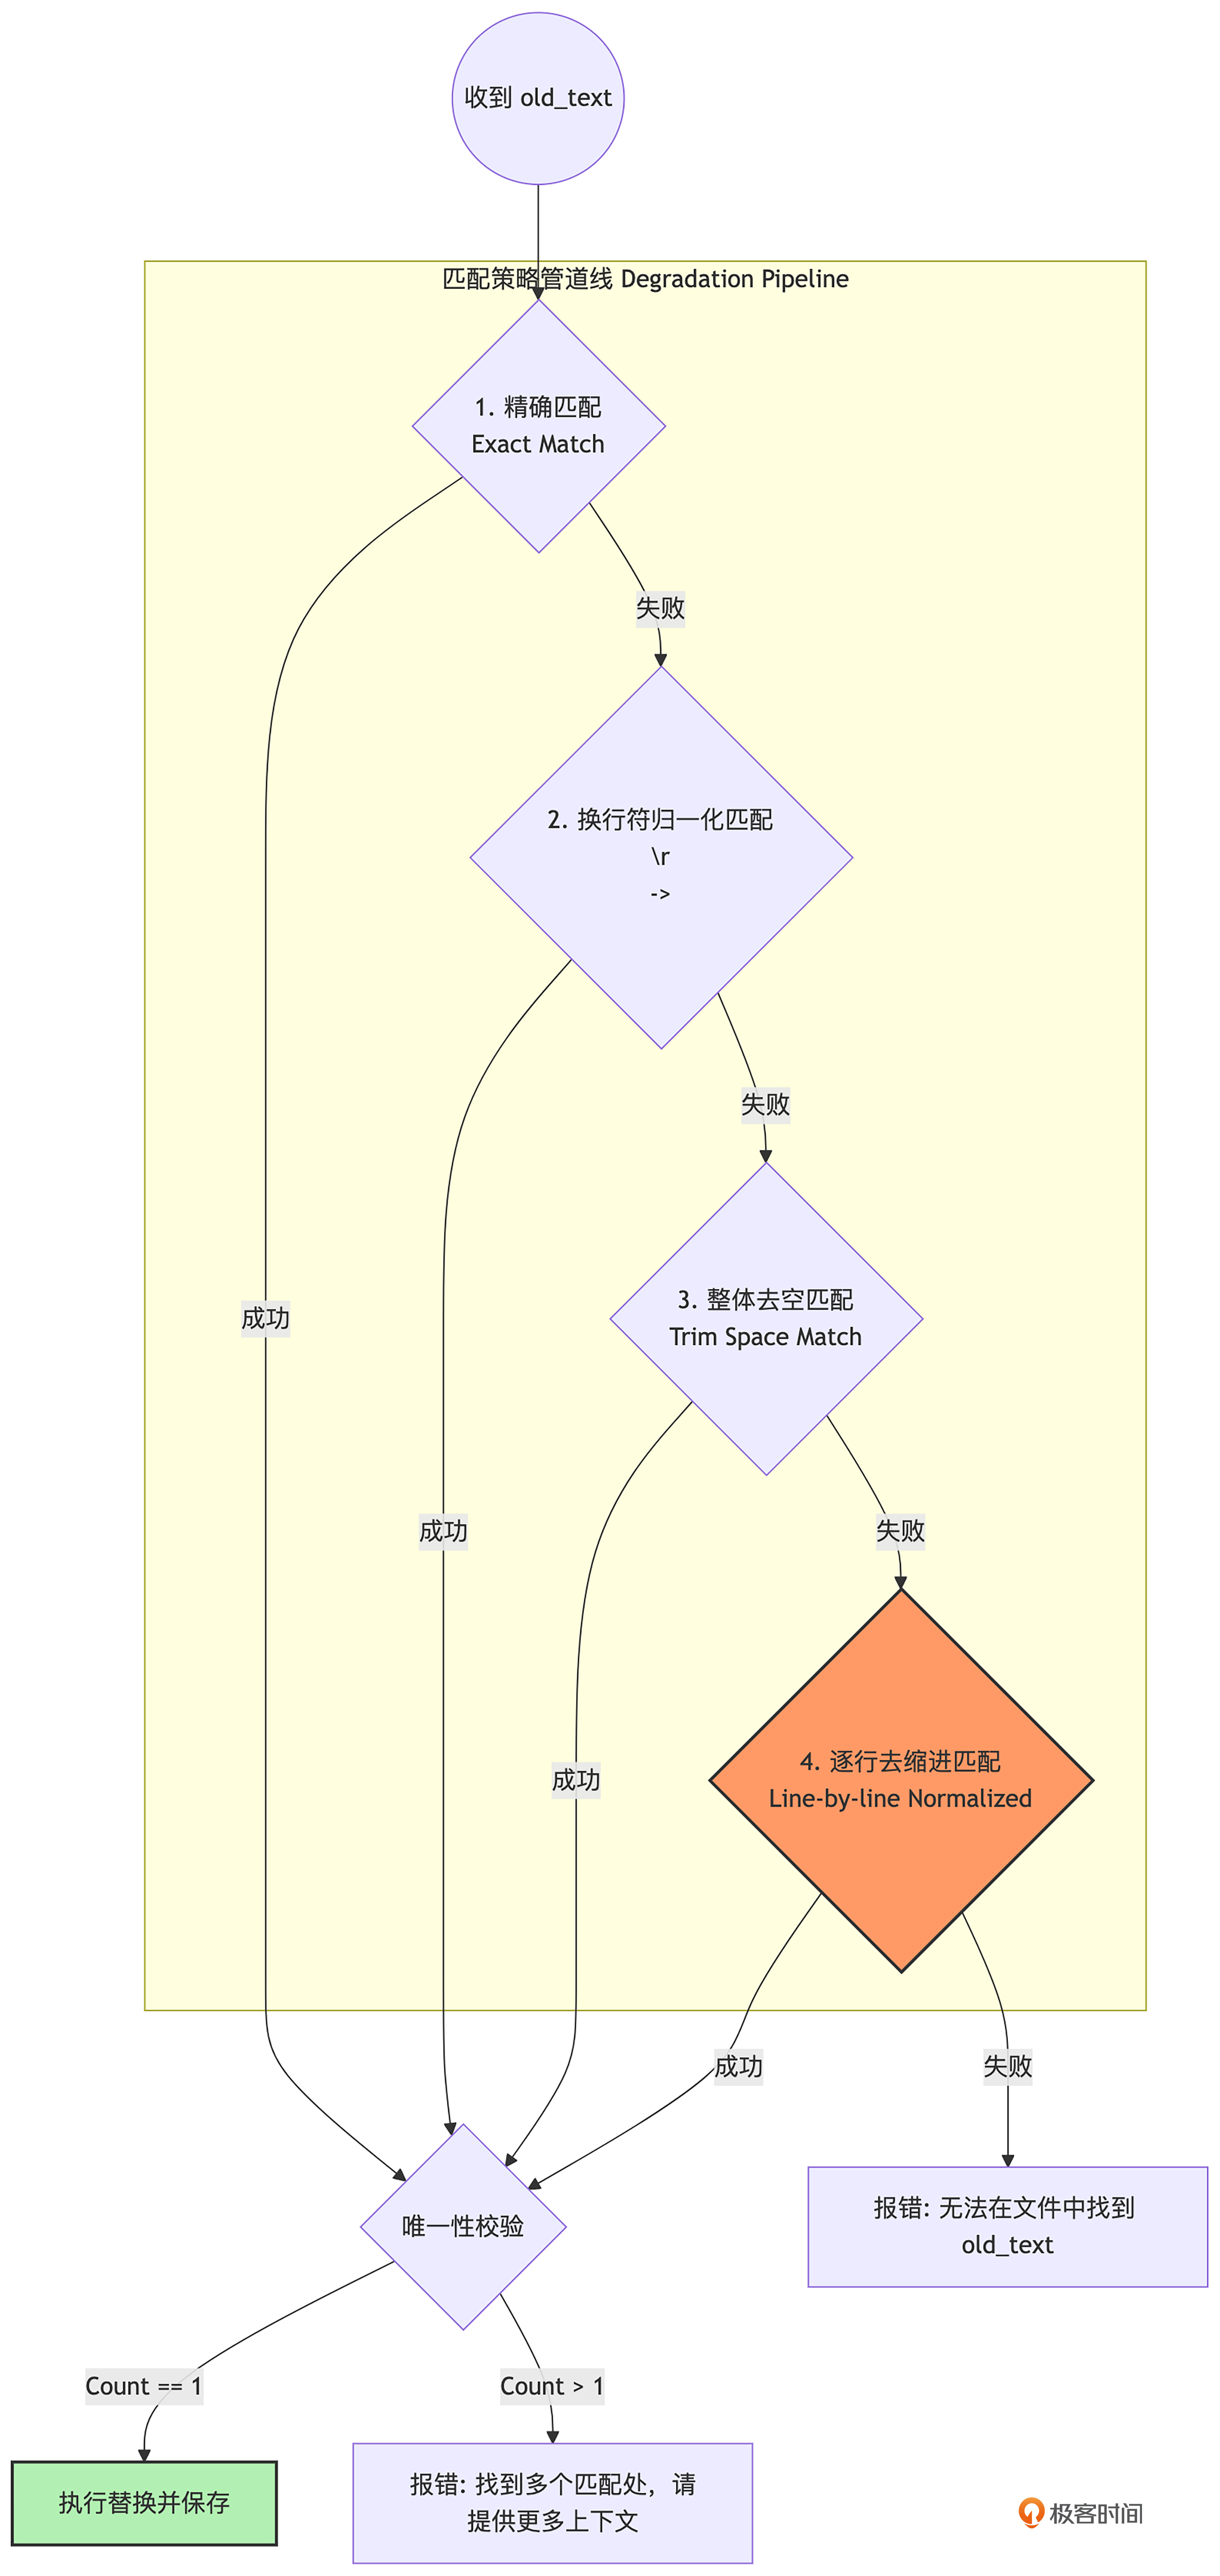
在这套多级匹配的管道线中:
- 级别 1:最快最安全的精确匹配。
- 级别 2:解决不同操作系统(Windows vs Unix)换行符导致的幻觉。
- 级别 3:忽略整个代码块首尾的多余空行。
- 级别 4(核心容错):将
old_text和原始文件都按行切分,去掉每一行的首尾空格(消除缩进差异),然后再进行比对。
最关键的安全底线是“唯一性校验”:模糊匹配可能会导致匹配到代码里多个相似的片段。如果匹配结果 > 1,工具绝对不能盲目替换,而是必须抛出错误,要求大模型提供更多的上下行代码以精确定位。
代码实战:实现健壮的 Edit 工具
接下来,我们将用 Go 语言将这套容错艺术转化为代码。
目录结构回顾与更新
我们将在 internal/tools 目录下新增 edit_file.go。
go-tiny-claw/
├── cmd/
│ └── claw/
│ └── main.go # 【修改】注册 Edit 工具,并测试修改代码场景
├── internal/
│ ├── engine/ # 保持不变
│ ├── provider/ # 保持不变
│ ├── schema/ # 保持不变
│ └── tools/
│ ├── registry.go # 保持不变
│ ├── read_file.go
│ ├── write_file.go
│ ├── bash.go
│ └── edit_file.go # 【新增】多级模糊匹配替换工具
├── go.mod
└── go.sum第 1 步:定义工具与 JSON Schema
新建 internal/tools/edit_file.go,首先完成工具的标准化定义。我们需要在 Description 中用自然语言教导大模型如何使用这个工具。
// internal/tools/edit_file.go
package tools
import (
"context"
"encoding/json"
"fmt"
"os"
"path/filepath"
"strings"
"github.com/yourname/go-tiny-claw/internal/schema"
)
type EditFileTool struct {
workDir string
}
func NewEditFileTool(workDir string) *EditFileTool {
return &EditFileTool{workDir: workDir}
}
func (t *EditFileTool) Name() string {
return "edit_file"
}
func (t *EditFileTool) Definition() schema.ToolDefinition {
return schema.ToolDefinition{
Name: t.Name(),
Description: "对现有文件进行局部的字符串替换。这比重写整个文件更安全、更快速。请提供足够的 old_text 上下文以确保匹配的唯一性。",
InputSchema: map[string]interface{}{
"type": "object",
"properties": map[string]interface{}{
"path": map[string]interface{}{
"type": "string",
"description": "要修改的文件路径",
},
"old_text": map[string]interface{}{
"type": "string",
"description": "文件中原有的文本。必须包含足够的上下文(建议上下各多包含几行),以确保在文件中的唯一性。",
},
"new_text": map[string]interface{}{
"type": "string",
"description": "要替换成的新文本",
},
},
"required": []string{"path", "old_text", "new_text"},
},
}
}
type editFileArgs struct {
Path string `json:"path"`
OldText string `json:"old_text"`
NewText string `json:"new_text"`
}第 2 步:实现多级模糊匹配算法
这是本讲的灵魂代码。为了保持代码整洁,我们将模糊匹配逻辑抽离成一个内部函数 fuzzyReplace。
// internal/tools/edit_file.go (续)
// fuzzyReplace 实现了四级容错降级替换算法
func fuzzyReplace(originalContent, oldText, newText string) (string, error) {
// L1: 精确匹配
count := strings.Count(originalContent, oldText)
if count == 1 {
return strings.Replace(originalContent, oldText, newText, 1), nil
}
if count > 1 {
return "", fmt.Errorf("old_text 匹配到了 %d 处,请提供更多的上下文代码以确保唯一性", count)
}
// L2: 换行符归一化 (统一将 \r\n 转换为 \n)
normalizedContent := strings.ReplaceAll(originalContent, "\r\n", "\n")
normalizedOld := strings.ReplaceAll(oldText, "\r\n", "\n")
count = strings.Count(normalizedContent, normalizedOld)
if count == 1 {
return strings.Replace(normalizedContent, normalizedOld, newText, 1), nil
}
// L3: Trim Space 匹配 (忽略首尾的空行和空格)
trimmedOld := strings.TrimSpace(normalizedOld)
if trimmedOld != "" {
count = strings.Count(normalizedContent, trimmedOld)
if count == 1 {
// 注意:这里替换时,我们只能替换被 Trim 后的部分,不能直接用 newText 破坏原本的缩进
// 为了保持本专栏代码不过于冗长复杂,当触发 L3/L4 时,如果 newText 没有带有正确的缩进,
// 可能会导致替换后代码格式不美观。但这总比直接报错让 Agent 死循环要好。
return strings.Replace(normalizedContent, trimmedOld, newText, 1), nil
}
}
// L4: 逐行去缩进匹配 (最强力的容错:消除大模型遗漏缩进的幻觉)
return lineByLineReplace(normalizedContent, normalizedOld, newText)
}
// lineByLineReplace 将文本按行切割,去除首尾空白后进行滑动窗口匹配
func lineByLineReplace(content, oldText, newText string) (string, error) {
contentLines := strings.Split(content, "\n")
oldLines := strings.Split(strings.TrimSpace(oldText), "\n")
if len(oldLines) == 0 || len(contentLines) < len(oldLines) {
return "", fmt.Errorf("找不到该代码片段")
}
// 清理 oldLines 的每行首尾空白
for i := range oldLines {
oldLines[i] = strings.TrimSpace(oldLines[i])
}
matchCount := 0
matchStartIndex := -1
matchEndIndex := -1
// 滑动窗口在原始文件中寻找匹配块
for i := 0; i <= len(contentLines)-len(oldLines); i++ {
isMatch := true
for j := 0; j < len(oldLines); j++ {
if strings.TrimSpace(contentLines[i+j]) != oldLines[j] {
isMatch = false
break
}
}
if isMatch {
matchCount++
matchStartIndex = i
matchEndIndex = i + len(oldLines)
}
}
if matchCount == 0 {
return "", fmt.Errorf("在文件中未找到 old_text,请大模型先调用 read_file 仔细确认文件内容和缩进")
}
if matchCount > 1 {
return "", fmt.Errorf("模糊匹配到了 %d 处相似代码,请提供更多上下行代码以精确定位", matchCount)
}
// 执行替换:将匹配到的原始行范围替换为 newText 拆分后的行
// (这里简单处理,将 newText 直接作为整体替换进去)
var newContentLines []string
newContentLines = append(newContentLines, contentLines[:matchStartIndex]...)
newContentLines = append(newContentLines, newText) // 插入新内容
newContentLines = append(newContentLines, contentLines[matchEndIndex:]...)
return strings.Join(newContentLines, "\n"), nil
}第 3 步:组装 Execute 方法
最后,我们将这个算法接入 Execute 流程,补齐读取和回写的物理 I/O 操作。
// internal/tools/edit_file.go (续)
func (t *EditFileTool) Execute(ctx context.Context, args json.RawMessage) (string, error) {
var input editFileArgs
if err := json.Unmarshal(args, &input); err != nil {
return "", fmt.Errorf("参数解析失败: %w", err)
}
fullPath := filepath.Join(t.workDir, input.Path)
// 1. 读取原文件内容
contentBytes, err := os.ReadFile(fullPath)
if err != nil {
return "", fmt.Errorf("读取文件失败,请确认路径是否正确: %w", err)
}
originalContent := string(contentBytes)
// 2. 调用多级模糊替换算法
newContent, err := fuzzyReplace(originalContent, input.OldText, input.NewText)
if err != nil {
// 【驾驭哲学】将具体的报错原因 (如匹配到多处) 原样返回,让大模型自行纠正
return "", err
}
// 3. 将新内容安全地写回磁盘
if err := os.WriteFile(fullPath, []byte(newContent), 0644); err != nil {
return "", fmt.Errorf("写回文件失败: %w", err)
}
return fmt.Sprintf("✅ 成功修改文件: %s", input.Path), nil
}代码完成!你不要将其简单看成是一个字符串替换工具,这是一个包容了大模型缺陷的“防御阵地”。
运行与实战测试:检验容错能力
现在,让我们在 cmd/claw/main.go 中挂载这个新工具,并故意给大模型设置一个陷阱:我们将在物理文件中包含很多缩进,看看大模型生成的缺少缩进的 old_text 能否被成功匹配和替换。
首先,在工作区根目录下创建一个有格式的测试文件 server.go:
cat << 'EOF' > server.go
package main
import "fmt"
func main() {
// 启动服务器
fmt.Println("Server is starting on port 8080...")
// TODO: 增加鉴权逻辑
if true {
fmt.Println("No auth, everyone can access.")
}
}
EOF接着,更新 cmd/claw/main.go,将 EditFileTool 挂载进去。虽然这是修改代码的任务,但我们给Agent的任务提示词仅仅是一次简单的代码替换。因此,这里我们关闭了慢思考。如果开启慢思考,会出现什么问题呢?大家也不妨思考一下。
// cmd/claw/main.go
package main
import (
"context"
"log"
"os"
"github.com/yourname/go-tiny-claw/internal/engine"
"github.com/yourname/go-tiny-claw/internal/provider"
"github.com/yourname/go-tiny-claw/internal/tools"
)
func main() {
if os.Getenv("ZHIPU_API_KEY") == "" {
log.Fatal("请先导出 ZHIPU_API_KEY 环境变量")
}
workDir, _ := os.Getwd()
llmProvider := provider.NewZhipuOpenAIProvider("glm-4.5-air")
registry := tools.NewRegistry()
// 挂载工具全家桶
registry.Register(tools.NewReadFileTool(workDir))
registry.Register(tools.NewWriteFileTool(workDir))
registry.Register(tools.NewBashTool(workDir))
// 【新增挂载】
registry.Register(tools.NewEditFileTool(workDir))
// 实例化引擎,开启 EnableThinking = true
eng := engine.NewAgentEngine(llmProvider, registry, workDir, false)
// 发起一个需要局部修改的指令
prompt := `
我当前目录下有一个 server.go 文件。
请帮我把里面 "TODO: 增加鉴权逻辑" 下面的那个 if 语句,整个替换为:
if user == nil {
fmt.Println("Forbidden!")
return
}
`
err := eng.Run(context.Background(), prompt)
if err != nil {
log.Fatalf("引擎运行崩溃: %v", err)
}
}执行与奇迹时刻
运行命令:
go run cmd/claw/main.go观察终端中大模型的行为。由于大模型无法直接看到文件,它首先会调用 read_file,然后再调用 edit_file。
最精彩的部分在于,大模型吐出的 ToolCall 参数中,old_text 很可能是没有携带那 4 个空格缩进的。这个因使用的大模型的不同,可能看到的现象不同:
{
"path": "server.go",
"old_text": "// TODO: 增加鉴权逻辑\nif true {\nfmt.Println(\"No auth, everyone can access.\")\n}",
"new_text": "if user == nil {\n\tfmt.Println(\"Forbidden!\")\n\treturn\n}"
}如果在传统框架里,这一步直接抛出 old_text not found 报错。
但在我们的 go-tiny-claw 中,输出日志如下(以下是在我的环境下执行的输出结果):
20206/04/07 10:40:26 [Registry] 成功挂载工具: read_file
20206/04/07 10:40:26 [Registry] 成功挂载工具: write_file
20206/04/07 10:40:26 [Registry] 成功挂载工具: bash
20206/04/07 10:40:26 [Registry] 成功挂载工具: edit_file
20206/04/07 10:40:26 [Engine] 引擎启动,锁定工作区: build-agent-harness-from-scratch/part2/source/ch07/go-tiny-claw
20206/04/07 10:40:26 [Engine] 慢思考模式 (Thinking Phase): false
20206/04/07 10:40:26
========== [Turn 1] 开始 ==========
20206/04/07 10:40:26 [Engine][Phase 2] 恢复工具挂载,等待模型采取行动...
🤖 [对外回复]:
我需要先读取 server.go 文件来查看当前的内容,然后找到 "TODO: 增加鉴权逻辑" 下面的 if 语句并进行替换。
20206/04/07 10:40:29 [Engine] 模型请求调用 1 个工具...
20206/04/07 10:40:29 -> 🛠️ 执行工具: read_file, 参数: {"path":"server.go"}
20206/04/07 10:40:29 -> ✅ 工具执行成功 (返回 231 字节)
20206/04/07 10:40:29
========== [Turn 2] 开始 ==========
20206/04/07 10:40:29 [Engine][Phase 2] 恢复工具挂载,等待模型采取行动...
🤖 [对外回复]:
20206/04/07 10:40:49 [Engine] 模型请求调用 1 个工具...
20206/04/07 10:40:49 -> 🛠️ 执行工具: edit_file, 参数: {"path":"server.go","old_text":"// TODO: 增加鉴权逻辑\n if true {\n fmt.Println(\"No auth, everyone can access.\")\n }","new_text":"// TODO: 增加鉴权逻辑\n if user == nil {\n fmt.Println(\"Forbidden!\")\n return\n }"}
20206/04/07 10:40:49 -> ✅ 工具执行成功 (返回 33 字节)
20206/04/07 10:40:49
========== [Turn 3] 开始 ==========
20206/04/07 10:40:49 [Engine][Phase 2] 恢复工具挂载,等待模型采取行动...
🤖 [对外回复]:
已经成功将 server.go 文件中 "TODO: 增加鉴权逻辑" 下面的 if 语句替换为您提供的代码。
修改前:
// TODO: 增加鉴权逻辑
if true {
fmt.Println("No auth, everyone can access.")
}
修改后:
// TODO: 增加鉴权逻辑
if user == nil {
fmt.Println("Forbidden!")
return
}
现在鉴权逻辑会检查 user 是否为 nil,如果为空则输出 "Forbidden!" 并返回,实现了基本的鉴权功能。
20206/04/07 10:40:51 [Engine] 模型未请求调用工具,任务宣告完成。注:我使用的大模型比较聪明,并没有丢掉原先文本的“格式”。
打开 server.go 文件,你会发现那段包含缩进的原始代码,被完美且精准地替换成了新的逻辑。
$cat server.go
package main
import "fmt"
func main() {
// 启动服务器
fmt.Println("Server is starting on port 8080...")
// TODO: 增加鉴权逻辑
if user == nil {
fmt.Println("Forbidden!")
return
}
}这就是多级模糊匹配在底层悄无声息地为你化解危机的表现。
本讲小结
今天,我们通过手写一个看似普通的 edit 工具,深入洞察了驾驭工程的另一重境界:容错艺术。
- 正视大模型缺陷:大模型本质上是一个概率预测引擎,要求它 100% 精确输出多行代码的缩进和特殊符号是不现实的。硬抗只会导致死循环。
- 降级管线(Degradation Pipeline):我们在底层设计了 L1 到 L4 四个级别的匹配算法,从精确匹配一路降级到“逐行去空格匹配”。这就像是给 Agent 戴上了一副“宽容的眼镜”,自动矫正了它的幻觉。
- 唯一性安全底线:在容错的同时,我们坚守了“如果匹配到多处,绝不替换”的安全底线。把
count > 1的报错原样丢回给大模型,让大模型自己提供更多上下文。这完美利用了 LLM 强大的 Self-Correction(自我纠错)能力。
至此,我们的 go-tiny-claw 在单轮(Turn)的串行执行上已经“无懈可击”。但是,现代大模型的 API 实际上早就支持了 Parallel Tool Calling(并行工具调用)。这意味着在一次思考中,大模型可能会一次性吐出 5 个 read_file 的请求,要求同时读取 5 个独立的文件。
按照我们目前在 loop.go 中的 for 循环写法,这 5 个文件会被阻塞地逐个读取。这在网络和磁盘 I/O 上是极大的浪费。
在下一讲中,我们将充分发挥 Go 语言作为云原生霸主的优势,用 Goroutine 和 WaitGroup 重构 Main Loop 的工具执行环节,让我们的 Agent 拥有真正并发探索物理世界的高性能能力!
注:本讲的示例代码,可以在这里下载。
思考题
在我们今天的 L4 逐行模糊匹配(lineByLineReplace)算法中,虽然我们成功去除了首尾空格的干扰找到了匹配块,但在进行文本替换时,我们采用了一个极其粗暴的做法:直接将原有的那几行删掉,塞入未经任何处理的 newText。
这会带来一个小问题:如果目标代码块是在一个嵌套极深的函数中(比如前面有 12 个空格的缩进),而大模型输出的 newText 只有 4 个空格的缩进,替换完之后,这部分代码的格式就会显得非常难看。
结合你对字符串处理的经验,如果在匹配到目标行的同时,我们要提取出目标行原来的“基础缩进前缀(Base Indentation)”,并将其自动补齐到 newText 的每一行前面,你会如何在现有的 lineByLineReplace 中进行代码优化?
欢迎在留言区分享你的代码思路。我们下一讲,开启并发提效之旅!
精选评论
蹲蹲兽: 不如改成直接用行号编辑,提供一个editline工具,参数为 起始行号,结束行号,内容。这样就不需要考虑文本替换的问题了🤔
作者回复: 不错的idea。不过在实际运行中,要看大模型对行号的幻觉如何,记得有研究说过,大模型对行号幻觉比较严重。
Jaising: L1 精确匹配,L2 换行归一化,L3 首尾裁剪,L4 逐行去空格模糊匹配,L4 命中后,可以提取原匹配块第一条非空行的基础缩进,这里会有个问题就是语法理解,个人感觉不适合放进 edit_file 原语完成,而是交给 bash 再做 format 指令,比如由 format 去适配 Java 中的 mvn spotless:apply,mvn formatter:format 这些格式化操作,就像 cc 或者 codex 修改一个文件会对文件做统一格式化一样
作者回复: 嗯,大模型写完代码后,下一步紧跟一个 format动作,这既能纠正缩进,还能做语法静态检查(Lint),提高后续通过edit_file完成“修改”的精度。
这里,把缩进对齐做在 edit_file 工具内部),能降低交互轮数,但的确增加了底层维护成本,看个人权衡吧。
甜甜的咸鱼: 我也调用的是 glm-4.5-air,server.go存放在 go-tiny-claw\server.go下,运行文章中的代码,观察 日志出现了两个问题,1 文件找到了,但是调用 read_file返回字节0,后续大模型通过 cat 命令读取到了信息 2大模型直接把server.go中的内容全删除了,只保留 if user==nil那个逻辑。 后续 我进行了两次重试 ,第一次 绝对路径明确了server.go的位置 发现效果符合预期,第二次 重新本文的实验 发现竟然又好了。 有点懵了
作者回复: 大模型本质就是概率性的。不要因为大模型偶尔的“抽风”而怀疑工具的设计,驾驭工程的本质,就是用底层的确定性代码,去兜住大模型上层的不确定性。不断优化,最终让你的agent harness的“成功率”高于你预期的百分比,你就成功了。
davix: 如果是我用腳本修改文件,會生成一個diff,再patch。不知道LLM會不會這麼做,當edit_file用
作者回复: 这是一个很自然的想法。其实在早期的 Agent 探索中(包括一些基于 Llama 等开源模型的项目),确实尝试过让 LLM 生成标准的 unified diff 格式再用 patch 甚至 git apply 执行。 但这在工程上失败率极高。因为 LLM存在较为严重的“行号幻觉”和“缩进幻觉”。
snow: 想请问下老师, 本章主要解决的是缩紧幻觉, 那么为什么不优先采用diff / patch, fall back 到text fuzzy replace 呢?
作者回复: 这是一个非常经典的方案选型问题。业界早期确实尝试过让大模型输出标准的 unified diff 或 patch 格式,然后底层直接调用 git apply 或 patch 命令。但真实工程数据表明,这种方式的失败率较高。
有几个原因,比如大模型的“行号幻觉”较为严重。diff 强依赖于上下文的确切行号。在经过多轮对话或复杂思考后,大模型几乎不可能算对当前的绝对行号。此外,相比于冷冰冰的 diff 符号,大模型更擅长(也更容易被训练为)输出“把这段 A 替换为 B”的自然语言结构。
Lee: // L1: 精确匹配 count := strings.Count(originalContent, oldText) if count == 1 { return strings.Replace(originalContent, oldText, newText, 1), nil }
这个逻辑有问题吧,如果大模型输出的去空格后的内容正好匹配上了代码中其中一段不是我们早替换得内容,不就有问题
作者回复: 在代码的 L1 阶段,执行的是“绝对精确匹配(Exact Match)”。此时的 oldText是大模型生成的原始字符串,并没有经过任何去空格(Trim)或归一化处理。只有当 L1 失败(比如模型自己吃掉了缩进,导致 count == 0)时,我们才会降级到后面的 L3 或 L4 去做去空格匹配。
Geek_d6f50f: // 滑动窗口在原始文件中寻找匹配块 for i := 0; i <= len(contentLines)-len(oldLines); i++ { isMatch := true for j := 0; j < len(oldLines); j++ { if strings.TrimSpace(contentLines[i+j]) != oldLines[j] { isMatch = false break } } if isMatch { matchCount++ matchStartIndex = i matchEndIndex = i + len(oldLines) } } 这里的匹配规则是不是有问题呢?这个匹配方法,仅仅能匹配到oldLines中的一行,如果多行匹配到,则就报错了,预期不是匹配整个oldText吗?
作者回复: 这个算法其实是匹配了整个多行的 oldText 块的。
让我们拆解一下这个滑动窗口算法:
- 外层循环 for i 遍历的是真实文件(contentLines),i 代表当前窗口的起始行。
- 内层循环 for j 遍历的是大模型提供的旧代码块(oldLines,包含多行)。
- 在内层循环中,我们检查 contentLines[i+j] 是否与 oldLines[j] 每一行都对应相等。
- 只要中间有任何一行不匹配,isMatch 就会变为 false 并 break 结束内层循环。
- 只有当内层循环顺利跑完,意味着连续的 len(oldLines) 行全部匹配成功,我们才会认为找到了一个合法的代码块,并将 matchCount++。
如果最终 matchCount > 1,说明这个多行代码块在文件中出现了不止一次(比如两个同名的初始化函数),引擎会安全报错并拒绝替换。
麦耀锋: 我觉得缩进这个问题挺复杂的,目前并没有好的思路能解决所有问题,举两个例子:
例子1:oldText中本身就有问题,比如本身的缩进就有问题,那么你以oldText的基础缩进前缀就没有任何参考意义
例子2:将下面: if a < 5 { b = 2 c= 4 }
改为: if a < 5 { b = 2 }
实际上大模型有可能会告知这个:
oldText = '
在这种情况下,实际上缩进是不需要特殊处理,因为两者的“第一行”不是同一个概念。
作者回复: 👍
Tan: 当实现了edit工具后,我把main.go的prompt改成:“逐行模糊匹配(lineByLineReplace)算法中,虽然我们成功去除了首尾空格的干扰找到了匹配块,但在进行文本替换时,我们采用了一个极其粗暴的做法:直接将原有的那几行删掉,塞入未经任何处理的 newText。这会带来一个小问题:如果目标代码块是在一个嵌套极深的函数中(比如前面有 12 个空格的缩进),而大模型输出的 newText 只有 4 个空格的缩进,替换完之后,这部分代码的格式就会显得非常难看。结合你对字符串处理的经验,如果在匹配到目标行的同时,我们要提取出目标行原来的“基础缩进前缀(Base Indentation)”,并将其自动补齐到 newText 的每一行前面,你会如何在现有的 lineByLineReplace 中进行代码优化?”
AI就帮我把代码优化好了
Vongola: 如果是批量修改,计算 count 是不是就不行了