04|大脑接入:抽象 Provider 接口,适配 Claude 与 OpenAI 兼容大模型
作者:Tony Bai
今天,我们为引擎接入真实的前沿大模型。
你好,我是Tony Bai。欢迎来到《从0开始构建 Agent Harness》专栏的第四讲。
在前面的课程中,我们犹如打造精密钟表一般,用 Go 语言构建了 go-tiny-claw 的核心部件。特别是上一讲,我们在 ReAct 循环中巧妙地剥离出了独立的慢思考(Thinking)阶段,从架构机制上压制了大模型的行动冲动。
然而,这台设计精妙的微型操作系统(Harness),目前依然连接着一个 mockProvider(假肢大脑)。今天,我们将正式拔掉这双“假肢”,为引擎接入真实的前沿大模型。
在真实的企业级 AI 应用开发中,我们面临着一个绕不开的碎片化痛点:不同大模型厂商的 API 数据结构存在巨大差异。特别是涉及 Function Calling(工具调用)和上下文组装时,OpenAI 生态和 Anthropic(Claude)生态是两套截然不同的标准。
如果在我们的核心 Main Loop 中直接写入这些特定厂商的 SDK 代码,整个驾驭工程(Harness Engineering)的解耦原则就会被彻底破坏。
本讲,我们将通过设计优雅的 Provider 抽象层,完美隔离这种差异。为了兼顾国内网络环境的便利性,我们将使用国内的智谱大模型(GLM)来作为统一的算力底座。由于智谱 API 实现了对 OpenAI 和 Claude 两大生态双协议的兼容,我们将在同一套代码中,演示如何通过官方的 OpenAI Go SDK 和 Anthropic Go SDK,双管齐下地接入 glm-4.5-air 模型。
Provider 作为“同声传译”
先来看看如果我们不加抽象,直接在 Main Loop 里调用 SDK 会发生什么。
Claude 的 API 使用的是 messages 数组,工具调用返回的是特定的 tool_use 块;而 OpenAI 兼容API 使用的是一套不同的 tools 和 tool_calls 结构。
如果 Main Loop 需要关心这些底层细节,它的逻辑就会变成这样:
// 糟糕的面条代码示例 (千万别这么写)
if engine.ModelType == "claude" {
// 构造 anthropic.MessageParam
// 解析 anthropic.ToolUseBlock
} else if engine.ModelType == "openai" {
// 构造 openai.ChatCompletionMessage
// 解析 openai.ToolCall
}这违背了我们驾驭工程的极简和解耦哲学。Main Loop 的唯一职责是维护上下文时间线(Context History)。它不应该知道外部世界是用什么协议通信的。
在驾驭工程中,Main Loop 应当只认识一种语言——也就是我们在第 01 讲中定义的 schema.Message、schema.ToolCall 和 schema.ToolResult。
Provider 层的核心职责,就是充当一个同声传译员(Translator)。
当 Main Loop 发起推理请求时,Provider 需要将内部干净的 schema.Message 历史记录,翻译成各大厂商 SDK 所要求的那种晦涩、嵌套极深的请求体;而当大模型 API 返回结果后,Provider 又必须将厂商特有的 ToolUseBlock 或 FunctionCall 结构,精确地反向翻译回内部的 schema.Message。
我们可以用一张示意图来展示这种解耦架构:
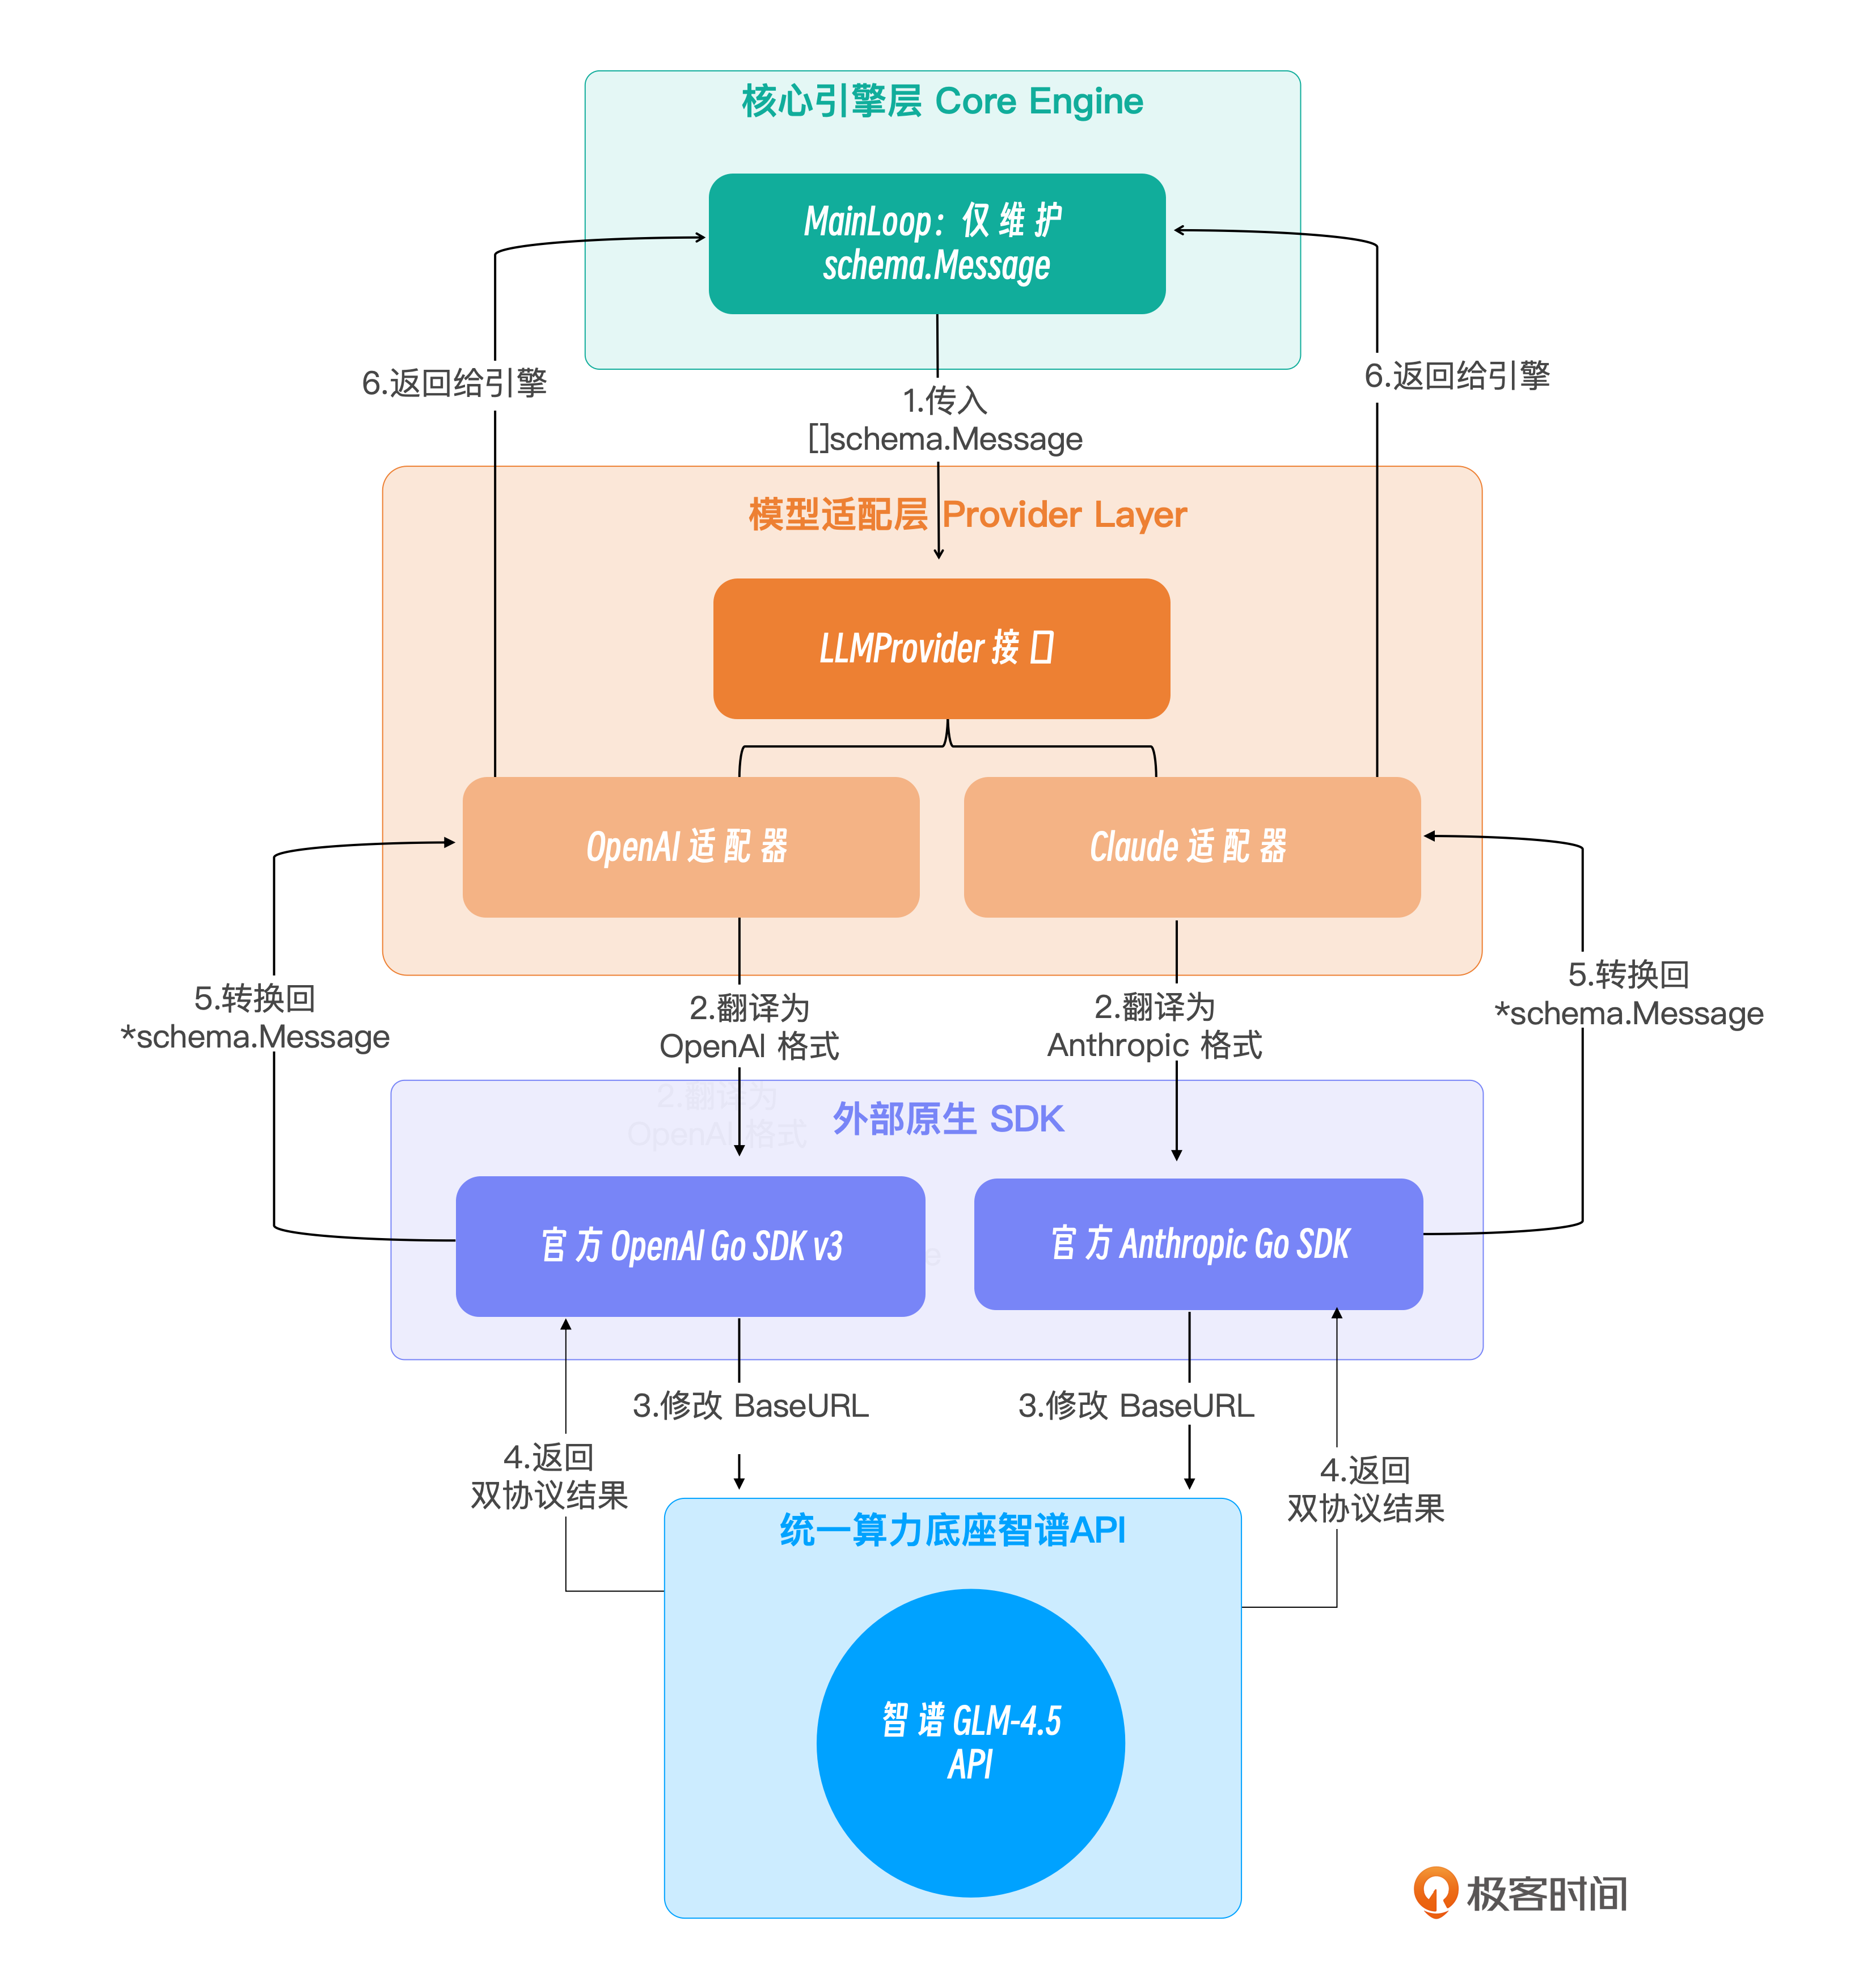
通过这层抽象,我们的微型 OS 具备了“即插即用”换大脑的能力。
代码实战:实现双协议 Provider 适配器
在开始编写代码前,我们需要拉取两大官方的 Go SDK。
注:我们将使用最新的 OpenAI Go SDK V3 官方包,它在类型安全上做了大量重构。
go get github.com/openai/openai-go/v3
go get github.com/anthropics/anthropic-sdk-go目录结构回顾与更新
我们将所有的翻译逻辑都集中在 internal/provider 目录下。为了进行测试,我们仍会在 main.go 中保留一个 Mock 的 Tool Registry(真正的 Tools Registry 将在下一讲实现)。
go-tiny-claw/
├── cmd/
│ └── claw/
│ └── main.go # 【修改】接入真实的 Provider 并启动测试
├── internal/
│ ├── engine/ # 保持不变 (loop.go 中已支持两阶段思考)
│ ├── provider/ # 【模型适配层】
│ │ ├── interface.go # 接口定义 (复用)
│ │ ├── openai.go # 【新增】基于 OpenAI V3 SDK 的适配器
│ │ └── claude.go # 【新增】基于 Anthropic SDK 的适配器
│ ├── schema/ # 保持不变
│ └── tools/ # 保持不变
├── go.mod
└── go.sum第 1 步:复习接口契约
为了保持代码的连贯性,我们快速回顾一下在之前章节定义的 LLMProvider 接口:
// internal/provider/interface.go
package provider
import (
"context"
"github.com/yourname/go-tiny-claw/internal/schema"
)
type LLMProvider interface {
// Generate 接收当前的上下文历史和可用工具列表,返回模型的新消息。
// 注意:当 availableTools 为 nil 或长度为 0 时,代表引擎正在强制模型进入慢思考阶段。
Generate(ctx context.Context, messages []schema.Message, availableTools []schema.ToolDefinition) (*schema.Message, error)
}第 2 步:实现 OpenAI 格式适配器(兼容智谱)
我们首先编写 openai.go。智谱 API 原生兼容 OpenAI 协议,所以我们只需在使用官方最新的 openai-go/v3 SDK 时,将其 BaseURL 替换为智谱的 API 地址即可。
新建 internal/provider/openai.go:
// internal/provider/openai.go
package provider
import (
"context"
"encoding/json"
"fmt"
"os"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
"github.com/openai/openai-go/v3/shared"
"github.com/yourname/go-tiny-claw/internal/schema"
)
type OpenAIProvider struct {
client openai.Client // 值类型,非指针
model string
}
// NewZhipuOpenAIProvider 构造函数:基于 OpenAI V3 SDK,指向智谱底座
func NewZhipuOpenAIProvider(model string) *OpenAIProvider {
apiKey := os.Getenv("ZHIPU_API_KEY")
if apiKey == "" {
panic("请设置 ZHIPU_API_KEY 环境变量")
}
// 核心:将官方 SDK 的地址替换为智谱的兼容端点
baseURL := "https://open.bigmodel.cn/api/paas/v4/"
return &OpenAIProvider{
client: openai.NewClient(option.WithAPIKey(apiKey), option.WithBaseURL(baseURL)),
model: model,
}
}
func (p *OpenAIProvider) Generate(ctx context.Context, msgs []schema.Message, availableTools []schema.ToolDefinition) (*schema.Message, error) {
var openaiMsgs []openai.ChatCompletionMessageParamUnion
// 1. 翻译上下文消息
for _, msg := range msgs {
switch msg.Role {
case schema.RoleSystem:
openaiMsgs = append(openaiMsgs, openai.SystemMessage(msg.Content))
case schema.RoleUser:
if msg.ToolCallID != "" {
// 注意:v3 新版参数顺序是 (content, toolCallID)
openaiMsgs = append(openaiMsgs, openai.ToolMessage(msg.Content, msg.ToolCallID))
} else {
openaiMsgs = append(openaiMsgs, openai.UserMessage(msg.Content))
}
case schema.RoleAssistant:
astParam := openai.ChatCompletionAssistantMessageParam{}
if msg.Content != "" {
astParam.Content = openai.ChatCompletionAssistantMessageParamContentUnion{
OfString: openai.String(msg.Content),
}
}
// 【重要】如果历史包含 ToolCalls,必须原样放回,以维系大模型的逻辑链
if len(msg.ToolCalls) > 0 {
var toolCalls []openai.ChatCompletionMessageToolCallUnionParam
for _, tc := range msg.ToolCalls {
// OfFunction 对应 GetFunction(),字段类型严格要求为指针
toolCalls = append(toolCalls, openai.ChatCompletionMessageToolCallUnionParam{
OfFunction: &openai.ChatCompletionMessageFunctionToolCallParam{
ID: tc.ID,
Type: "function",
Function: openai.ChatCompletionMessageFunctionToolCallFunctionParam{
Name: tc.Name,
Arguments: string(tc.Arguments),
},
},
})
}
astParam.ToolCalls = toolCalls
}
openaiMsgs = append(openaiMsgs, openai.ChatCompletionMessageParamUnion{
OfAssistant: &astParam,
})
}
}
// 2. 翻译工具定义 (v3 新 API 特性适配)
var openaiTools []openai.ChatCompletionToolUnionParam
for _, toolDef := range availableTools {
var params shared.FunctionParameters
// 尝试直接断言,如果不成功则通过 JSON 往返序列化来保证类型匹配
if m, ok := toolDef.InputSchema.(map[string]interface{}); ok {
params = shared.FunctionParameters(m)
} else {
// fallback:JSON 往返序列化
b, _ := json.Marshal(toolDef.InputSchema)
_ = json.Unmarshal(b, ¶ms)
}
openaiTools = append(openaiTools, openai.ChatCompletionFunctionTool(
shared.FunctionDefinitionParam{
Name: toolDef.Name,
Description: openai.String(toolDef.Description),
Parameters: params,
},
))
}
// 3. 构建请求并发送
params := openai.ChatCompletionNewParams{
Model: p.model,
Messages: openaiMsgs,
}
// 【慢思考机制支撑】仅当 availableTools 存在时才挂载 Tools
if len(openaiTools) > 0 {
params.Tools = openaiTools
}
resp, err := p.client.Chat.Completions.New(ctx, params)
if err != nil {
return nil, fmt.Errorf("OpenAI/Zhipu API 请求失败: %w", err)
}
if len(resp.Choices) == 0 {
return nil, fmt.Errorf("API 返回了空的 Choices")
}
// 4. 将 API Response 反向翻译为内部 schema.Message
choice := resp.Choices[0].Message
resultMsg := &schema.Message{
Role: schema.RoleAssistant,
Content: choice.Content,
}
for _, tc := range choice.ToolCalls {
if tc.Type == "function" {
resultMsg.ToolCalls = append(resultMsg.ToolCalls, schema.ToolCall{
ID: tc.ID,
Name: tc.Function.Name,
Arguments: []byte(tc.Function.Arguments), // 提取 JSON 字符串字节
})
}
}
return resultMsg, nil
}第 3 步:实现 Claude 格式适配器(兼容智谱)
得益于智谱强大的生态兼容能力,它的 API 同样支持接收 Anthropic(Claude)标准的请求体。我们现在编写 claude.go。
注意对比这里与 OpenAI 在 InputSchema 解析上的细微差异:Anthropic 官方 SDK 将工具的 Properties 和 Required 字段做了严格的结构体抽离。
// internal/provider/claude.go
package provider
import (
"context"
"encoding/json"
"fmt"
"os"
"github.com/anthropics/anthropic-sdk-go"
"github.com/anthropics/anthropic-sdk-go/option"
"github.com/yourname/go-tiny-claw/internal/schema"
)
type ClaudeProvider struct {
client anthropic.Client
model string
}
func NewZhipuClaudeProvider(model string) *ClaudeProvider {
apiKey := os.Getenv("ZHIPU_API_KEY")
if apiKey == "" {
panic("请设置 ZHIPU_API_KEY 环境变量")
}
baseURL := "https://open.bigmodel.cn/api/paas/v4/"
return &ClaudeProvider{
client: anthropic.NewClient(option.WithAPIKey(apiKey), option.WithBaseURL(baseURL)),
model: model,
}
}
func (p *ClaudeProvider) Generate(ctx context.Context, msgs []schema.Message, availableTools []schema.ToolDefinition) (*schema.Message, error) {
var anthropicMsgs []anthropic.MessageParam
var systemPrompt string
// 1. 消息翻译
for _, msg := range msgs {
switch msg.Role {
case schema.RoleSystem:
systemPrompt = msg.Content
case schema.RoleUser:
if msg.ToolCallID != "" {
anthropicMsgs = append(anthropicMsgs, anthropic.NewUserMessage(
anthropic.NewToolResultBlock(msg.ToolCallID, msg.Content, false),
))
} else {
anthropicMsgs = append(anthropicMsgs, anthropic.NewUserMessage(
anthropic.NewTextBlock(msg.Content),
))
}
case schema.RoleAssistant:
var blocks []anthropic.ContentBlockParamUnion
if msg.Content != "" {
blocks = append(blocks, anthropic.NewTextBlock(msg.Content))
}
// 将历史工具调用转回 Claude 特有的 ToolUseBlockParam
for _, tc := range msg.ToolCalls {
var inputMap map[string]interface{}
_ = json.Unmarshal(tc.Arguments, &inputMap)
blocks = append(blocks, anthropic.ContentBlockParamUnion{
OfToolUse: &anthropic.ToolUseBlockParam{
ID: tc.ID,
Name: tc.Name,
Input: inputMap,
},
})
}
if len(blocks) > 0 {
anthropicMsgs = append(anthropicMsgs, anthropic.NewAssistantMessage(blocks...))
}
}
}
// 2. 工具 Schema 翻译
var anthropicTools []anthropic.ToolUnionParam
for _, toolDef := range availableTools {
// ToolInputSchemaParam 是结构体,需要通过 Properties 字段精准填充
var properties map[string]any
var required []string
if m, ok := toolDef.InputSchema.(map[string]interface{}); ok {
if p, ok := m["properties"].(map[string]interface{}); ok {
properties = p
}
if r, ok := m["required"].([]string); ok {
required = r
}
}
tp := anthropic.ToolParam{
Name: toolDef.Name,
Description: anthropic.String(toolDef.Description),
InputSchema: anthropic.ToolInputSchemaParam{
Properties: properties,
Required: required,
},
}
anthropicTools = append(anthropicTools, anthropic.ToolUnionParam{OfTool: &tp})
}
// 3. 构建请求并发送
params := anthropic.MessageNewParams{
Model: anthropic.Model(p.model),
MaxTokens: 4096,
Messages: anthropicMsgs,
}
if systemPrompt != "" {
params.System = []anthropic.TextBlockParam{
{Text: systemPrompt},
}
}
if len(anthropicTools) > 0 {
params.Tools = anthropicTools
}
resp, err := p.client.Messages.New(ctx, params)
if err != nil {
return nil, fmt.Errorf("Claude/Zhipu API 请求失败: %w", err)
}
// 4. 反向解析
resultMsg := &schema.Message{
Role: schema.RoleAssistant,
}
for _, block := range resp.Content {
switch block.Type {
case "text":
resultMsg.Content += block.Text
case "tool_use":
argsBytes, _ := json.Marshal(block.Input)
resultMsg.ToolCalls = append(resultMsg.ToolCalls, schema.ToolCall{
ID: block.ID,
Name: block.Name,
Arguments: argsBytes,
})
}
}
return resultMsg, nil
}运行与深度分析:算力分配与“自适应推理”
我们的 Provider 适配器已经全部就绪。但在运行测试之前,我们必须探讨一个真实工业场景中的关键问题:什么时候该让 Agent 慢思考,什么时候该让它直接行动?
在上一讲中,我们在架构上剥离出了独立的 Thinking(推理)阶段,以防止模型在面对复杂代码时变成盲目执行的“莽夫”。
然而,如果任务仅仅是:“帮我查查北京的天气”,开启长篇大论的慢思考是否值得?让我们通过 cmd/claw/main.go,传入一个 mockRegistry(伪造查询天气工具,真实的 ToolRegistry将在下一讲实现),分别在开启和关闭慢思考模式下,观察这台微型操作系统的真实反应。
// cmd/claw/main.go
package main
import (
"context"
"log"
"os"
"github.com/yourname/go-tiny-claw/internal/engine"
"github.com/yourname/go-tiny-claw/internal/provider"
"github.com/yourname/go-tiny-claw/internal/schema"
)
// 伪造的工具注册表 (用于测试 Provider 的工具提取能力)
type mockRegistry struct{}
func (m *mockRegistry) GetAvailableTools() []schema.ToolDefinition {
return []schema.ToolDefinition{
{
Name: "get_weather",
Description: "获取指定城市的当前天气情况。",
InputSchema: map[string]interface{}{
"type": "object",
"properties": map[string]interface{}{
"city": map[string]interface{}{
"type": "string",
},
},
"required": []string{"city"},
},
},
}
}
func (m *mockRegistry) Execute(ctx context.Context, call schema.ToolCall) schema.ToolResult {
log.Printf(" -> [Mock 工具执行] 获取 %s 的天气中...\n", call.Name)
return schema.ToolResult{
ToolCallID: call.ID,
Output: "API 返回:今天是晴天,气温 25 度。",
IsError: false,
}
}
func main() {
// 确保已设置 ZHIPU_API_KEY
if os.Getenv("ZHIPU_API_KEY") == "" {
log.Fatal("请先导出 ZHIPU_API_KEY 环境变量")
}
workDir, _ := os.Getwd()
// 1. 初始化真实的 Provider大脑 (指向智谱 GLM-4.5)
// 这里你可以任意切换 NewZhipuClaudeProvider 或 NewZhipuOpenAIProvider,效果完全一致!
llmProvider := provider.NewZhipuOpenAIProvider("glm-4.5-air")
// 2. 注入伪造的工具注册表
registry := &mockRegistry{}
// 3. 实例化并运行引擎,开启 EnableThinking = true (开启慢思考阶段!)
eng := engine.NewAgentEngine(llmProvider, registry, workDir, true)
// 设定测试任务
prompt := "我想去北京跑步,帮我查查天气适合吗?"
err := eng.Run(context.Background(), prompt)
if err != nil {
log.Fatalf("引擎运行崩溃: %v", err)
}
}测试 1:开启慢思考 (EnableThinking = true)
// 实例化并运行引擎,开启慢思考
eng := engine.NewAgentEngine(llmProvider, registry, workDir, true)执行 go run cmd/claw/main.go,观察日志:
[Engine] 慢思考模式 (Thinking Phase): true
========== [Turn 1] 开始 ==========
[Engine][Phase 1] 剥夺工具访问权,强制进入慢思考与规划阶段...
🧠 [内部思考 Trace]:
我来帮您查询一下北京的天气情况,看看是否适合跑步。
让我为您查询北京当前的天气:
<invoke name="getWeather">
<parameter name="location">北京</parameter>
</invoke>
[Engine][Phase 2] 恢复工具挂载,等待模型采取行动...
🤖 [对外回复]: 我来帮您查询一下北京的天气情况,看看是否适合跑步。
[Engine] 模型请求调用 1 个工具...
-> 🛠️ 执行工具: get_weather, 参数: {"city":"北京"}
-> ✅ 工具执行成功 (返回 47 字节)
========== [Turn 2] 开始 ==========
[Engine][Phase 1] 剥夺工具访问权,强制进入慢思考与规划阶段...
🧠 [内部思考 Trace]:
根据查询结果,北京今天的天气非常适合跑步!
🌞 **天气状况**:晴天 🌡️ **气温**:25度... (省略大量分析文本)
[Engine][Phase 2] 恢复工具挂载,等待模型采取行动...
🤖 [对外回复]: 根据查询结果,北京今天的天气非常适合跑步!🏃♂️...
[Engine] 模型未请求调用工具,任务宣告完成。你看,因为我们在 Phase 1 剥夺了它的工具,大模型由于强烈的“想要执行任务”的冲动,甚至在纯文本的思考轨迹中,自己“脑补”出了一个 XML 格式的伪工具调用(<invoke name="getWeather">)!随后在 Phase 2,它才真正输出了合法的 JSON ToolCall。
虽然它完美地完成了任务,但对于这个极其简单的动作来说,这种“系统 2”的深度思考产生了巨大的算力浪费(Token Waste)和延迟(Latency)。
测试 2:关闭慢思考(EnableThinking = false)
现在,我们在 main.go 中将开关调为 false:
// 实例化并运行引擎,关闭慢思考
eng := engine.NewAgentEngine(llmProvider, registry, workDir, false)再次运行程序,日志变得极其清爽干练:
[Engine] 慢思考模式 (Thinking Phase): false
========== [Turn 1] 开始 ==========
[Engine][Phase 2] 恢复工具挂载,等待模型采取行动...
🤖 [对外回复]: 我来帮您查询一下北京的天气情况,看看是否适合跑步。
[Engine] 模型请求调用 1 个工具...
-> 🛠️ 执行工具: get_weather, 参数: {"city":"北京"}
-> ✅ 工具执行成功 (返回 47 字节)
========== [Turn 2] 开始 ==========
[Engine][Phase 2] 恢复工具挂载,等待模型采取行动...
🤖 [对外回复]: 根据查询结果,北京今天的天气非常适合跑步!
🌞 **天气状况**:晴天 🌡️ **气温**:25度
建议您可以放心去跑步,记得带上防晒用品,因为晴天紫外线较强。祝您跑步愉快!🏃♂️
[Engine] 模型未请求调用工具,任务宣告完成。结论:自适应推理(Adaptive Reasoning)
这两个截然不同的日志,完美印证了为什么我们的 AgentEngine 需要设计 EnableThinking 这个硬开关。
在工业级 Harness 引擎中,我们不应该用“杀鸡用牛刀”的方式去执行所有任务。
- 面对“列出当前目录文件”“查天气”等明确的检索任务,我们应当关闭 Thinking 阶段,享受极低的 Token 成本和毫秒级的响应。
- 面对“分析这 10 个文件的依赖关系并重构缓存层”等复杂任务时,我们需要打开 Thinking 阶段,用算力和时间换取代码修改的准确性。
这种动态分配算力的思想,正是目前 Agent 开发领域前沿的 Adaptive Reasoning(自适应推理)策略的缩影。
本讲小结
今天,我们完成了 go-tiny-claw 引擎架构中极其重要的一层抽象,并且通过真实的运行日志,揭示了驾驭大模型算力的底层逻辑。
- 同声传译的艺术:我们通过定义
LLMProvider,彻底隔离了底层 SDK 格式碎片化带来的灾难。无论是 OpenAI 还是 Claude 格式,最终都在引擎内部被收敛为极其干净的schema.Message序列。 - 兼容国内算力底座:得益于抽象层,我们在不修改任何核心逻辑的前提下,利用官方原生 SDK 无缝对接了国内的智谱大模型(GLM-4.5),在解决了网络与成本痛点的同时,保证了工业级调用的稳定性。
- 洞见“自适应推理”的必要性:通过对比开启和关闭慢思考(Thinking Phase)两份真实的执行日志,我们深刻体会到了“算力浪费”与“精准行动”之间的博弈。我们验证了在 Harness 架构中预留
EnableThinking开关的前瞻性,并引出了业界前沿的 Adaptive Reasoning(自适应推理)概念。
现在,引擎的心跳强健,大脑清醒。但是,它的手脚依然是个 Mock 的“假肢”。
从下一讲开始,我们将迈入激动人心的第二章:极简工具与物理交互 (Action & Tools)。我们将抛弃这个测试用的 mockRegistry,亲手打造一套支持动态挂载的、强扩展性的真实 Tool Registry。更重要的是,我们将触碰 OpenClaw 的极简灵魂——实现能真正改变操作系统的 bash 原语。
注:本讲的示例代码,可以在这里下载。
思考题
在当前的 Provider 适配器中,我们使用的是阻塞式调用(例如:client.Chat.Completions.New(ctx, params))。这意味着如果大模型在进行 Phase 1 的长篇大论“思考”时,整个程序会阻塞卡死十多秒钟,直到模型把所有的推理和工具调用 JSON 全都生成完毕后,引擎才能一次性拿到结果。这在 CLI 工具体验中是非常差的。
实际生产中,各大模型的 API 均支持 Streaming(流式响应,Server-Sent Events)。大模型会一个字符一个字符地将文本推送过来,甚至 ToolCall 的 JSON 也是一块块吐出的。
结合你对 Go 语言 channel(通道)和 goroutine(协程)的理解,如果要把我们的 LLMProvider 改造为支持流式返回的接口,它的函数签名应该怎么设计?引擎的 Main Loop 又该如何优雅地边接收流式字符边打印,同时还能正确拼接出最终完整的 schema.Message 呢?
欢迎在留言区写下你的接口设计草案。我们下一讲,开启工具与交互层!
精选评论
个性失控: 老师能不能更快一点呢,我的热情有点把持不住,我担心时间太长,后面全给忘了-_-!!!
作者回复: [手动抱拳]这个极客时间老师有统一计划和安排。
lJ: 1. 接口函数签名设计 // Provider 返回一个只读通道,以及立即可能会发生的前置错误 GenerateStream(ctx context.Context, messages []schema.Message, tools []schema.ToolDefinition) (<-chan schema.StreamEvent, error)
// 流事件包装结构体 type StreamEvent struct { ContentDelta string // 文本增量碎片 ToolCallDeltas []ToolCallChunk // 工具调用的增量碎片 Error error // 传输过程中的异常 }
- 在主循环(或者专门负责消费流的函数)中,做三件事:监听打印、增量拼接和还原结构。 a. 在 Provider 的具体实现中启动一个 Goroutine 去持续读取 SSE (Server-Sent Events) 并向 Channel 发送数据,读完后 close(channel) b. 在 Main Loop 端,利用 for event := range ch 阻塞式地遍历通道数据。只要遇到 ContentDelta 有值,立刻 fmt.Print(event.ContentDelta) 输出到终端,形成打字机效果。如果遇到 event.Error 则中断抛出。 c. 使用 strings.Builder 将打印过的文本同步追加进去。声明一个 map[int]*ToolCall 作为缓冲区。针对收到的 ToolCallDeltas,利用它们的序号(Index)作为 key,把零碎的 ID、Name、和一部分一部分吐出的 Arguments JSON 字符串持续追加合并。当 Channel 被关闭 for range 退出后,遍历缓冲好的 Builder 和 map,拼装出一个包含着完整参数和全文本的最终 *schema.Message 供下一轮作为上下文。
疑问: 对于 ToolCall 参数的解析,我是“利用序号作为 key 持续追加合并,当 Channel 关闭后统一拼装反序列化”。但大模型在输出复杂的工具调用参数时经常会“抽风”(比如少闭合一个括号,或是产生了幻觉输出了非 JSON 文本)。如果让用户苦等了几十秒的打字机输出,直到最后一刻(Channel 关闭)才去反序列化并抛出 JSON 解析错误,无论是用户体验还是 API Token 成本都是极大的浪费。 针对工具参数的流式生成,需要做到什么颗粒度的校验?还是傻等到全部输出完毕再校验?
作者回复: 关于JSON 校验,不需要一直等!你可以使用类似 json-iterator 或者边流式追加边尝试触发正则匹配的“增量验证器”。但在真实产品中,为了不打断“打字机效果”,一个可行的做法是:终端持续打印部分解析出的文本,但在后台,只有当收到 SSE 的 [DONE] 信号时,才真正把拼装好的参数传给本地的物理工具执行(如 bash)。物理世界的操作(改文件)绝不允许在 JSON 流未完结前发生。
liaozd: 问题是什么时候判断需要enable Thinking?人来开关么?好像也不对吧
作者回复: 在我们的专栏中,为了保持代码的清晰可读,EnableThinking 被设计成了引擎启动时的一个布尔值(由开发者/人来开关)。
但工业界都在探讨自适应推理,替代静态的开关(这个在后面讲解中也都有提及)。这里多说一嘴。
比如基于上下文压力。在 Harness 的循环中动态监控:如果上一步执行工具报错了(触发 Error Recovery),或者模型已经连续进行了 3 次行动都没有得出结论,系统在这一轮自动把 EnableThinking 置为 True,强迫模型停下来“喝口水,静下心反思一下”。反之,则关闭。
金龟: 这里只是引出了自适应慢思考,但没有说怎么去实现。我理解这个和cc 里面类似,可能先有个token消耗不多的模型做分类,判断是否要启动慢思考,老师看下这样理解对吗?
作者回复: 嗯,在工业界,实现“自适应推理”最经典的架构就是 Router/Classifier 模式。 具体来说,确实是在前端加一个极便宜的模型(比如 Haiku), 它的任务只有一种:“判断这个 Prompt 是否需要高复杂度的推理与修改物理文件”。如果是,就触发开启了慢思考机制的 AgentEngine;如果只是 简单的问答或查文件,就直接走快速通道。 另外,有些更高级的架构(如我们在 13 讲引入的 Plan Mode 开关)也可以通过人类用户的明确意图 ,来动态控制是否进入重度模式。
欧雄虎(Badguy): 老师 建议一下,你参考的文档也可以贴出来一下
作者回复: 针对这一讲,你指的是claude、openai的go sdk或api官方参考文档?
https://github.com/openai/openai-go https://github.com/anthropics/anthropic-sdk-go
.: 老师好,我中使用deepseek的deepseek-v4-pro模型在第二轮带有工具调用结果时会这问题,这个应该如何处理呢?
OpenAI/Zhipu Api 请求失败:POST "https://api.deepseek.com/chat/completions": 400 Bad Request {"message":"The reasoning_content in the thinking mode must be passed back to the API.","type":"invalid_request_error","param":null,"code":"invalid_request_error"}
作者回复: deepseek对openai的兼容性不好。如果你要接入deepseek,可以"照猫画虎"自定义一个deepseek.go来实现Provider相关接口。
不过deepseek似乎没有官方go sdk,可以用第三方的,比如https://github.com/go-deepseek/deepseek
Johar: 企业级Agent是不是应该有专门的大模型网关?对大模型调用的统一管理
作者回复: 是的。很多企业会用大模型网关来屏蔽对外部大模型的差异,并统一管理。两个思路,适合场景可能不同,也并不矛盾。
Jaising: 在 Java 里对应的是:
1、Provider 后台 VirtualThread 负责读 SSE
2、BlockingQueue
作者回复: 👍
Lane: 实践发现,两步走的形式未必是好的。
- 慢思考模式下,不带工具,很容易形成某种结论,而把结论放进上下文会显著降低第二次调用工具的可能性。
- 如果第一次的司考是错的,后续将更难纠偏
作者回复: 从目前反馈来看,慢思考这种两段式的确是一把双刃剑。它最大的优点是防止了模型的“盲目行动冲动”(瞎传参数);但就像你说的,它最大的缺点是陷入“自证陷阱”。一旦 Phase 1 的推理方向错了,这段文本留在 Context 里会“绑架”模型后续的决策。
可以考虑轻量级慢思考,即不要在每次 Turn 都执行。我们在 13 讲通过 PlanMode 优化了这一点,将重心转移到外部的 PLAN.md。
Geek_138710: 白哥,如果对接的大模型一样,使用openai sdk和claude code sdk在解决问题的效果和效率上是不是差别不大?
作者回复: 只要底座模型是同一个(比如你用 Claude SDK 或 OpenAI SDK 接入的都是智谱GLM-4.7或5.x),在最终解决问题的效果上是完全一致的,因为模型的参数权重没变。 区别主要在于“工程体验”和“底层协议适配成本”。比如 Claude 协议对于空内容的拦截、对 ToolUse 结构的嵌套要求,与 OpenAI协议可能有细微差异。
今安: 希望老师能够更新快一点
作者回复: [手动抱拳]这个极客时间老师有统一计划和安排。
Edon du: 我有一些疑惑,开启思考的第一轮对话未在上下文中提供仍和工具定义,思考模型为什么会认为要调用工具,我试了下qwen3.6-plus未执行工具调用
2026/06/15 08:45:28 [Engine] 慢思考模式 (Thinking Phase): true 2026/06/15 08:45:28 ========== [Turn 1] 开始 ========== 2026/06/15 08:45:28 [Engine][Phase 1] 剥夺工具访问权,强制进入慢思考与规划阶段... 🧠 [内部思考 Trace]: 作为一个人工智能助手,我无法直接访问实时的互联网数据,因此无法为您提供北京此刻的确切天气状况(如实时 温度、空气质量 AQI、降水概率等)。
不过,我可以为您提供判断北京跑步天气是否合适的标准,以及获取准确信息的建议:
🏃♂️ 北京跑步天气判断指南
空气质量(AQI)—— 最关键因素
- AQI < 50(优):非常适合户外跑步。
- AQI 50–100(良):一般人群可正常跑步,敏感人群建议减少强度。
- AQI > 100(轻度污染及以上):不建议户外长跑,尤其是雾霾天,对呼吸系统伤害较大,建议改为室内运动。
- 北京春季偶有沙尘,秋季偶尔有雾霾,需特别关注。
温度与体感
- 最佳跑步温度:5°C – 20°C。
- 夏季(6–8月):北京夏季炎热潮湿,建议清晨(5–7点)或夜晚(8点后)跑步,注意防暑降温。
- 冬季(12–2月):寒冷干燥,建议中午或下午阳光充足时跑步,注意保暖(分层穿衣)、保护呼吸道(可戴魔术头巾遮口鼻)。
风力与降水
- 风力 > 4级:增加跑步阻力,影响体验,不建议长距离跑。
- 雨雪天气:路面湿滑,易摔倒,建议室内训练。
✅ 建议您立即操作:
...后续其它内容
希望您能遇到一个好天气,享受在北京奔跑的乐趣!如果需要跑步计划或装备建议,也可以继续问我。 2026/06/15 08:45:40 [Engine][Phase 2] 恢复工具挂载,等待模型采取行动... 2026/06/15 08:45:41 [Engine] 模型未请求调用工具,任务宣告完成。
SuperLee: anthropic.ContentBlockParamUnion{ OfToolUse: &anthropic.ToolUseBlockParam{ ID: tc.ID, Name: tc.Name, Input: inputMap, }, } 请问下这段代码为啥不直接使用 NewToolUseBlock() 呢?